





php查询mysql数据出现重复记录,通常是因为sql语句未使用distinct或group by去重,或者join操作导致笛卡尔积膨胀。解决方向是直接在数据库层过滤重复项,而非在php层处理。适用条件是数据量适中,且重复逻辑可由sql聚合函数表达。若需保留特定字段(如最新时间),需配合子查询或窗口函数。
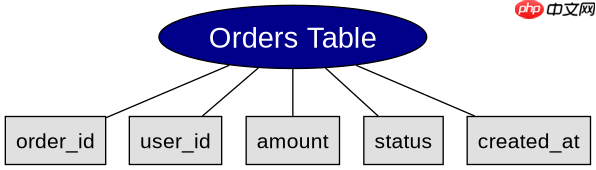
基础去重与分组策略
当表结构允许直接通过主键或唯一索引识别重复时,使用SELECT DISTINCT是最简单的方案。如果需要根据非唯一字段分组并取聚合值,则使用GROUP BY。以下代码演示了如何查询用户订单,去除完全相同的行。

<?php
$host = '127.0.0.1';
$db   = 'test_db';
$user = 'root';
$pass = 'password';
$charset = 'utf8mb4';

$dsn = "mysql:host=$host;dbname=$db;charset=$charset";
$options = [
    PDO::ATTR_ERRMODE            => PDO::ERRMODE_EXCEPTION,
    PDO::ATTR_DEFAULT_FETCH_MODE => PDO::FETCH_ASSOC,
    PDO::ATTR_EMULATE_PREPARES   => false,
];

try {
    $pdo = new PDO($dsn, $user, $pass, $options);

    // 示例:查询订单表,去除完全重复的记录
    $sql = "SELECT DISTINCT order_id, user_id, amount FROM orders WHERE status = 'paid'";
    $stmt = $pdo->query($sql);
    $results = $stmt->fetchAll();

    foreach ($results as $row) {
        echo sprintf("Order: %s, User: %s, Amount: %.2f\n",
            $row['order_id'], $row['user_id'], $row['amount']);
    }
} catch (PDOException $e) {
    error_log($e->getMessage());
    die("Database connection failed");
}
?>
执行上述代码后,输出结果中不会出现两行完全一致的order_id、user_id和amount组合。如果数据库中存在多条相同业务数据的冗余记录,DISTINCT会将其合并为一行。若发现结果仍多于预期,检查是否因浮点数精度或NULL值差异导致distinct失效。
立即学习“PHP免费学习笔记(深入)”;

面向 CRM 系统的 MySQL 8 数据库模式设计。当用户需要为客户关系管理(CRM)系统设计、评审、优化或生成数据库模式时,应使用此项技能。
复杂关联下的去重分支
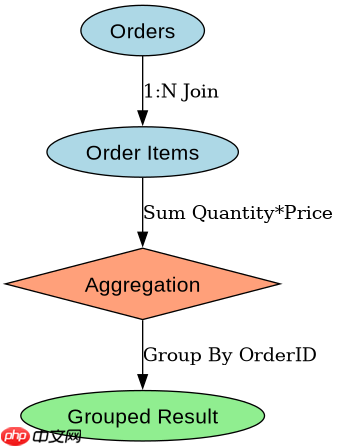
当涉及多表JOIN时,即使源表无重复,连接也可能产生重复行。此时DISTINCT可能性能较差,应改用GROUP BY配合聚合函数,或使用子查询先筛选ID再连接。关键分支在于判断是否需要保留关联表的多个字段。若只需主表信息,应先对主表去重再JOIN。
<?php
// 假设orders表与order_items表一对多关联
// 错误做法:直接JOIN会导致一个订单对应多个商品行,造成订单数据重复
// 正确做法:使用子查询或GROUP BY限制返回行数

$sql = "SELECT o.order_id, o.user_id, SUM(oi.quantity * oi.price) as total_amount
        FROM orders o
        JOIN order_items oi ON o.order_id = oi.order_id
        WHERE o.status = 'paid'
        GROUP BY o.order_id, o.user_id
        HAVING total_amount > 0";

$stmt = $pdo->query($sql);
$results = $stmt->fetchAll();

foreach ($results as $row) {
    echo sprintf("Order ID: %s, Total: %.2f\n", $row['order_id'], $row['total_amount']);
}
?>
该分支代码展示了如何通过GROUP BY将多个订单项聚合为一条订单总额记录。结果中每个order_id仅出现一次,避免了JOIN带来的行膨胀。若使用DISTINCT替代GROUP BY,虽然也能去重,但无法计算SUM等聚合值,且在大表JOIN时性能更低。验证时需对比两种写法的结果集大小,确保业务逻辑符合预期。
验证与实际边界确认
去重后的数据需验证完整性,特别是当使用GROUP BY时,未包含在GROUP BY子句中的非聚合字段可能导致不确定结果。实际边界包括:大数据量下DISTINCT的内存消耗、NULL值参与比较时的行为差异、以及事务隔离级别对可见性的影响。建议在测试环境使用EXPLAIN分析执行计划,确认是否使用了索引进行去重优化。若发现去重后数据丢失,检查WHERE条件是否误过滤了有效记录,或JOIN条件是否过于宽松。














