





本文探讨在 go 中对超大二进制文件(每条记录严格 1024 字节)进行高性能解析的设计策略,重点分析单线程顺序解析与多 goroutine 并发解析的适用场景、内存约束、i/o 与 cpu 负载平衡,以及基于生产者-消费者模型的可扩展架构。
本文探讨在 go 中对超大二进制文件(每条记录严格 1024 字节)进行高性能解析的设计策略,重点分析单线程顺序解析与多 goroutine 并发解析的适用场景、内存约束、i/o 与 cpu 负载平衡,以及基于生产者-消费者模型的可扩展架构。
对于固定长度记录(如 1024 字节/条)的二进制文件解析,核心瓶颈通常不在磁盘 I/O(尤其是使用 os.File 配合 bufio.Reader 或 io.ReadFull 时具备良好缓存局部性),而在于记录级反序列化逻辑的 CPU 开销。因此,将解析阶段并行化是合理且常具收益的设计选择——前提是解析函数本身是纯计算型、无共享状态、无阻塞调用(如网络或锁竞争)。
推荐采用经典的生产者-消费者流水线模式:
炫酷的jQuery二进制数字时钟
下载
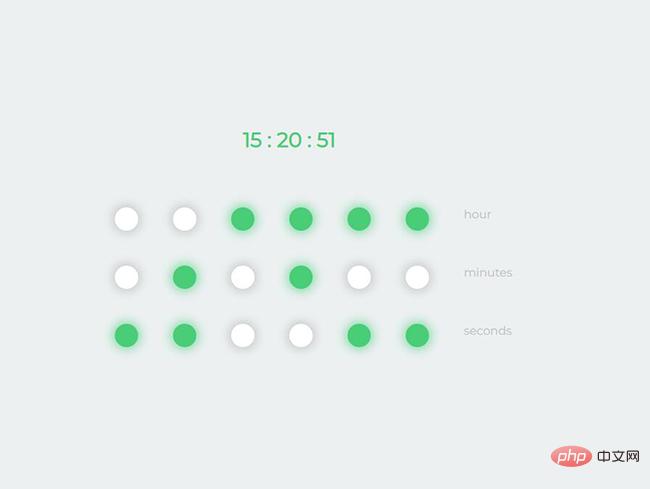
炫酷的jQuery二进制数字时钟,它的时分秒都是用二进制来表示,绿色表示该位值是1,灰色则表示0,原理是将时钟的时分秒分别实时转换成二进制,然后随着本地时间的更新而实时刷新
-
生产者协程(单个)负责顺序读取文件,每次
io.ReadFull获取 1024 字节,校验完整性后将[]byte(或更安全地,拷贝后的副本)发送至无缓冲或适度缓冲的chan []byte; -
N 个消费者协程(建议初始设为
runtime.NumCPU(),后续按需调优)从通道接收字节切片,执行解析(例如解包结构体字段、校验 CRC、转换数值类型等),并将结果(如Record结构体指针或值)通过另一通道chan Record发回主 goroutine; -
主 goroutine 汇总结果,写入预分配的切片(
make([]Record, 0, fileSize/1024)),同时监控错误、超时及上下文取消。
⚠️ 关键注意事项:
-
避免内存爆炸:绝不直接将原始
[]byte在 goroutine 间长期持有;解析完成后立即释放或使用sync.Pool复用缓冲区。对 256 TB 文件,即使仅缓存解析结果(而非原始字节),也需分块处理(如每 100 万条记录为一批),配合流式输出或数据库批量插入,而非全量驻留内存; - 谨慎评估并发收益:若单条记录解析耗时
- 错误处理需统一收敛:所有消费者应将错误(如校验失败、格式异常)通过专用错误通道返回,主 goroutine 统计并决定是否中止流程;
-
替代方案考量:对极端规模(TB+),可进一步升级为「分片+多进程」(如用
mmap切分文件区域,fork 子进程解析),或引入内存映射(syscall.Mmap)减少拷贝,但会增加平台依赖性和复杂度。
综上,你的设计思路本质正确——串行读取 + 并行解析是兼顾安全性、可控性与性能的黄金折中。实际落地时,优先实现基础流水线,再通过 pprof 分析 CPU/allocs 热点,动态调整 worker 数量与缓冲区大小,而非过早追求理论最优。













