





在统计学领域,聚类分析是一种常用的数据探索方法,而r语言凭借其开源、灵活且功能强大的特性,成为执行此类分析的理想工具。本文聚焦于实际操作流程,仅演示关键代码与结果呈现,有关系统聚类中诸如最长距离法、最短距离法等算法背后的数学原理,将不予展开。
1、 启动R环境后,依次输入样本观测值:1、2、3、7、8、9、15,构造一个长度为7的一维向量,并显式指定其维度为7行1列;随后调用dist()函数计算该向量中各元素间的欧氏距离,生成对称的距离矩阵。具体实现为:定义向量x存储上述数值,通过dim()设定其结构,并使用dist(x, method = "euclidean")获得距离矩阵d。
2、 其中,x为原始数据向量,dim用于明确其行列维度,dist则负责完成距离度量并输出距离矩阵。
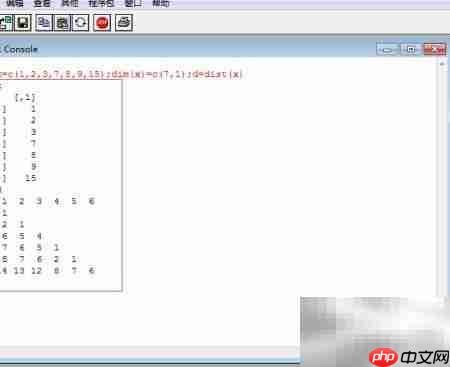
3、 接下来开展系统聚类(层次聚类)分析。
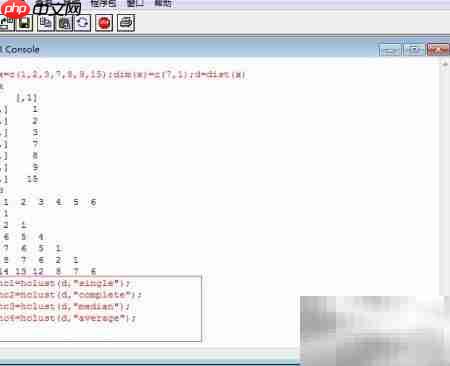
4、 输入相应R命令
5、 hclust()是R中执行系统聚类的核心函数;参数method可选"single"(单连接/最短距离法)、"complete"(全连接/最长距离法)、"median"(中间距离法)以及"average"(平均连接/类平均法),分别对应四种经典凝聚式聚类策略。
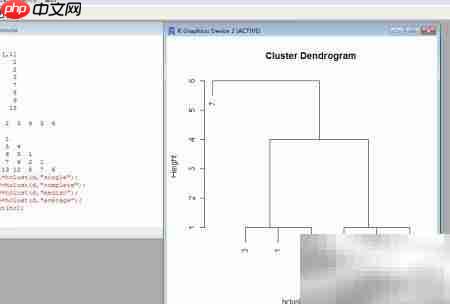
6、 利用plot()函数可视化基于最短距离法构建的树状图(dendrogram),直观反映各样本点之间的亲疏关系及层级分组模式。
7、 绘制由hc1 所得结果的聚类树形图
8、 为了横向对比不同连接方式下的聚类效果,可将四种方法生成的树状图整合在同一幅图形中进行观察。
9、 输入绘图指令
10、 par()用于统一设置绘图参数,其中mfrow = c(2, 2)表示启用2行2列的多图布局,子图按先行后列顺序填充。
11、 最终呈现的组合图形如下所示:
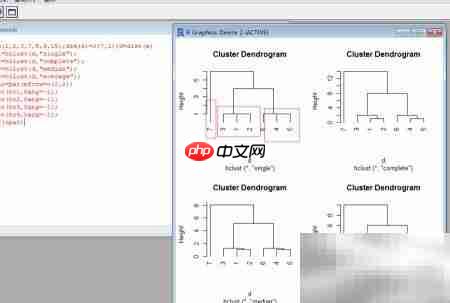
12、 观察图中分支结构可知:第1–3个数值(即1、2、3)被归为一类,第4–6个数值(即7、8、9)构成第二类,而第7个数值(即15)独立成簇,整体形成三个自然聚类。若希望程序自动识别最优类别数,可借助rect.hclust()函数辅助划分。
13、 调用plot()与rect.hclust()联合绘制聚类树,并强制划分为两个簇。
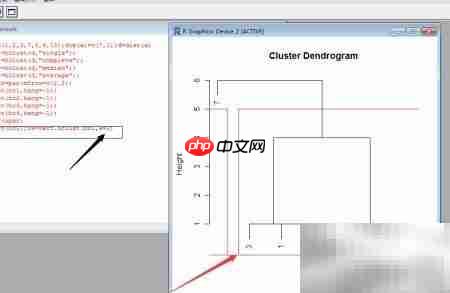
14、 图中清晰显示数据已被划分为两个互斥群组,分界线已标出,分类标签亦同步呈现,整个聚类任务至此顺利完成。














