


蚂蚁百灵于10月20日正式开源 ming-3.0 语音大模型系列,聚焦声音内容创作、长时音频理解分析、行业场景语音转写三大核心任务,推出涵盖语音合成(tts)、音频理解与对话(audio understanding)、语音识别(asr)三大方向的五款模型:ming-3.0-tts(含 0.5b 与 tiny 两个版本)、ming-3.0-audio(含 flash 与 tiny 两个版本)以及 ming-3.0-asr-tiny。全部模型权重已同步上线 hugging face 与 modelscope 平台,ling studio 同步提供标准化 api 接口及在线交互体验。
在语音合成方向,Ming-3.0-tts 引入 Voice Design 功能,支持通过自然语言描述目标音色特征,或上传参考音频实现音色定制;导演模式可基于文本指令精准控制情绪起伏、重音位置与语速节奏,并原生支持行内副语言标签(如 <laugh>、<sigh>、<cough>),灵活标注笑声、叹息、咳嗽等非言语信息。该系列模型已落地至阿福 APP 语音通话、医生个性化音色克隆、小虎智能办公等实际业务场景。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
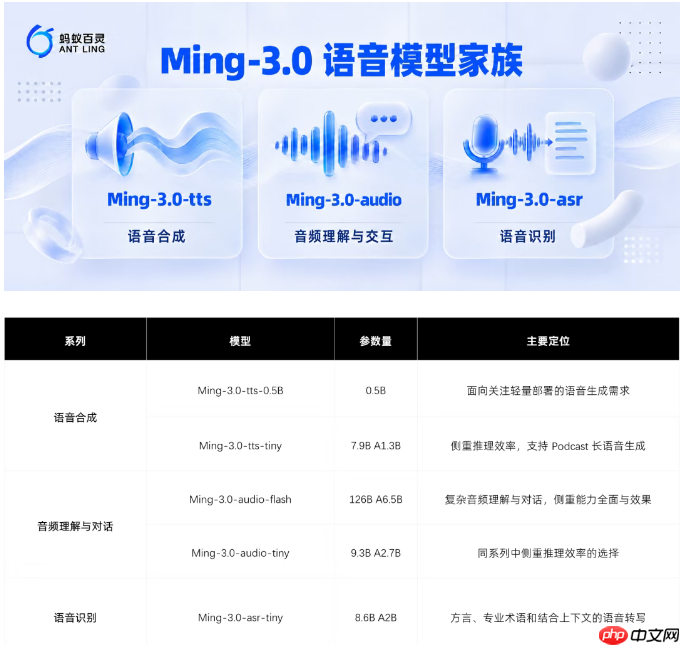
在音频理解方向,Ming-3.0-audio-flash 与 Ming-3.0-audio-tiny 具备端到端长音频处理能力,可直接完成语音转写、内容摘要、观点抽取与结构化输出,同时保留原始音频中的情绪倾向、说话人身份及环境声学线索。其输入模块采用 6.25Hz 超低帧率音频表征技术,显著压缩序列长度;主干语言模型基于 Ling-3.0 架构,融合 KDA(Knowledge-Distilled Attention)与 Gated MLA(Gated Multi-Level Attention)混合注意力机制,并引入稀疏 MoE(Mixture of Experts)提升建模效率。

在语音识别方向,Ming-3.0-asr-tiny 创新提出 Context ASR 架构,支持动态加载热词列表与上下文对话历史,无需微调即可有效缓解同音异义歧义问题。目前已集成至阿福医生助手、支付宝搜索语音入口及金融级安全核身流程中。
实测性能方面,根据 Artificial Analysis 2026 年 10 月发布的权威评测报告:
- Ming-3.0-tts-0.5B 在 Pronunciation Robustness 指标上斩获 93.2% 分数,并列榜单首位;Controlled Voice 综合能力达 1069 Elo,位居所有开源权重模型榜首;
- Ming-3.0-audio-flash 在 MMAU 与 VoiceBench 基准测试中分别取得 82.00 与 86.74 分,在 BigBenchAudio(S2T)任务中以 99.40 分登顶第一,SpeechFCEval 得分为 82.60;
- Ming-3.0-asr-tiny(8.6B A2B 版本)在四大主流 ASR 评测集上的平均词错误率(WER)低至 4.41%,全面优于 Fun-ASR1.5、FireRedASR2-LLM(8B)与 Qwen3-ASR-1.7B 等竞品模型。














