


用jev做判断准确率卡壳的时候,先别急着换模型。大部分问题根本不是模型的锅,要么是原语选得不对,要么是判定标准写得太模糊,要么是输入状态缺关键证据,阈值设得太冒进,再不然就是样本复盘的方法错了。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
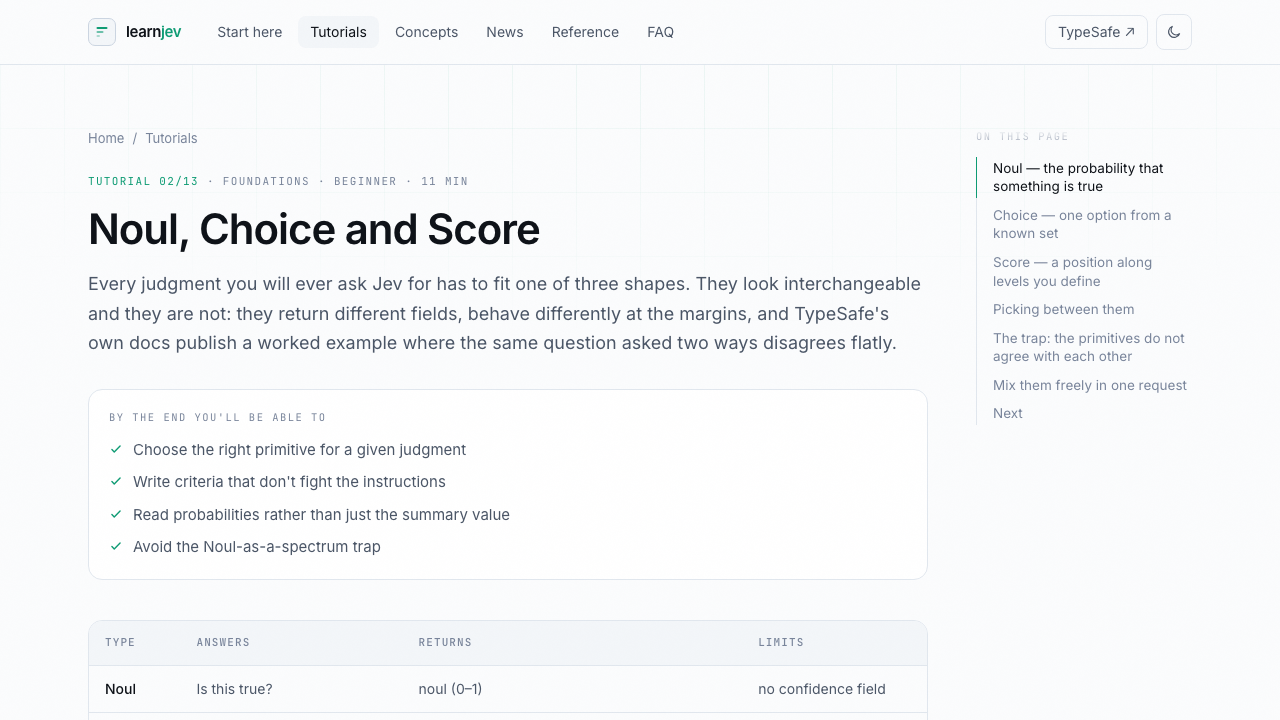
这张截图来自Learn Jev的三种输出原语教程页面,核心就是想说明,优化准确率得先从Choice、Score、Noul这三类问题的适配形态入手。
准确率为什么卡住
不少团队刚上线Jev的时候,发现人工改判率居高不下,直接就觉得Jev适配不了自己的业务。但顺着链路查下来,绝大多数情况都是踩了基础错误:该用有序等级输出的场景选了Choice分类,该做是非判断的场景选了Score打分,甚至把好几个独立问题硬塞到同一个判定条件里。
模型哪怕跑出来看似合理的结果,从根上你提的问题方向就错了。
准确率来自问题形状和证据字段
Jev的判定逻辑,只会基于你提供的state状态信息和预设问题来跑。
要是state里连订单状态、支付结果、用户历史操作次数这些关键字段都缺,模型只能对着用户输入的单句文本瞎猜;要是判定规则没把边界写死,输出的概率就会散落到好几个选项里。
优化准确率的核心根本不是往提示词里堆字数,而是把每个问题的定义收得更精准,配套的证据字段补全,每一步判定动作都能回溯复现。
五步排查准确率
- 看原语是否选对:分类场景用Choice,有序等级打分用Score,事实命题判定用Noul。
- 看state是否缺证据:人做判断需要的所有参考信息,模型同样也需要,别指望它无中生有。
- 看选项是否重叠:长期出现前两名输出概率差不多的情况,说明选项的边界根本没划清。
- 看阈值是否激进:把模棱两可的灰区也放开自动化,只会拉低整体的实际效果。
- 看样本是否偏:只用100%明确的样本来测,测出来的准确率肯定虚高,到线上就翻车。
问题来源与优化方向
| 现象 | 可能原因 | 优化动作 |
|---|---|---|
| 大量 other | 选项覆盖不足 | 补类别或分层 Choice |
| Score 集中在中间 | 等级描述太模糊 | 补具体场景 |
| Noul 灰区多 | state 证据不足 | 补关键字段 |
复盘样本怎么选
复盘的时候别盯着判对的样本反复看,最有参考价值的其实是三类:人工介入改判的样本、输出概率刚好卡在阈值附近的样本、最终触发业务投诉的样本。把这三类样本整理成固定的回放测试集,每次改完判定规则或者阈值都全量跑一遍,才能确认这次优化是真的稳定生效,不是碰运气。
准确率复盘要拆成三类样本
准确率卡壳的时候,整体的平均准确率数字参考意义不大,最有用的是把错误样本做分层归类。所有误判基本都能归成三类:缺关键字段、问题边界重叠、阈值设置太冒进,分开逐个处理就行。
缺字段就补state里的信息,边界模糊就改判定规则,阈值太严就把灰区范围放大,千万别三个地方同时改,最后连是哪步生效的都不知道。
| 错误类型 | 识别信号 | 优先修法 |
|---|---|---|
| 缺字段 | 人工需要的证据不在 state | 补字段 |
| 边界重叠 | 前两名概率接近 | 改 criteria |
| 阈值激进 | 灰区被自动化 | 提高复核线 |
准确率不要只看总分
看准确率别光看总得分,一定要按业务分类拆开算。支付、物流、售后、账号这些不同的场景,误判带来的损失天差地别,别拿一个整体的平均准确率把高风险类别的问题给盖过去了。
建议单独统计每类业务的人工改判率、灰区占比和投诉样本量,优先级往风险高的场景倾斜,优化效率会高很多。
一次误判样本该怎么拆
举个例子,用户留言说“又扣了我一次钱,货还没发”,结果系统自动把这个工单分到了物流处理队列。复盘这种误判别笼统写一句“模型识别错误”就完事,拆成两个维度排查:第一,当前的state里有没有标注重复扣款的相关事件?第二,Choice分类的规则里有没有明确多意图场景下的分类优先级?
要是state里压根没同步重复扣款的字段,先补证据字段;要是所有字段都齐全还是判错,再去调整判定规则和灰区策略。
错误样本的标注规范
标注错误样本的时候,别只打个“对/错”的标记就完事,建议多给样本加一层错误原因标签:比如缺字段、类别边界重叠、阈值设得太低、业务规则更新了、用户表述太模糊等等。
后续统计这些标签的占比,就能直接搞清楚接下来是该先补state字段,还是先改问题规则,或是调整阈值。
记录人工复核结果的结构
const reviewRecord = {
  questionVersion: 'support_route_v3',
  stateHash: 'order_abc_123',
  modelAnswer: { choice: 'billing', confidence: 0.66 },
  humanAnswer: 'logistics',
  reason: 'user asked about shipment after mentioning payment',
  createdAt: new Date().toISOString(),
};
准确率优化坑点
- 只调阈值不动问题描述,等于把真实问题盖住了,之后还会反复出问题。
- 只盯着整体准确率,忽略高风险业务类别的误判,很容易出线上事故。
- 测试样本全是特征非常明确的案例,等上线遇到各种模糊的灰区场景肯定翻车。
- 不给问题规则加版本号,后续跑回放测试的时候根本没法对比不同版本的效果差异。
可执行结论
准确率卡壳的时候,先把所有错误样本按原语适配、证据完整性、阈值设置、选项覆盖度这几个维度拆开归类。只要能精准定位错误来源,针对性调整的效果远比你盲目换个新模型好得多。












