


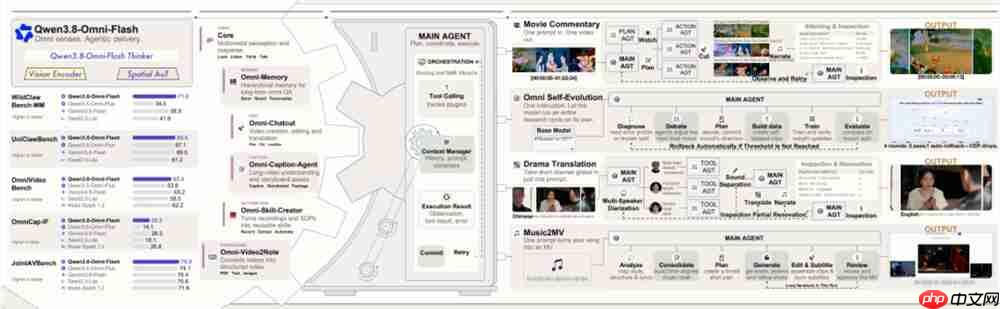
千问于18日正式发布全新一代原生全模态大模型 qwen3.8-omni-flash,全面支持文本、图像、音频与视频多类型输入,并具备高达1m的超长上下文处理能力,目前已在千问 ai 平台开放公测体验。该模型在延续此前已具备的编程能力、文本知识处理能力及 gui 自动化操作等通用 agentic 能力基础上,重点强化以音视频为核心的应用场景,涵盖智能视频剪辑、mv 自动生成、影视内容制作与配音解说、音视频内容转图文摘要,以及自然流畅的音视频多轮对话等复杂多模态任务流。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
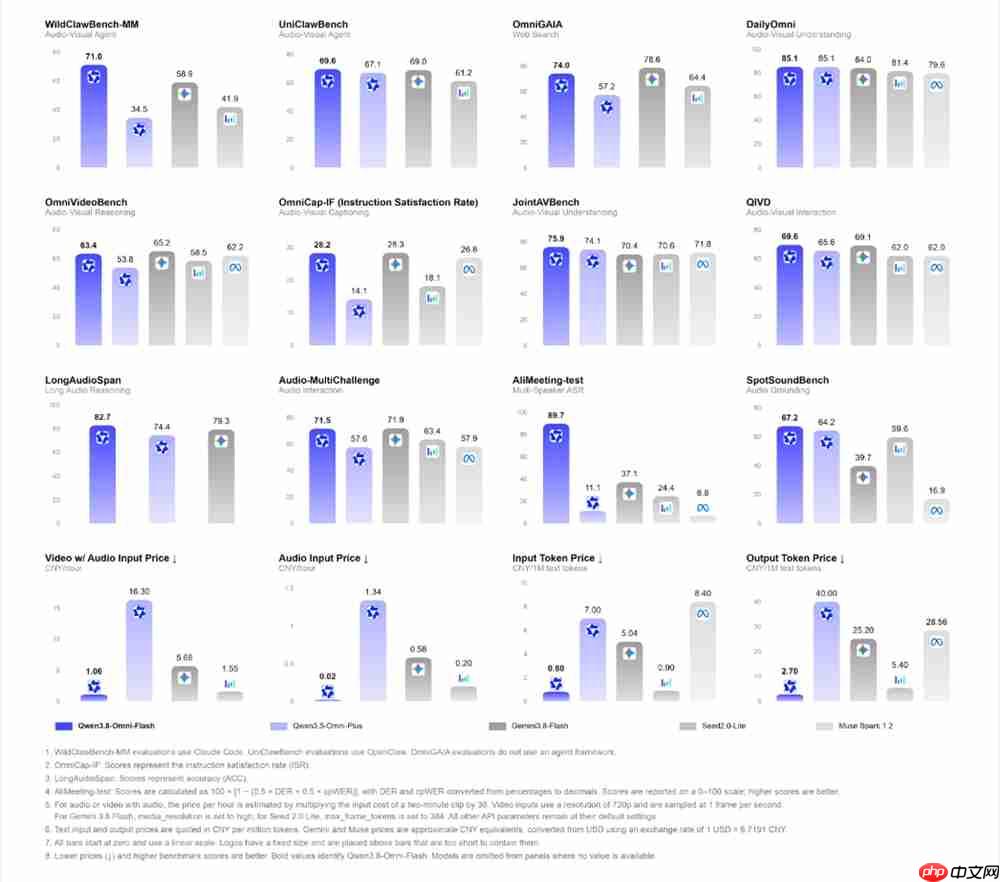
在涵盖30项权威基准的综合评测中,Qwen3.8-Omni-Flash 平均得分相较前代 Qwen3.5-Omni-Plus 提升逾26%。其中,在音视频智能体(Audio-Visual Agent)、代码生成与长周期任务执行等关键维度表现尤为突出:WildClawBench-MM 得分提升36.5分,AgenticVBench 提升22.3分,UniClawBench 达到69.6分;基础多模态能力方面,LongAudioSpan 提升8.3分,OmniVideoBench 提升9.6分,OmniCap-IF 的字符级识别率(CSR)与实例级识别率(ISR)分别提升8.5和14.1分;语音会议理解任务 AliMeeting 的说话人错误率(DER)与字符级词错误率(cpWER)则由88.11 / 89.61大幅优化至3.35 / 17.18。
官方表示,该模型在音视频理解与生成能力上已逼近 Gemini3.8Flash 水平,音频专项能力整体超越后者;同时,API 接口定价大幅下调——每小时音频输入费用降幅超98%,音视频联合输入费用降幅超93%。

用于在用户想通过浏览器自动化与 Google Gemini 或 ChatGPT 交互时。触发短语包括“ask Gemini”“ask ChatGPT”“ask GPT”“让...”。
为更好支撑长周期任务调度与低延迟实时交互,千问同步升级了 Qwen-MM-Plugins 插件体系,并正式开源轻量级实时推理框架 Qwen-Live Harness。在 Agentic Understanding 工作模式下,OmniVideoBench 准确率从63.4提升至67.8,单次推理 Token 消耗由145,736降至79,117,降幅达约45.7%。
更进一步,研发团队将模型能力反哺自身研发流程:仅用12小时即完成评测集筛选、高质量数据构建与四轮模型迭代训练,累计生成3,413条训练样本,成功将 Qwen2.5-Omni-3B 在四川方言语音识别任务中的字符错误率(CER)由25.79%显著降低至15.30%,相对下降幅度达约40.7%。同期发布的 Realtime 版本,亦是业界首个实现“听声辨位”空间音频感知能力的全模态大模型。














