


ai大模型持续迭代升级,算力规模持续攀升。
当数量日益庞大的GPU被紧密联结,AI基础设施所面临的挑战,也正从“单点算力是否足够强劲”,进一步演进为——如何让海量算力实现更高速、更稳定、更
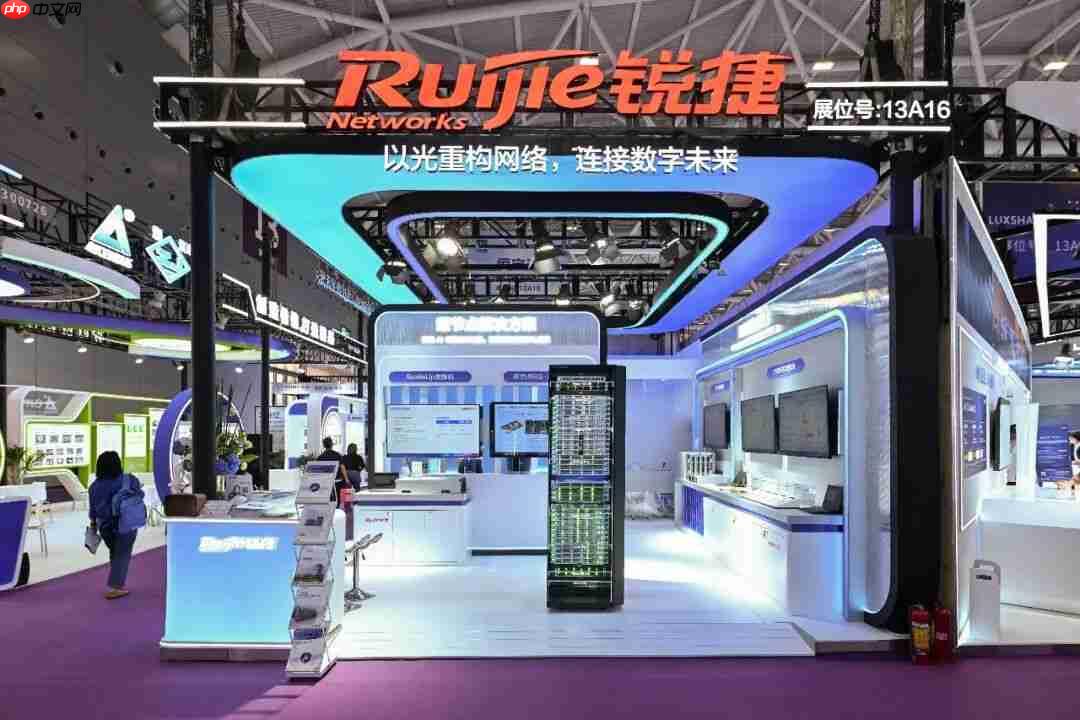
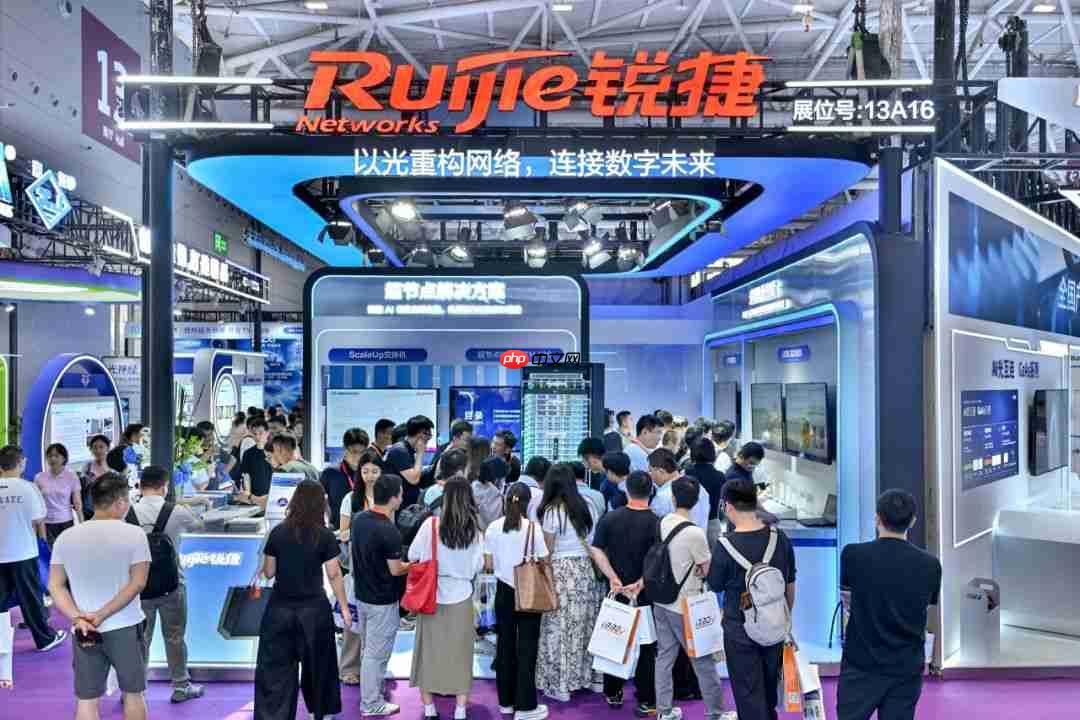
CIOE2026展会现场,锐捷网络紧扣AI时代对极致互联能力的需求,系统呈现光电融合、超节点架构、AIDC智算数据中心三大技术方向的创新成果。
涵盖800G至1.6T高速光互连方案、面向超节点场景的ScaleUp组网架构,以及覆盖交换、连接与智能运维全链路的AI-Fabric网络体系,一系列前沿产品与端到端解决方案集中亮相。
一个愈发明确的发展脉络,也在展台之上清晰浮现:
在AI算力加速跃迁的同时,网络基础设施同样迎来新一轮深度演进。
光电融合:
面向800G、1.6T演进,驱动高速互联持续突破
随着AI集群规模持续扩大,芯片间、节点间的通信数据量呈指数级增长。
网络带宽正加速由400G迈向800G、1.6T。在获得更高吞吐能力的同时,功耗控制、传输时延、链路可靠性及机柜部署密度等现实问题,也亟待系统性解决。
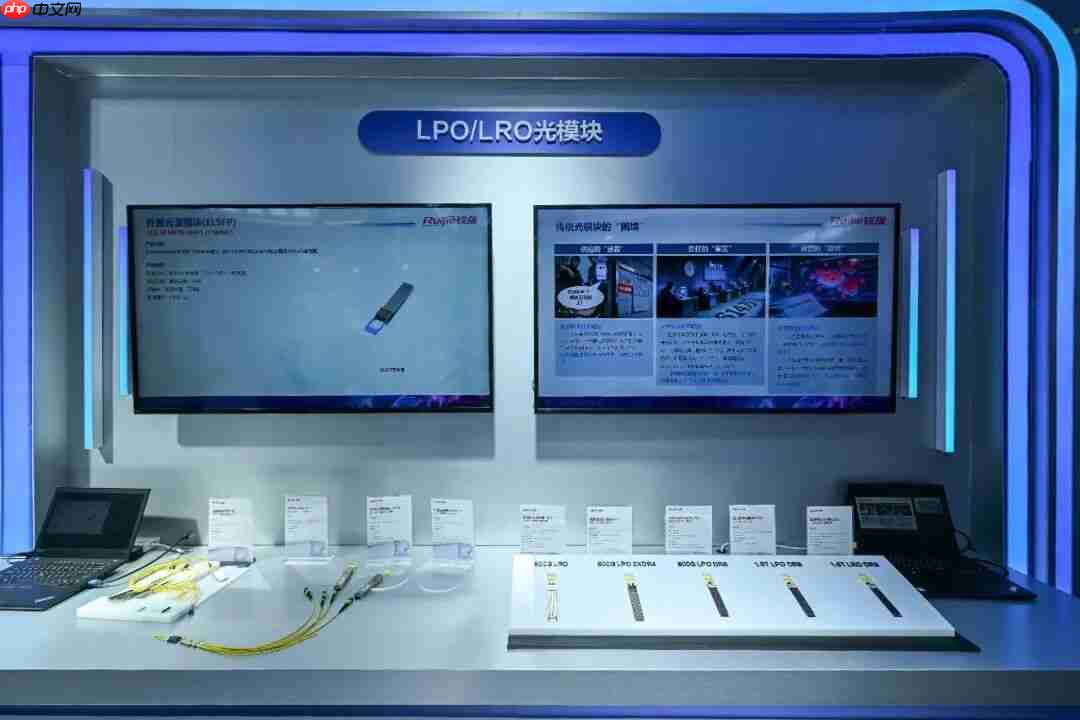
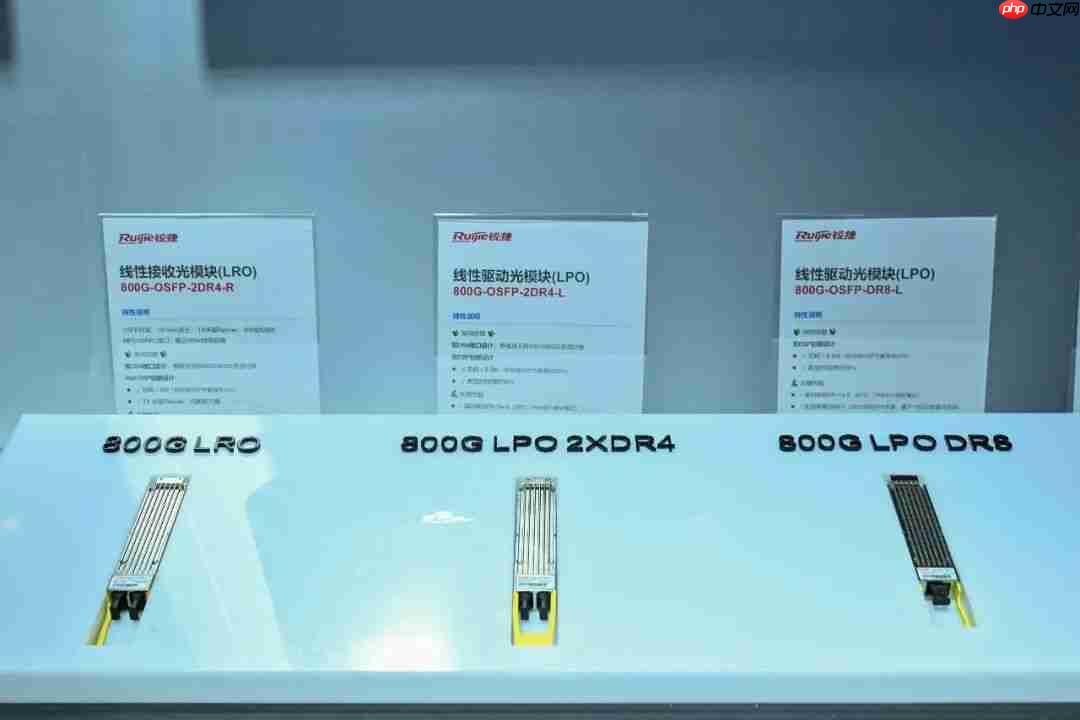
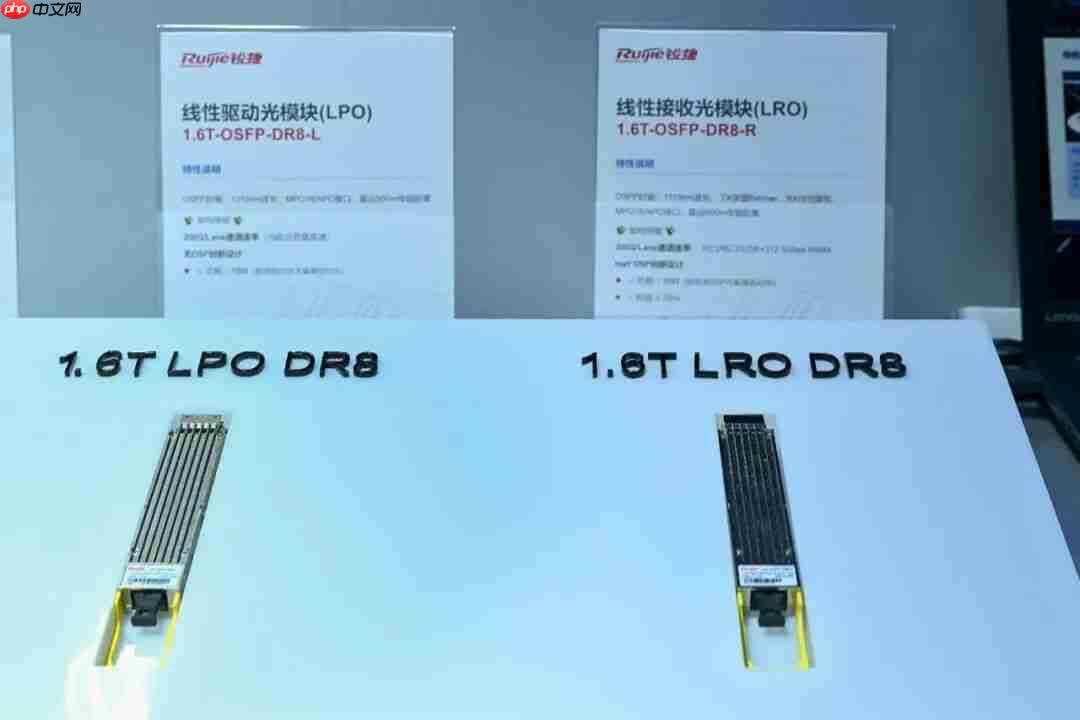
在此背景下,LPO(线性驱动光模块)、LRO(线性接收光模块)、NPO(近封装光互连)等新一代光互联技术路径,成为本届CIOE备受瞩目的焦点议题。
锐捷网络展区内,102.4T四芯NPO交换机、3.2T NPO光模组、8通道ELSFP光互联组件同步展出,全面覆盖交换设备与光连接层,展现其面向下一代高速互联的技术布局与工程实践。
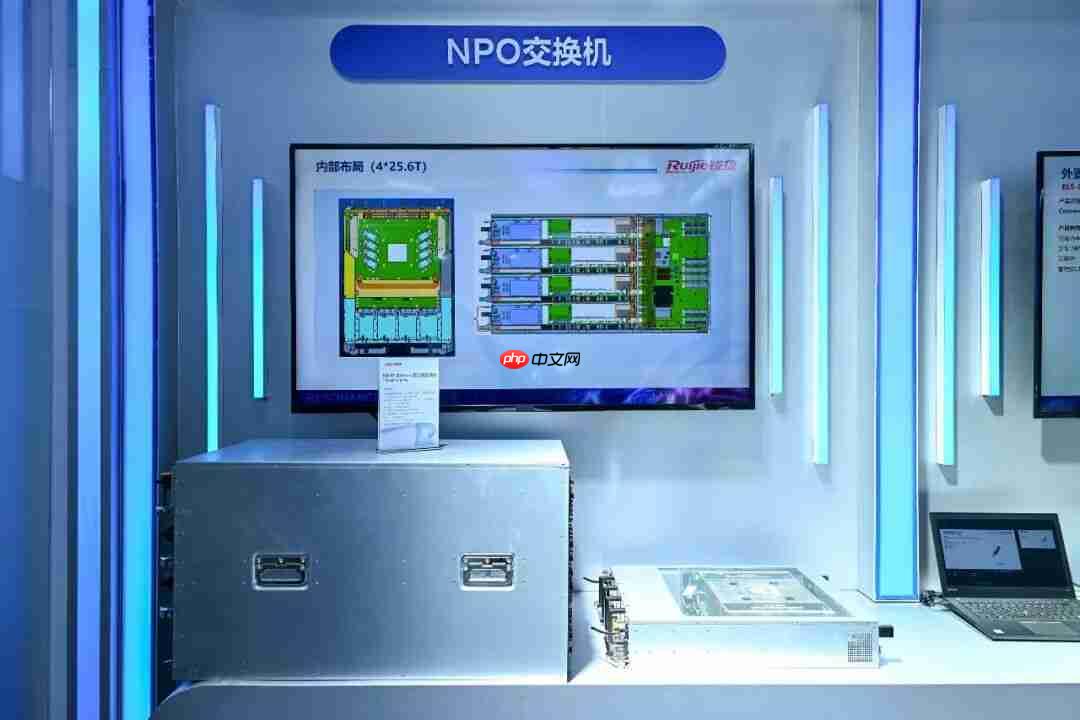
从800G迈向1.6T,从交换侧延伸至光模块侧,锐捷所聚焦的不仅是“带宽翻倍”的表层目标,更是围绕AI数据中心真实落地场景,推动低时延、高可靠、低功耗、高密度互联能力真正规模化部署。
在算力密度持续提升的当下,高速网络的竞争已迈入系统化、全局化的新阶段。
比“快”更关键的是——如何可持续地快、可信赖地快、
超节点:
算力高度集聚之下,网络深度参与“算力组织”
如果说高速光互联解决的是“算力之间能否连通”,那么超节点则深入回答了一个更具战略意义的问题:
如何让高度集约化的算力资源,像有机整体一样
伴随AI基础设施持续升级,计算单元正从传统服务器集群向超高密度异构计算单元演进。网络角色亦随之转变——不再仅是数据传输通道,更成为决定整套AI计算系统协同效率的核心使能要素。
本届CIOE,锐捷网络正式推出超节点RG-ETH128及配套ScaleUp交换设备。
针对AI训练、推理等差异化负载场景,通过节点级极致互联能力,构建与高密算力相匹配的网络底座,释放全域算力潜能。
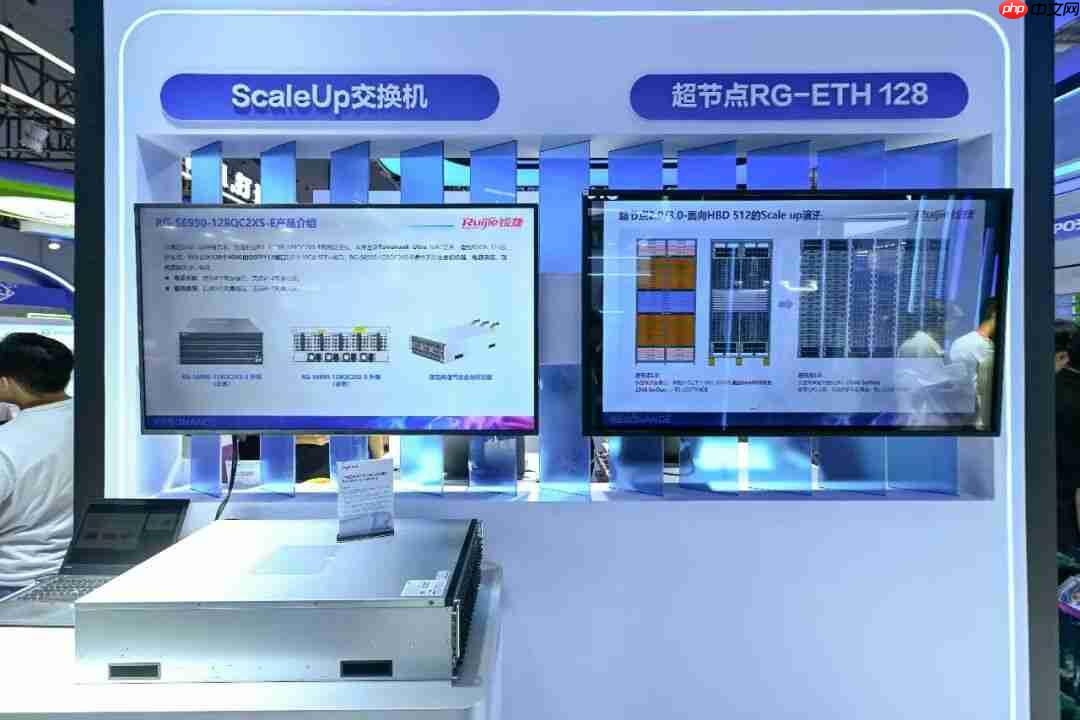
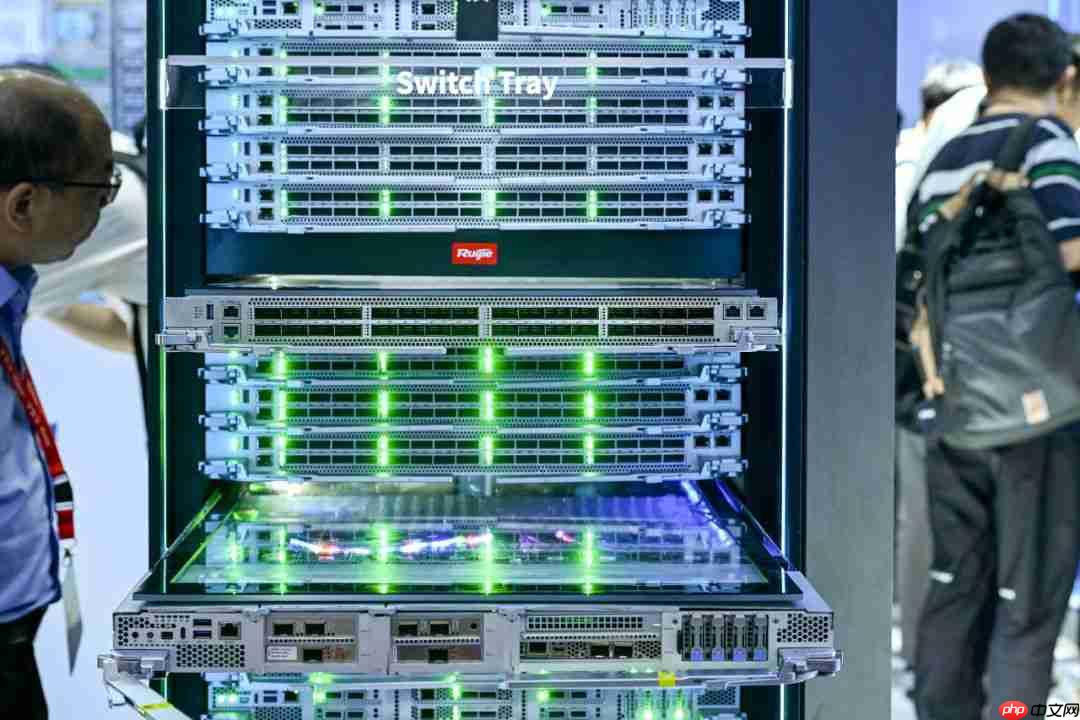
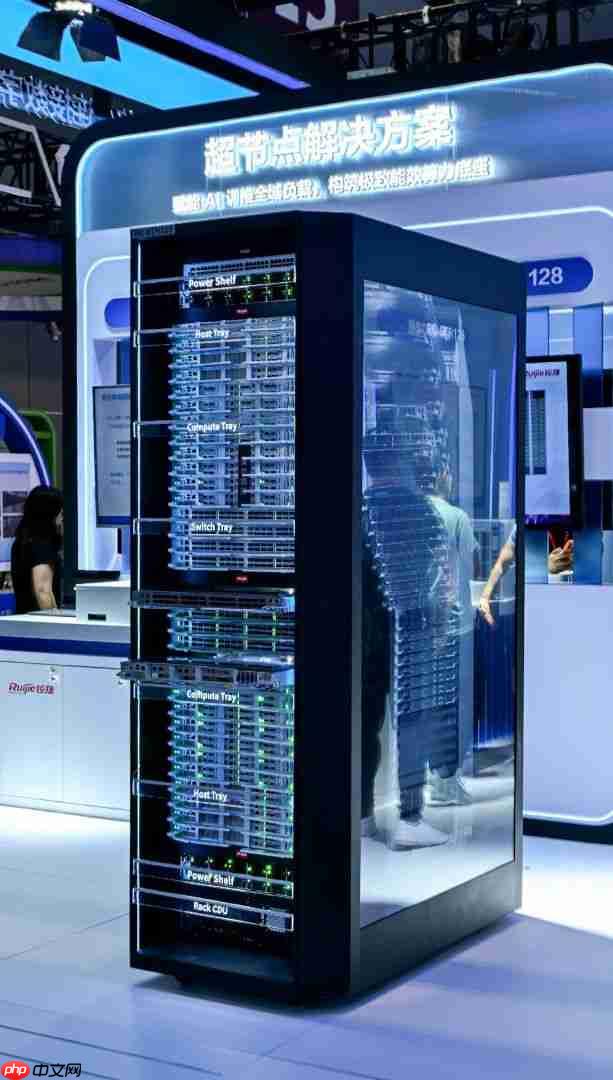
从ScaleOut走向ScaleUp,AI网络所连接的对象、承载的流量特征及性能要求均发生根本性变化。
尤其在超节点架构下,网络与计算之间的耦合关系前所未有地紧密。
过去,数据中心网络关注的是“服务器能不能连上”。
而进入AI时代,核心命题正在转向:
这些算力资源,能否真正
这正是锐捷超节点方案此次力求回应的关键课题——赋能AI训推全场景负载,打造绿色、智能、可扩展的能效型算力基座。
AIDC:
不止于快速建设,更要实现算力组网的易用性与可运维性
一张大规模AI网络的成功落地,远非将高性能交换设备简单部署于机房即可达成。
设备如何精准对接?
海量光纤布线如何简化设计与实施?
网络上线后如何实现可视化监控、自动化排障与策略化运维?
随着AI集群规模持续扩大,上述环节带来的复杂度亦呈几何级上升。
本次展会,锐捷网络同步展示了面向AIDC(AI-Dedicated Data Center)全生命周期的完整解决方案。
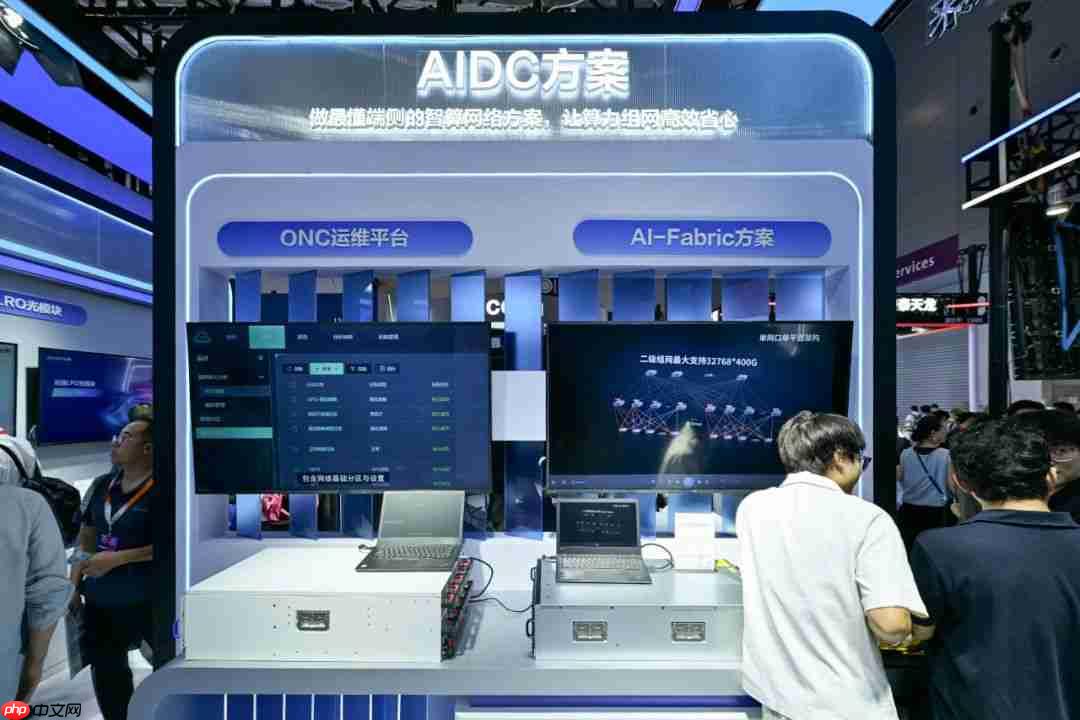
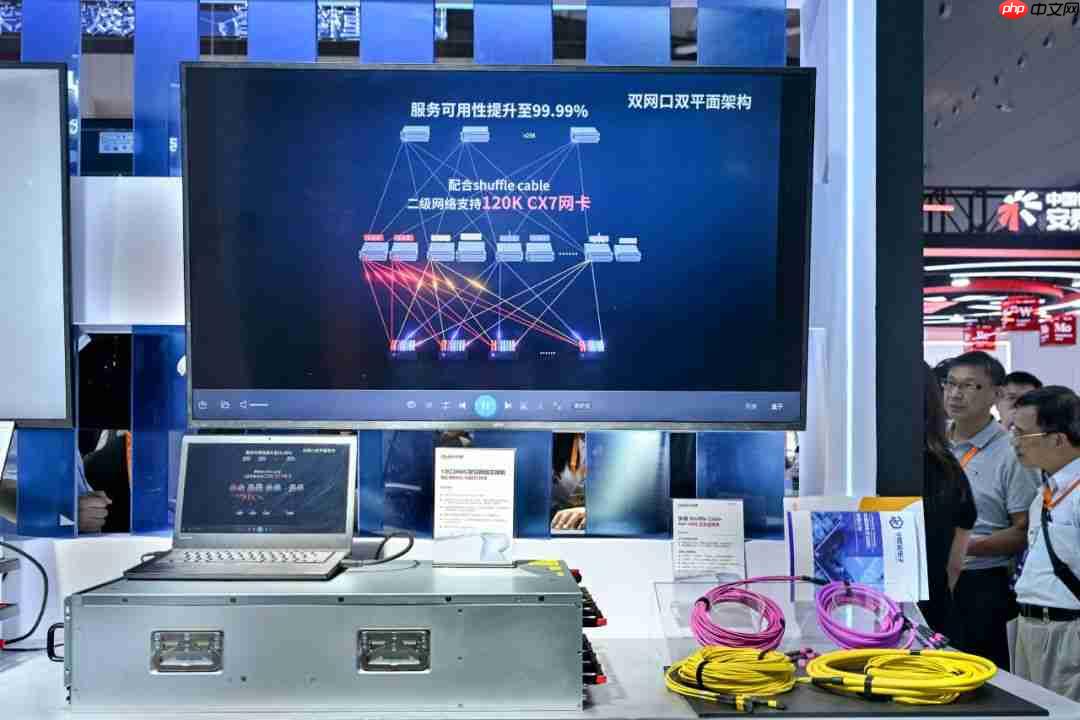
从“连接网络”迈向“连接算力”
从LPO、LRO、NPO光互连技术,到超节点架构;从AI-Fabric智能网络体系,再到ONC开放网络控制器,锐捷网络在CIOE2026展出的多项技术虽分属不同层级——光器件、交换设备、节点架构与智能平台,但其底层逻辑高度统一:
AI正在重塑网络的本质定义。
带宽需持续跃升,能耗须持续优化;
计算节点日趋紧凑,网络协同效能必须同步增强;
AI集群日益庞大,建设部署与日常运维也亟需极简化、智能化。
因此,未来AI网络的竞争维度,早已超越交换容量或端口速率等单一指标。
光、电、交换、连接、计算与智能运维,正被纳入一个统一架构中进行系统性重构与协同演进。
当算力持续向前奔涌,承载并调度算力的网络,亦必须同步进化、同频共振。
CIOE2026,精彩仍在延续。
锐捷网络将持续聚焦AI基础设施演进主线,在高速光互连、超节点架构、智算网络等关键方向深化探索,让每一份算力,都能被更













