京东于9月9日举办的全球科技探索者大会(jdd)上,京东探索研究院正式推出joyai-echo系列两大核心技术升级:超长音视频生成模型升级至joyai-echo 1.5,并同步发布并开源可交互视听世界模型echowm。前者突破音视频连续生成时长瓶颈,实现10分钟以上稳定输出;后者深度融合原生视听生成与实时用户控制能力,推动ai内容由“可观”迈向“可入、可探、可交互”。
在长视频生成方向,JoyAI-Echo 1.5采用音视频Memory Bank架构,有效保障多镜头切换与长时间序列中人物形象、声纹特征及叙事逻辑的高度一致性,支撑超10分钟无断点音视频生成。依托长视频后训练策略,模型推理效率最高提升7.5倍;仅需2张H200 GPU,即可在480P分辨率下实现每秒24帧的等时生成(1:1 real-time)。内置的Director Agent支持自然语言驱动全流程创作——从故事构思、分镜设计、生成质量审核到成片自动组装,显著降低专业级视频生产门槛。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
当前世界模型发展主要呈现两类技术路径:一类强调画面响应式生成,但缺乏同步音频建模能力;另一类虽支持音视频联合生成,却难以维持用户持续介入与动态干预。EchoWM创新性地融合二者优势,原生支持720P高清视频、环境音效、背景音乐及语音内容的一体化生成,且声音随场景变化、摄像机运动与主体行为实时联动。通过统一表征的“相机意图”机制,模型可精准映射键盘/手柄操作为6自由度(6-DoF)空间轨迹,无缝支持第一人称沉浸导航、第三人称视角调度、主体协同控制及多轮次连贯探索。在面向交互式世界模型的权威评测WBench Navigation中,EchoWM与轻量流式版本EchoWM-Flash包揽冠亚军;其中EchoWM在涵盖158个多轮复杂导航任务的综合榜单中位列第一。

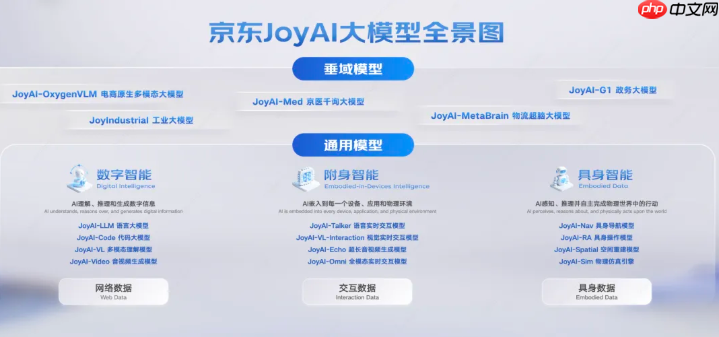
在底层技术体系层面,京东集中展示JoyAI基础模型矩阵全景图,能力覆盖图像与视频生成、多模态理解、实时交互、世界建模、智能语音及具身操作六大方向,标志着JoyAI正加速从静态内容生成向动态物理环境的感知、模拟与闭环交互演进。大会现场同步亮相新一代音视频基础模型JoyAI-Video,重点强化商业广告生成、物理规律建模、第一人称视角表达及多镜头连续叙事能力,将服务于电商营销、短剧工业化生产及具身智能训练等高价值场景,并计划于10月正式发布。
除模型外,京东同步展出EgoLive真实人类行为数据集、JoyAI-Sim仿真转换工具链及大模型全栈基础设施,构建起贯通“真实采集—仿真增强—模型训练—效果验证”的端到端研发支撑体系,为面向物理世界的AI系统提供坚实底座。
产业落地方面,零售、物流、医疗、工业、政务五大垂直领域AI模型与智能体集中发布:零售多模态模型支撑以图搜货、AI导购与素材合规质检;物流超脑3.0基于Agentic架构打通决策规划、流程调度与物理执行闭环;京医千询3.0深化医学影像解析、虚拟问诊模拟与可信临床推理;工业大模型深度嵌入设备选型、预测性维保与CAD辅助设计;政务大模型全面覆盖政策解读、智能办公协同与结构化数据分析。基础模型持续突破与行业智能体规模化落地双轨并进,共同构筑京东推动人工智能从数字空间跃迁至真实物理世界的完整技术范式与实践路径。