深度求索正式推出 deepseek v4.1 flash 模型。作为其全新模型架构系列中参数量最小的成员,该模型原生支持多模态视觉理解能力。此次结构设计的核心目标在于:突破性能天花板、提升推理效率、增强吞吐能力,并为未来扩展至更大规模参数模型预留充分空间。
输入激活仅需 8B,HBM 占用压缩至原有 1/4
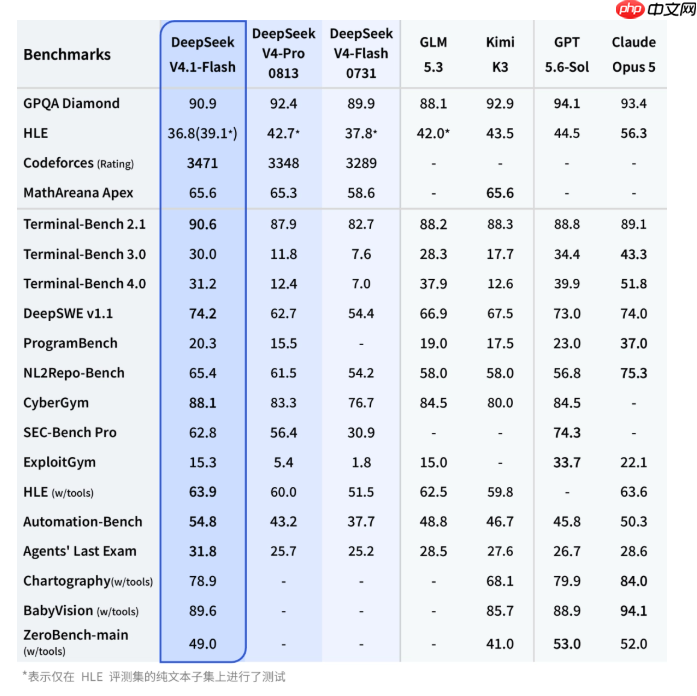
DeepSeek V4.1 Flash 是一款参数量达 552B 的混合专家(MoE)模型,首次采用创新的 Causal-Encoder-Decoder 架构,实现输入与输出路径的非对称设计——输入激活量仅为 8B,输出激活为 16B,显著优于当前同级别模型的成本表现。模型还引入了全新的预训练范式,并经过更广泛、更深入的强化学习后训练,在多项权威基准测试中成功超越 DeepSeek V4 Pro 等主流旗舰模型,展现出更强的综合智能水平。
同时,新一代架构大幅优化 KV Cache 占用:相较上一代模型,HBM 内存需求降低至 1/4,SSD 存储需求降至 1/8;对比初代模型,KV Cache 规模更是缩减至原始值的 1/437。在 Agent 类应用中,缓存命中开销通常占据较大比重,此次极致压缩有效压低了 Agent 场景下的整体调用成本。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
API 已全面开放,V4 Pro 将于 9 月 14 日起自动切换路由
DeepSeek V4.1 Flash 已同步上线 DeepSeek 官方 API,原生兼容多模态输入,开发者只需将模型名称指定为 deepseek-flash 即可直接调用。此前发布的 V4 Flash 及 V4 Flash Vision Exp 版本已正式下线;为保障平滑过渡,旧模型名 deepseek-v4-flash 与 deepseek-v4-flash-vision-exp 将临时重定向至 V4.1 Flash。

统一LLM网关 - 一个API对接70+AI模型,使用单一API密钥即可调用GPT、Claude、Gemini、Qwen、Deepseek、Grok等主流模型。
经多维度实测验证,V4.1 Flash 在推理速度、响应延迟、综合性能、单位成本等关键指标上均已全面领先 V4 Pro。基于此,官方决定有序推进 V4 Pro 的迭代替代:自北京时间 2026 年 9 月 14 日 12:00 起,直至下一代 V4.1 Pro 正式发布前,所有发往 deepseek-v4-pro 的请求将自动路由至 V4.1 Flash,并按其对应计价标准结算费用。
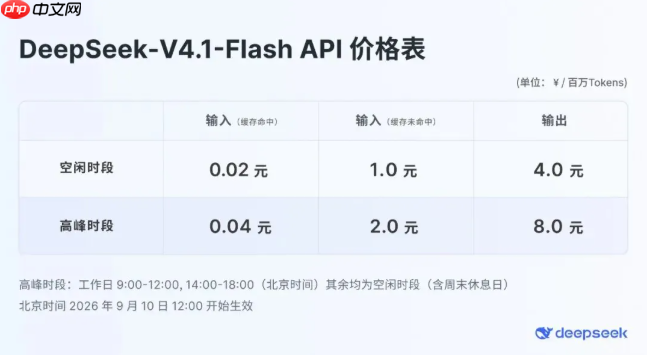
腾讯(WorkBuddy、CodeBuddy)与 OpenCode 已完成全量接入,成为 DeepSeek V4.1 Flash 首批官方合作伙伴。依托底层架构升级,官方同步下调 V4.1 Flash 的服务定价,继续沿用峰谷差异化计费机制——闲时单价为高峰时段价格的 50%,新资费标准将于 2026 年 9 月 10 日 12:00 起正式生效。模型权重文件及完整技术报告已同步开源至 Hugging Face 平台。