


需构建实时错误率报警机制并联动看板,核心是Nginx日志结构化输出、流式采集解析、滑动窗口分层计算错误率,且看板与告警共享同一数据源与计算逻辑。
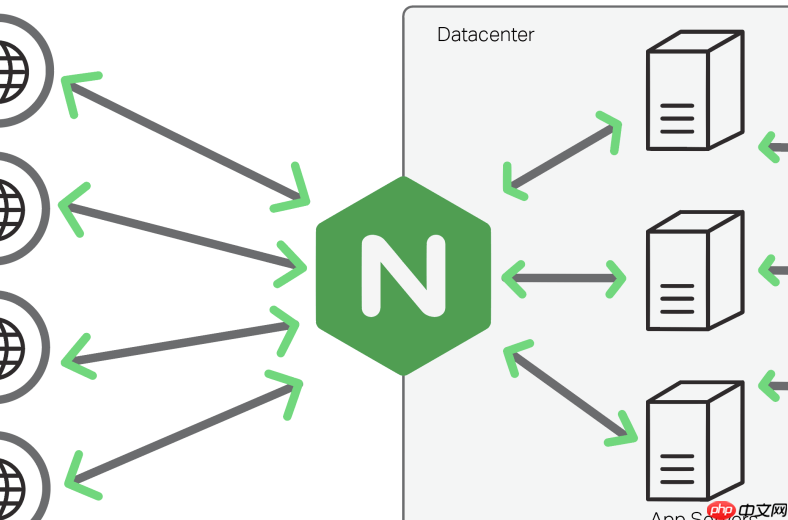
要构建实时错误率报警机制并联动看板,核心是让 Nginx 日志能被快速解析、结构化入库,并在秒级内完成聚合计算与阈值判断,同时将结果同步到可视化界面和告警通道。
一、日志必须结构化输出,且字段可参与数值运算
Nginx 默认 access_log 是空格分隔的文本,无法直接用于实时统计。需强制启用 JSON 格式,确保 status、request_time 等关键字段为原生类型(不是字符串):
- 在 http 块中定义 log_format:log_format json_log '{"time":"$time_iso8601","status":$status,"request_time":$request_time,"upstream_response_time":$upstream_response_time,"upstream_status":$upstream_status,"remote_addr":"$remote_addr","request":"$request"}';
- 在 server 或 location 中启用:access_log /var/log/nginx/access.log json_log;
- 注意:status 后不加引号,否则 Elasticsearch 或 Prometheus 会当作文本,无法做 5xx > 0 这类数值判断
二、采集与解析必须支持实时流式处理
不能等日志轮转后批量导入,必须边写边采、边采边解析:

- Filebeat 推荐开启 json.keys_under_root: true 和 json.overwrite_keys: true,避免嵌套字段影响聚合
- Fluent Bit 可用 parser 插件直接识别 JSON,配合 filter 插件丢弃 200/304 请求,减少后端压力
- 采集端务必添加环境标签,如 env: prod、service: api-gateway,便于后续多维度下钻
三、错误率计算需带滑动窗口与分层口径
单纯统计“5xx 占比”容易误报,应结合时间窗口、服务粒度、上游归属综合判断:
- 基础公式:过去 60 秒内 sum(rate(nginx_access_status{code=~"5.."}[1m])) / sum(rate(nginx_access_status[1m])) > 0.03
- 进阶规则示例:
• 同一 upstream_zone 出现 5xx + upstream_response_time="-",持续 30 秒 → 判定为后端不可达
• 某个 server_name 下 5xx 突增 5 倍且绝对数>20 → 触发 P1 告警
• 多个 IP 对同一路径高频返回 403/404 → 单独归类为“扫描行为”,不计入主错误率
四、看板与告警必须共享同一数据源和计算逻辑
避免“看板显示 2.1%,告警却按 5% 触发”的割裂问题:
- Grafana 看板中的错误率曲线,应直接复用 Alertmanager 的 PromQL 表达式,保证口径一致
- 告警触发时,自动注入跳转链接,例如:https://grafana.example.com/d/nginx-err-rate?var-server=api.example.com&from=now-10m&to=now
- 点击告警通知,直接定位到对应服务的 VTS 实时状态页(/status/format/json)或 Kibana Discover 中最近 100 条 5xx 日志














