


提升集群吞吐的关键是让每台后端服务器资源用得准、稳、满;需按业务选算法(如无状态用加权轮询、长连接用least_conn)、协同调优KeepAlive、配置真实健康检查,并用大数据分析验证效果。
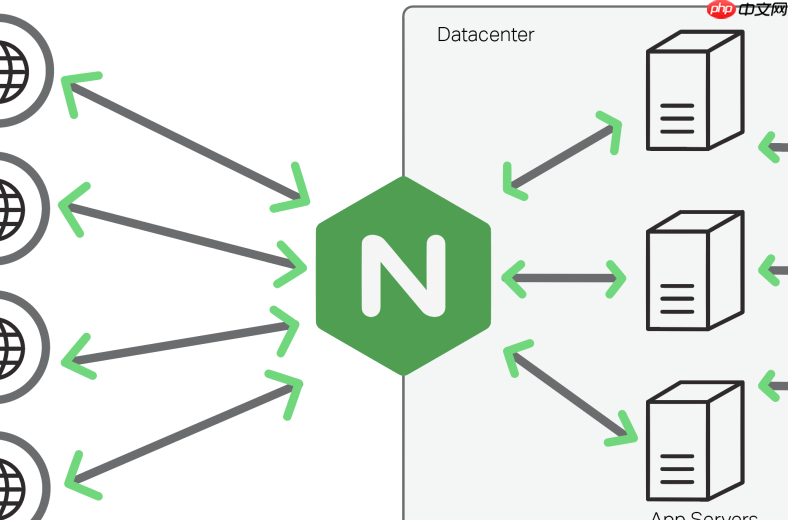
提升集群吞吐的关键,不是盲目加机器,而是让每台后端服务器的 CPU、内存、连接数都用得准、用得稳、用得满。Nginx 负载均衡器是调度中枢,算法选得对不对,直接决定资源是否被“浪费”或“压垮”。合理配置的前提,是理解业务真实特征,并用数据验证效果。
按业务类型匹配负载算法
算法本身配置简单,难点在于是否贴合流量模式和后端行为:

- 轮询(Round Robin):适合静态资源或无状态 API,所有后端软硬件配置一致时最公平;但若某台响应变慢,它仍会继续分发请求,可能加剧不均。
- 加权轮询(Weighted Round Robin):当后端性能差异明显(如 16C/64G 与 8C/32G 混布),按实测 QPS 或 CPU 吞吐能力设 weight(例如 5:2),比“凭经验估”更可靠。
- 最少连接(Least Connections):长连接场景(WebSocket、gRPC)必须用——它看的是当前 ESTABLISHED 连接数,而非请求数;否则一台机器连接堆积到上千,另一台却空闲,吞吐立刻失衡。
- IP Hash:仅在无法引入 Redis 共享 Session 时考虑;但要注意 CDN 回源 IP 集中会导致单点过热,此时应改用 $http_x_forwarded_for 或 consistent_hash。
用大数据验证算法是否真生效
配完不能就放着,要靠日志+监控回溯实际分发效果:
- 采集各后端节点 7 天内的 QPS、p95 响应时间、5xx 错误率、活跃连接数,画趋势图对比;
- 若发现 A 节点响应时间高 40% 但连接数偏低 → 很可能是慢 SQL 或 GC 卡顿,不是负载问题,加权轮询解决不了;
- 若 WebSocket 场景下 A 节点 ESTABLISHED 连接数长期是 B 的 3 倍 → 说明 least_conn 没起作用,大概率是 keepalive 配置没协同好,或后端主动断连;
- 用 access_log + Prometheus + Grafana 统计 upstream_addr 中重复地址占比,> 85% 才算连接复用真正落地。
两端 KeepAlive 必须协同调优
短连接下 TCP 握手开销可占请求总耗时 15% 以上,光配 Nginx 不行,后端也得配合:
- 客户端到 Nginx:设 keepalive_timeout 65 和 keepalive_requests 10000;
- Nginx 到后端:upstream 块中加 keepalive 32,同时确保 proxy_http_version 1.1 和 proxy_set_header Connection "";
- 后端服务(Tomcat/Node.js)keep-alive timeout 必须略大于 Nginx 的 proxy_read_timeout,否则单边断连会频繁重建连接。
健康检查要带延迟感知,不能只看通不通
一台机器返回 HTTP 200,但平均响应 2s(正常应
- 用 health_check interval=3 fails=2 passes=2,探测路径为 GET /health;
- 配合 max_fails 和 fail_timeout 实现自动摘除与平滑恢复;
- 进阶做法:每分钟采集 p95 延迟、错误率、建连耗时,加权生成 Health Score,动态调整节点权重而非简单上下线。












