


直接压测Ingress Controller本身才能真实暴露网关瓶颈,需围绕连接处理、TLS开销、资源分配和内核协同四点调优;k6是官方推荐工具,支持HTTP/2与分阶段施压,应比对Ingress Pod与后端NodePort的QPS差值以定位损耗。
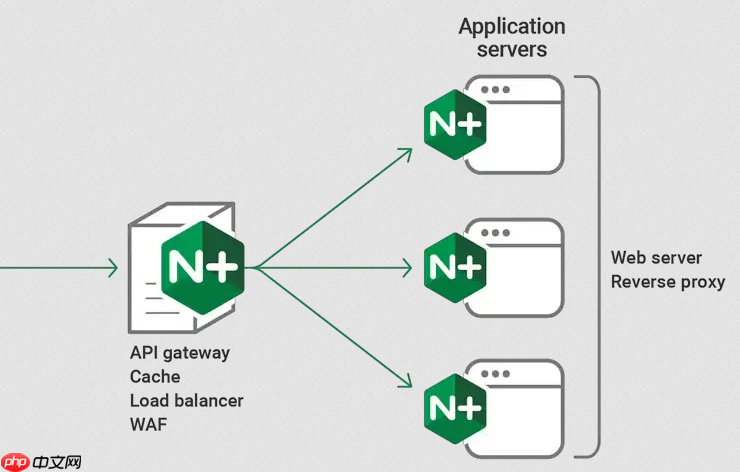
直接压测 Ingress Controller 本身,而不是只测后端服务,才能真实暴露网关瓶颈。调优要围绕连接处理、TLS开销、资源分配和内核协同四个关键点展开,不是简单堆配置。
用 k6 做真实场景压测
k6 是 ingress-nginx 官方推荐的压测工具,轻量、支持 HTTP/2 和自定义阶段,能模拟用户真实行为:
- 先写一个基础脚本,覆盖域名解析、HTTPS握手、多路径访问(如 /api/v1/users、/healthz),并设置 hosts 映射避免 DNS 干扰
- 分阶段施压:30 秒预热 → 1 分钟稳态(目标 QPS 与线上峰值对齐)→ 30 秒冲高 → 30 秒回落,观察错误率、P95 延迟和 CPU 使用率拐点
- 重点比对两个指标:Ingress Pod 的 QPS 吞吐 vs 后端 Service 直连 NodePort 的 QPS,若差值超过 30%,说明网关层存在明显损耗
精调 TLS 处理链路
HTTPS 是性能最大变量,多数吞吐下降都源于 TLS 握手与证书验证环节:

- 在 Ingress Controller 的 ConfigMap 中启用会话复用:
ssl-session-cache shared:SSL:10m和ssl-session-timeout 4h,避免每请求重握手 - 开启 OCSP Stapling:
ssl-stapling on+ssl-stapling-responder,让控制器主动缓存吊销状态,省去客户端直连 CA 的 RTT - 多个域名共用通配符证书时,统一存进一个 Secret;更新证书后确认控制器版本 ≥ 1.2.0,确保热重载生效,不重启 Pod
- 关闭非必要验证,如禁用
ssl-verify-client,除非业务强制双向认证
优化连接与缓冲机制
高频小请求下,TCP 层和 Nginx 缓冲策略直接影响吞吐稳定性:
- 调大系统连接队列:
sysctl -w net.core.somaxconn=65535,Nginx Ingress 会自动读取该值作为 listen backlog,避免新连接被丢弃 - 增大 upstream keep-alive 连接池:
upstream-keepalive-connections 2048+upstream-keepalive-timeout 60,减少后端建连开销 - 调整代理缓冲:
proxy-buffers 8 64k防止响应慢导致阻塞,ssl-buffer-size 8k匹配现代 TLS 记录大小,降低分片次数
合理分配资源与部署形态
Controller 不是“越强越好”,而是要匹配流量特征和集群拓扑:
- 副本数按峰值 QPS × 单实例承载能力估算(建议单 Pod 控制在 8k–12k QPS),至少部署 2 副本并打散到不同节点
- 不设 CPU/Memory limit,或至少保证 CPU ≥ 1000m,Memory ≥ 2Gi;OOM kill 会导致连接中断,比慢更致命
- 高负载集群建议为 Ingress Controller 划分独占节点,避免与其他组件争抢网络栈和中断处理资源
- 底层 kube-proxy 改用 IPVS 模式(
mode: ipvs),提升 Service 转发效率,尤其在大量后端 Endpoint 场景下效果明显












