


Nginx高可用需结合主动健康探针与被动检查:启用nginx_upstream_check_module,配置check指令及轻量健康接口,调优interval/timeout/rise/fall参数,可选JSON深度校验,并保留max_fails等被动机制作为兜底。
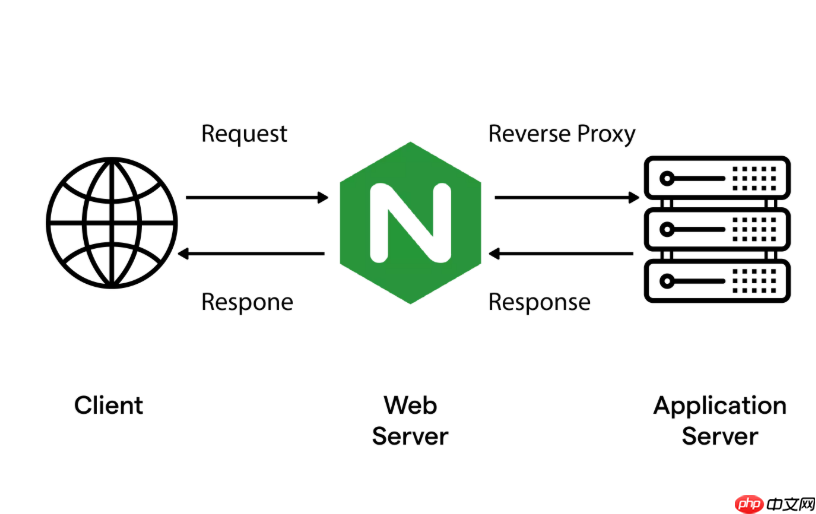
要在 Nginx 中用 upstream 实现真正可靠的高可用,不能只靠默认的被动检查,必须引入主动健康探针——它让 Nginx 自己定时“敲门”,提前发现后端异常,而不是等用户请求失败才反应。
启用 nginx_upstream_check_module 主动探测
这是目前最成熟、生产环境广泛验证的方案(淘宝开源,OpenResty 已集成):
- 需从源码编译 Nginx,添加
--add-module=/path/to/nginx_upstream_check_module;运行nginx -V | grep upstream_check确认模块已加载 - 在
upstream块中为每个后端配置check指令,例如:server 10.0.1.10:8080 check interval=2 rise=2 fall=3 timeout=1 type=http; - 必须搭配后端真实的轻量健康接口(如
/health或/actuator/health),返回 200 且响应体极小(推荐空 body 或纯文本) - 用
HEAD方法代替GET可减少后端负担,例如:check_http_send "HEAD /health HTTP/1.1\r\nHost: api.example.com\r\n\r\n";
关键参数要按场景调优
默认值容易导致误判或响应迟钝,需结合后端实际表现调整:

- interval:探测间隔。高频业务建议 1000–2000ms;普通服务设 3000ms 较稳妥;低于 2000ms 易引发多 worker 探测风暴
- timeout:单次探测超时。应略短于后端健康接口平均响应时间(如后端通常 600ms 返回,则设 800ms)
- rise / fall:连续成功 2 次才恢复上线,连续失败 3 次才摘除——兼顾灵敏度与抗网络抖动能力
-
check_http_expect_alive:明确指定有效状态,如
http_2xx http_3xx,避免把 302 重定向误判为异常
加一道深度校验防线(可选但推荐)
仅看 HTTP 状态码不够,有些服务即使宕机仍返回 200:
- 在探针响应中校验 JSON 字段,比如要求响应体包含
"status":"UP"、"db":"UP" - 用 OpenResty 的
lua-resty-upstream-healthcheck模块,或在location中写content_by_lua_block发起请求并解析 - 给探针加自定义请求头,如
X-Health-Probe: true,后端据此跳过鉴权、日志和限流,避免被拦截或拖慢
保留被动检查作为兜底保障
主动探针再强也有盲区(如 TLS 握手卡死、长连接僵死),所以不能去掉原生机制:
- 继续在
server行保留max_fails=2 fail_timeout=15s,比主动探测稍激进一点,形成双保险 - 配合
proxy_next_upstream error timeout http_502 http_504,确保单次转发失败能自动重试其他节点 - 对 backup 节点禁用主动检查(不加
check),只让它冷备兜底,防止流量误切引发雪崩











