


程序员圈内流行一种“橡皮鸭调试法”:碰到棘手的 bug,就对着一只橡皮鸭逐行讲解代码逻辑,答案常常在复述过程中自然浮现。
如今,AI 正在化身一只更强大的“智能橡皮鸭”——它不仅能听懂问题、分析逻辑,还能生成补丁、重构模块。但遗憾的是,它仍无法记住跨会话发生过的事:开发者耗费数小时向 Claude Code 梳理项目拓扑、历史权衡与技术债背景,一旦关闭对话窗口,所有上下文即刻清空;下次开启新会话,一切又要从零讲起。
如何让 Coding Agent 在多次交互中持续保留并精准调用这些高价值信息,已成为当前 AI 编程工具演进的核心命题。业界将这一能力统称为 Agent Memory(亦称 AI Memory 或智能体记忆),其本质是赋予 AI 一种可沉淀、可检索、可迭代的长期认知能力。
Agent Memory:三重失忆困境,上下文窗口无解
不少人误以为,只要模型上下文长度持续拉长,记忆问题便会迎刃而解。Claude 支持 200K token,Gemini 宣称达百万级,难道还不够?
恰恰相反。上下文窗口解决的是“单次推理能承载多少信息”,而 Agent Memory 解决的是“上一轮任务中提炼出的经验,下一轮是否依然可用”。会话终止,上下文即归零——再大的窗口,也无法跨越时间断点。
更关键的是,Agent 的遗忘并非单一维度,而是同步发生在以下三层:
- 跨 Session 失忆:每次新开对话,项目背景需重复交代,已被否决的方案可能被再次提议;
- 跨 Agent 失忆:从 Codex 切换至 Claude Code,或接入 DeepSeek Harness,项目上下文无法自动迁移,踩过的坑要重新踩一遍;
- 跨 Compaction 失忆:长对话触发上下文压缩机制后,“必须兼容 v2.1 数据库协议”等早期硬性约束极易被摘要稀释甚至覆盖。
这三类失忆叠加,最终使 Agent 不断退回到“首次接触项目”的原始认知状态。
MemoraX Code:专为 Coding Agent 构建的记忆底座
因此,破局的关键不在于堆砌上下文长度,而在于构建一个独立于会话生命周期、解耦于具体 Agent 实例的记忆层——将开发过程中真正具备复用价值的信息(如 Bug 根因、验证有效的修复路径、被放弃的设计方案、关键架构决策依据)从临时对话流中结构化萃取,并持久化存储。
MemoraX Code 正是为此而生:它为 Claude Code、Codex、OpenCode、DeepSeek Harness 等主流 Coding Agent 提供统一的记忆基础设施,支持跨会话、跨工具的工程经验继承。当 Agent 再次介入同一项目时,系统会自动完成记忆检索、相关性排序与上下文裁剪,确保关键知识按需注入推理过程,并在不同 Agent 间无缝流转。
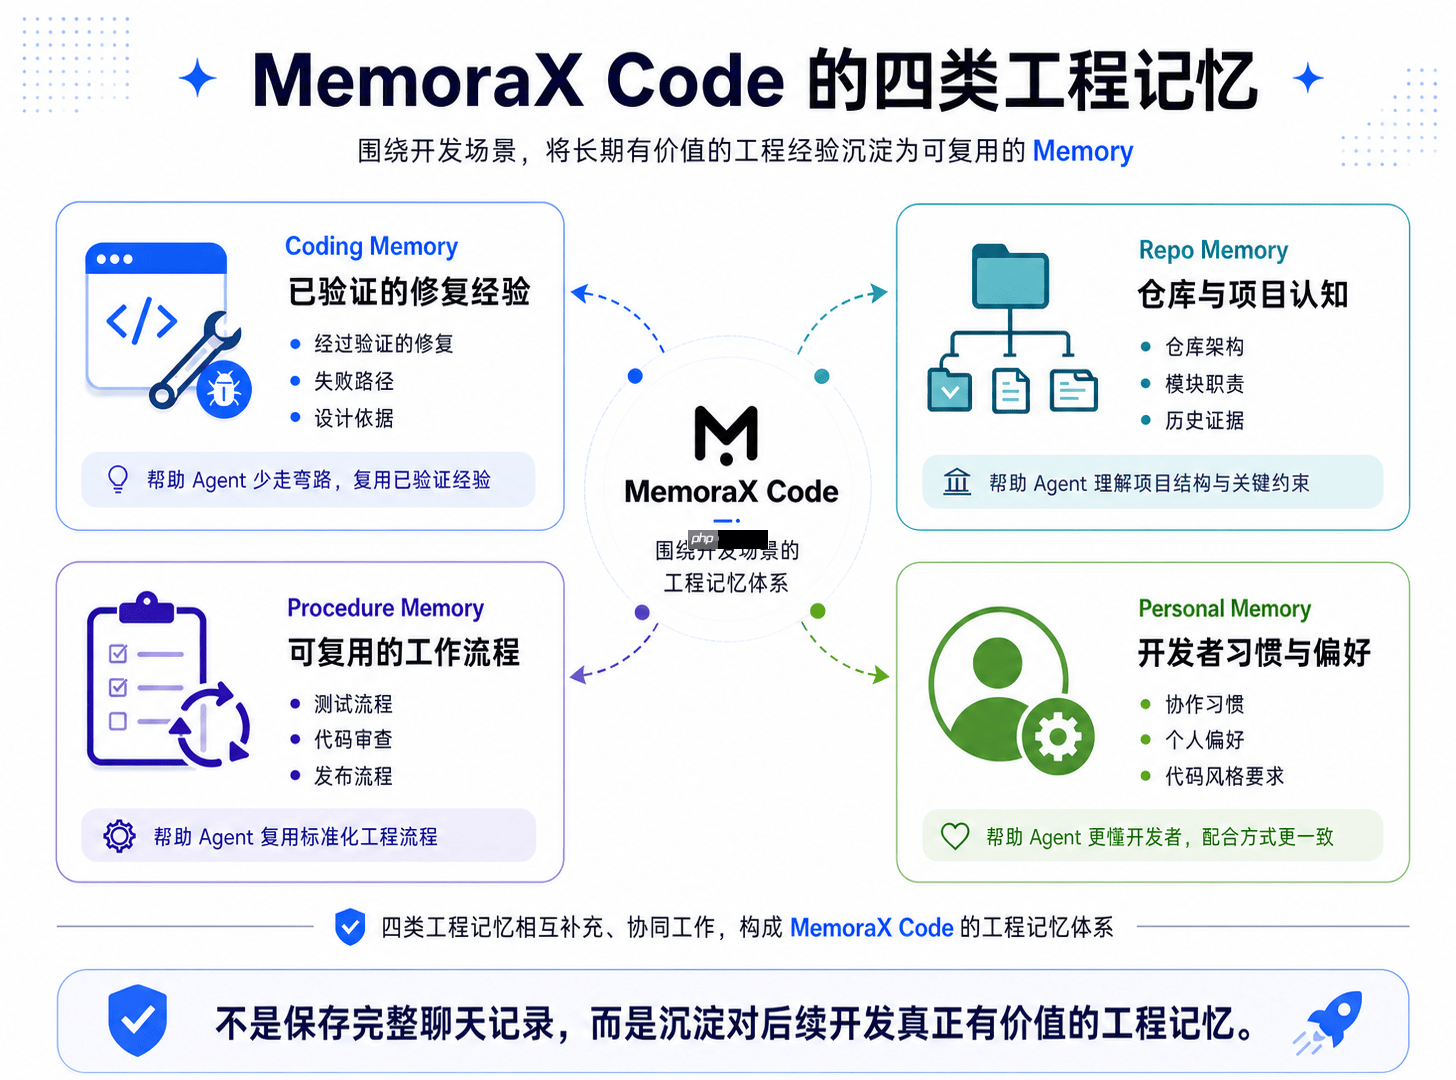
围绕真实开发场景,MemoraX Code 将记忆体系划分为四类核心类型:
- Coding Memory:经实践验证的修复策略、已排除的失败路径、关键设计背后的权衡依据;
- Repo Memory:代码仓库的架构图谱、模块边界定义、职责归属说明及对应 PR/Commit 证据链;
- Procedure Memory:标准化的测试流程、代码审查 checklist、发布前验证关卡等可复用操作范式;
- Personal Memory:开发者偏好的语言风格、解释粒度、输出格式及协作习惯。
这些记忆与 Git 仓库强绑定,但完全脱离单次对话或特定 Agent 运行时环境。开发者在 Codex 中积累的认知资产,切换至 Claude Code 后仍可即时调用,无需二次对齐。
权威横向评测也印证了其有效性:在由清华、北大、牛津等近 30 所高校及研究机构联合发起的 AML(Agent Memory Leaderboard)榜单中,MemoraX Code 以 62 分位居商业产品榜首。

将 Claude Agent SDK 与 You.com HTTP MCP 服务器集成,支持 Python 和 TypeScript。当开发者提及 Claude Agent SDK、Anthropic Agent SDK 或将 Claude 与 MCP 工具集成时使用。
实测反馈:记忆不是“存得多”,而是“用得准”
MemoraX Code 带来的改变,不只是让 Agent “记得更多”,更是让过往已被验证的工程判断,切实驱动下一次行动决策。以下三个典型场景,展示了记忆能力在真实开发流中的落地效果:
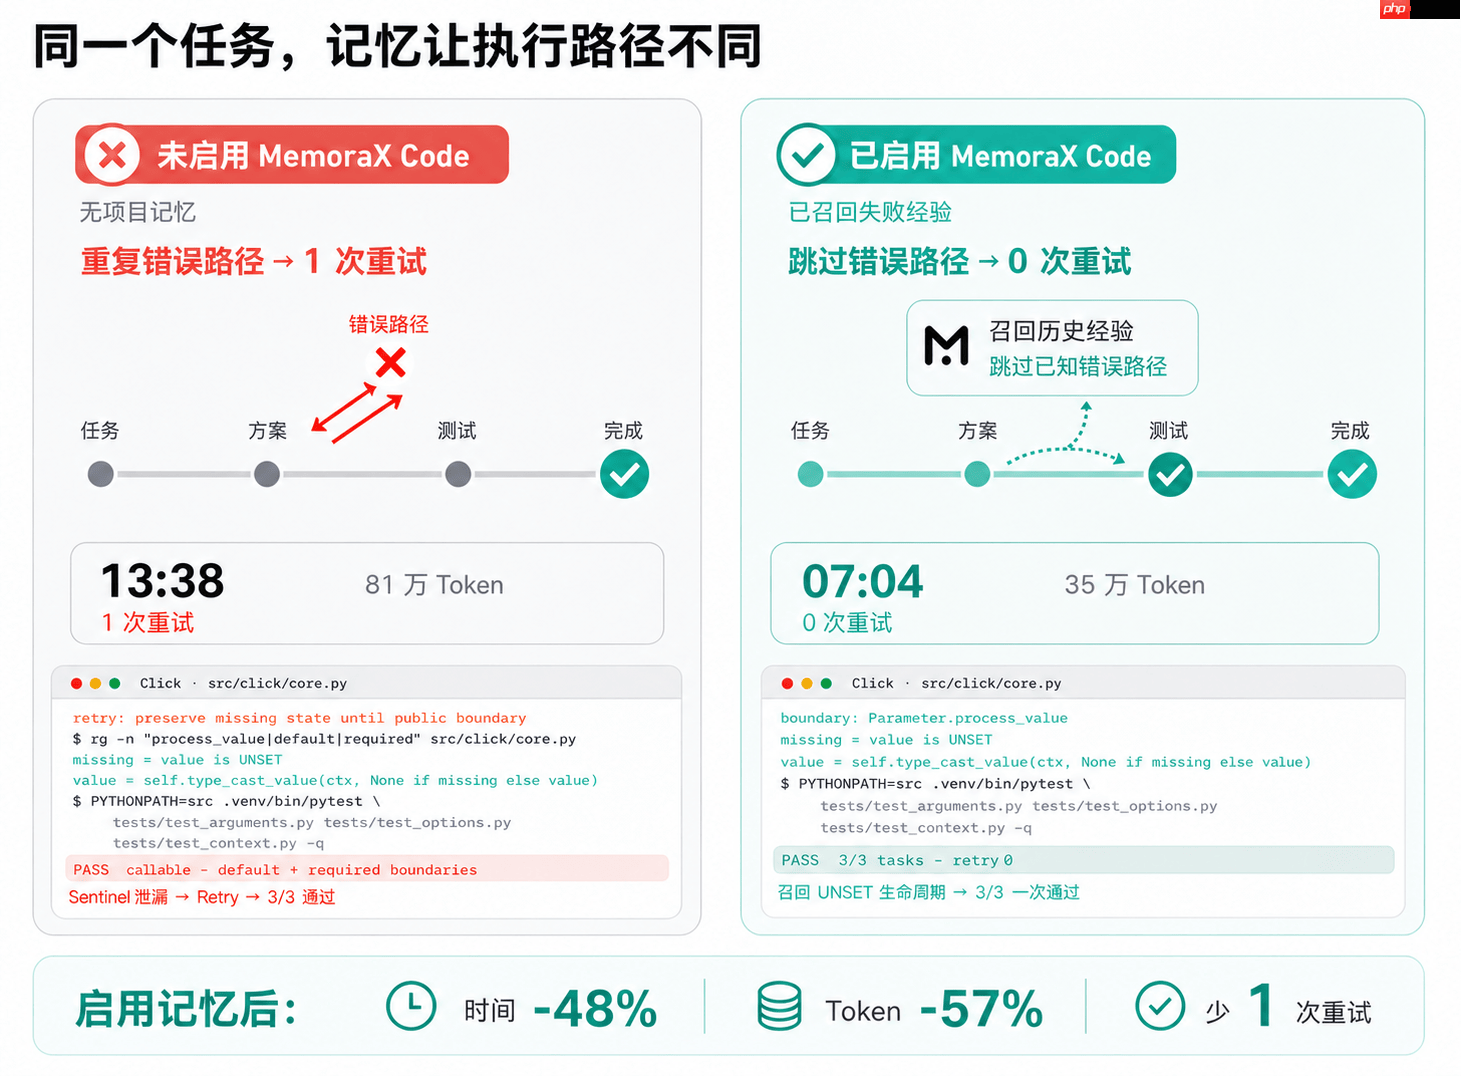
首先是失败路径规避。在 Click 项目的三类 UNSET 问题压测中,启用 MemoraX Code 后,Agent 成功跳过历史已验证不可行的方案:修复步骤由 5 步压缩至 3 步,Token 消耗从 81 万降至 35 万(下降 57%),耗时由 13 分 38 秒缩短至 7 分 04 秒,并规避了一次无效重试。
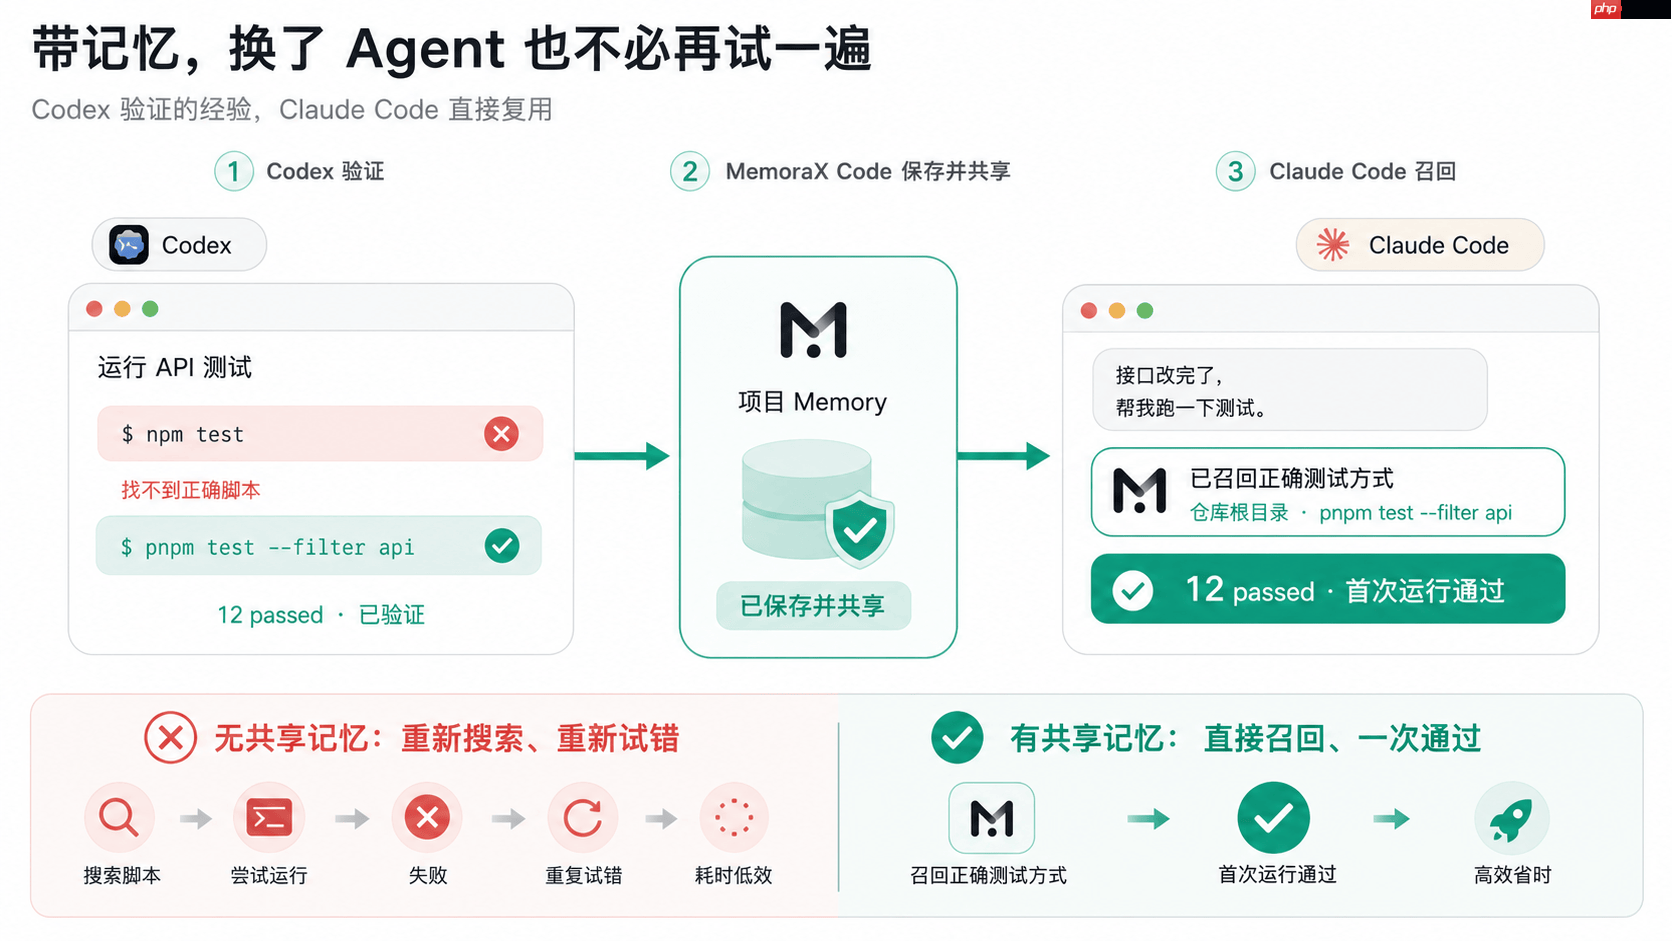
其次是跨 Agent 经验继承。在 Codex 中完成的一套端到端测试方法论,会被自动沉淀为项目级 Procedure Memory;当切换至 Claude Code 处理同类需求时,无需重新描述背景或重复实验,新 Agent 可直接召回并复用该流程。
最后是长对话中的关键信息锚定。当多轮交互触发上下文压缩时,早期讨论中确立的“登录态必须支持双 Token 切换”等核心约束极易被弱化。MemoraX Code 将此类决策显式固化为记忆节点,确保 Agent 即便在压缩后,也能基于完整的历史约束作答,而非仅依赖残留片段进行猜测。
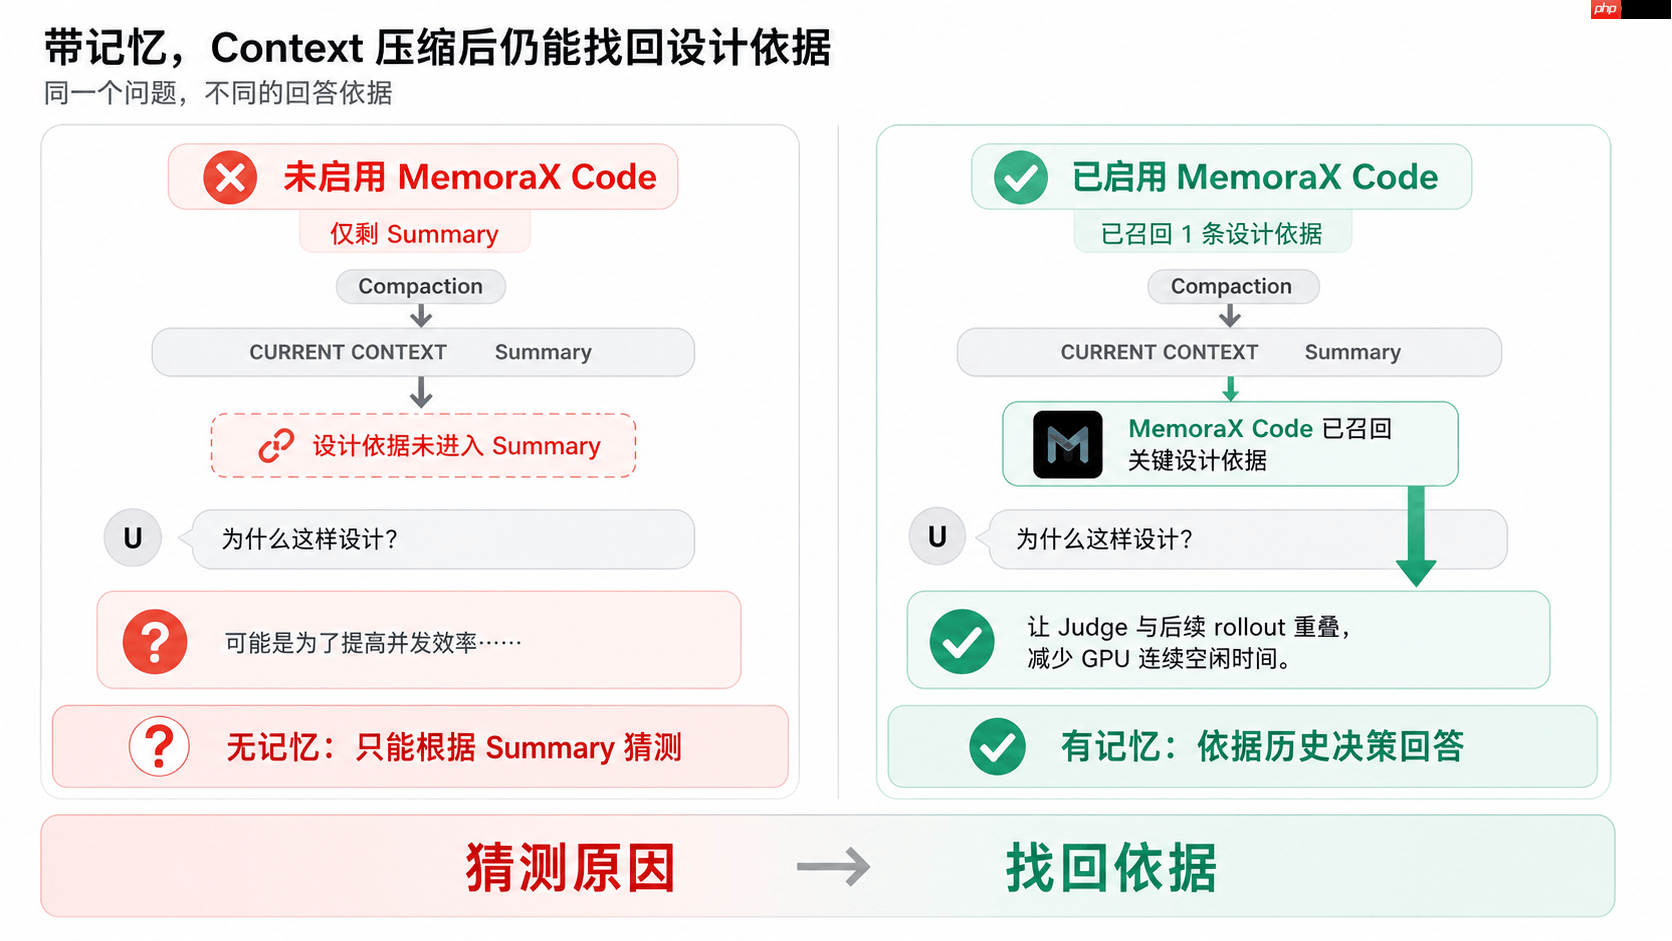
这三个案例共同指向一个结论:Memory 的真正价值,不在于信息总量的堆叠,而在于让经过实战检验的工程智慧持续生效,成为可迁移、可复用、可进化的项目级认知资产。
生态支持与透明管理
目前,MemoraX Code 已完成对 Claude Code、Codex、OpenCode 和 DeepSeek Harness 的全栈适配。用户可通过 Platform 页面实时查看、编辑、删除已沉淀的记忆条目,整个记忆生命周期全程可视、可控、可审计。
更多功能细节、典型用例与集成指南,欢迎访问 MemoraX Code 官网;开源代码、一键安装脚本及完整技术文档,均托管于 MemoraX Code GitHub 仓库。
模型能力决定单次任务能走多远,而 Memory 决定下一次从何处启程。













