


健康检查策略是否合理取决于响应的准确性、稳定性和时效性;需通过日志过滤确保健康检查请求不干扰业务分析,并验证upstream_status与响应时间是否符合快速、稳定返回2xx的预期。
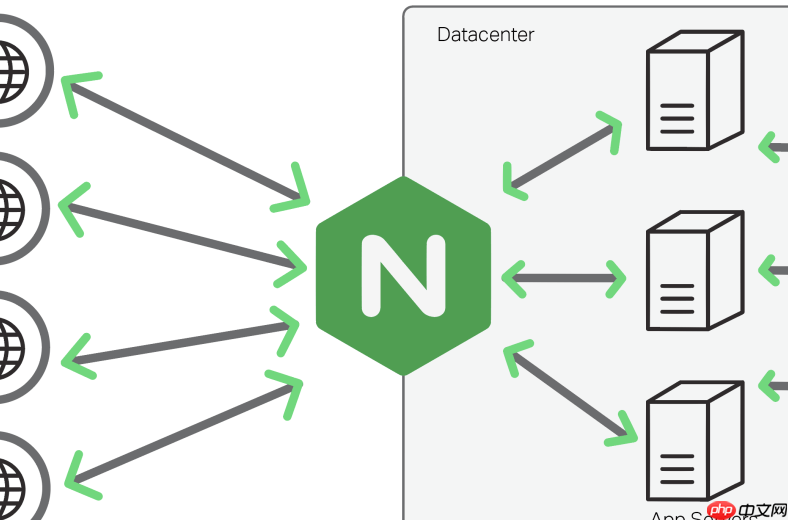
直接看日志里健康检查请求的响应表现,就能判断策略是否合理——不是看“有没有发”,而是看“发得准不准、回得稳不稳、剔得及时不及时”。
看健康检查请求是否被正确识别和过滤
如果健康检查路径(如 /health、/ping)或 User-Agent(如 HealthCheck、Kubernetes)频繁出现在 access 日志中,说明日志过滤没生效。这会干扰真实业务分析,也掩盖了健康检查本身的异常。
建议在 http 块中用 map 定义 $loggable 和 $loggable_ua,再通过 "$loggable:$loggable_ua" 合并为 $loggable_final,最后在 access_log ... if=$loggable_final 中启用条件记录。这样日志里只留真实用户流量,健康检查请求彻底静默。

查 upstream_status 与响应时间是否匹配预期
健康检查本身是探测行为,理想状态是:快速返回 2xx,且 $upstream_status 稳定、$upstream_response_time 极低(通常
-
upstream_status为 502/503/504 或 -(空值),说明后端根本没响应或网关异常; -
upstream_response_time > 1s但$status == 200,说明健康接口虽通但已变慢,可能预示后端资源紧张; - 同一后端 IP 在短时间集中出现失败,而其他节点正常,指向该节点局部异常。
验被动剔除是否及时反映在日志分布中
Nginx 内置的被动健康检查靠 max_fails + fail_timeout 触发。验证它是否有效,就看日志里某台后端的错误请求是否在连续失败后突然归零——同时其他节点请求量同步上升。
例如配置 server 10.0.1.10:8080 max_fails=3 fail_timeout=30s,那么在日志中应观察到:
- 前 3 次请求中出现
upstream_status 502或超时; - 随后 30 秒内,该 IP 几乎不再出现在
$upstream_addr字段中; - 同一时段,其他 upstream 地址请求量明显增加。
比对主动检查日志与代理请求日志的一致性
如果用了 nginx_upstream_check_module 等主动检查模块,它会把探测结果写入独立日志(如 check.log)。此时需交叉比对:
- 主动日志中标记某节点 down 的时间点,是否与后续代理日志中该节点请求消失的时间一致;
- 主动日志中恢复 up 的时刻,是否对应代理日志中该节点请求重新出现;
- 主动检查间隔(如
interval=5s)是否与实际探测频率吻合,避免因配置偏差导致漏检或过载。










