


直接在upstream块server行后写weight=正整数即可按硬件能力比例分配流量,必须定义在http块内、server外的upstream中且紧贴IP:端口,需结合CPU核数或压测QPS设定合理整数比,并搭配max_fails/fail_timeout等健康检查机制才能真正生效。
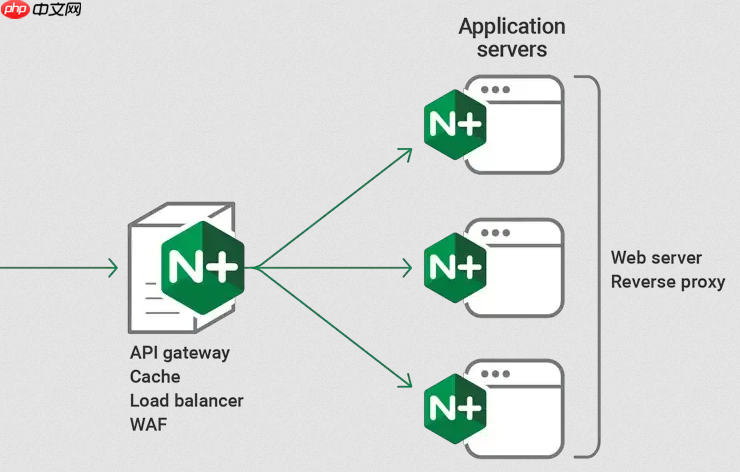
直接在 upstream 块的 server 行后写 weight=正整数,就能按硬件能力比例分配流量——不是平均分,而是强机多扛、弱机少分,关键在数值设得准、位置写得对、配套配得全。
权重必须写对位置才生效
weight 只能在 http{} 块内、所有 server{} 外的 upstream 中定义,且紧跟在 server IP:端口 后面:
- ✅ 正确:
upstream app { server 192.168.1.10:8080 weight=6; } - ❌ 错误:把
upstream塞进server或location里 - ❌ 错误:绕过
upstream,直接proxy_pass http://192.168.1.10:8080,权重完全不生效 - ❌ 错误:漏写
http://协议头,如proxy_pass my_backend
怎么定出贴合硬件的 weight 数值
别拍脑袋填数字,用可测指标折算,推荐两种实操方式:

-
按 CPU 核心数粗估:新服务器 16 核、旧服务器 4 核 → 初始 weight 比例为 16:4 = 4:1,可设为
weight=4和weight=1 -
按压测 QPS 精调:用
wrk -t4 -c100 -d30s http://192.168.1.10:8080/health分别测试,若结果为 1200 QPS 和 300 QPS,则设weight=4和weight=1 - 数值统一放大 10 倍更稳(如 40:10 而非 4:1),减少低并发下因连接复用导致的偏差
- 避免用太小的数(如 1 和 2)或过大悬殊(如 95 和 5),建议控制在 1–100 整数范围内
必须搭配健康机制,否则权重只是摆设
weight 只管“正常时怎么分”,不管“出问题了怎么办”:
- 加
max_fails=2 fail_timeout=30s:连续失败 2 次就暂停转发,故障期间剩余节点按各自 weight 重新归一化分担 - 新机器上线加
slow_start=30s:让流量从零缓慢爬升,防冷启动冲击 - 旧机临时下线可设
weight=0:仍接受健康检查,不删配置,恢复时改回即可 - 别和
ip_hash混用——两者冲突,weight 会失效;如需会话保持又想要权重,改用hash $remote_addr consistent;
上线后必须验证实际分发是否符合预期
配完 reload 不代表调好了,要盯住三项真实指标:
- 查
access.log中各后端 IP 的请求计数,计算实际占比是否在设定值 ±5% 内 - 看后端 CPU 使用率,目标是各节点稳定在 60%–75%,过高说明 weight 偏大,过低则偏小
- 观察 P95 响应时间,若高 weight 节点延迟反升,可能是过载,需下调 weight 或排查应用瓶颈









