





彻底消除集群负载倾斜需系统性配置:无状态服务用加权轮询,有状态服务用一致性Cookie哈希,长连接用least_conn,延迟敏感型需主动健康检查+自定义延迟监控,并避开ip_hash与weight混用等陷阱。
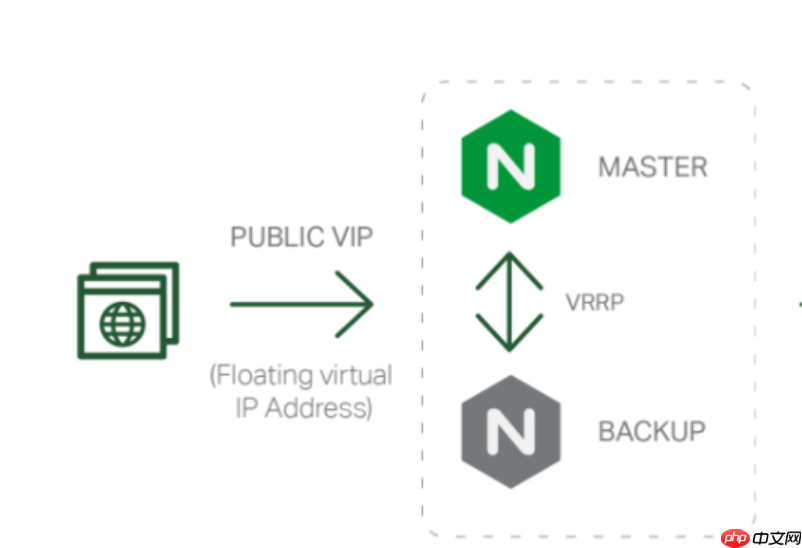
彻底消除集群负载倾斜,不能靠单一算法“一招鲜”,而要结合业务特征、节点能力差异、连接生命周期和健康状态做系统性配置。关键不是追求理论上的绝对均衡,而是让流量分布与后端真实处理能力匹配,避免某台机器 CPU 持续 95% 而其他空转。
按业务类型选准核心算法
不同服务对“负载”的敏感维度不同,硬套默认轮询反而加剧倾斜:
-
无状态短连接服务(如 REST API、静态资源):用加权轮询(
weight),权重按 CPU 核数 × 内存 GB 数粗略估算。例如新机器 16 核 64GB 设weight=8,旧机器 8 核 32GB 设weight=4,比均等轮询更贴近实际吞吐能力。 -
含会话状态的服务(如登录态、订单页):禁用
ip_hash单独使用,改用hash $cookie_sessionid consistent;(需编译支持一致性哈希),避免扩容时大量用户会话失效;若必须用 IP,应配合$http_x_forwarded_for替代原始 IP,缓解代理集中问题。 -
长连接服务(如 WebSocket、gRPC):必须启用
least_conn,它统计的是活跃连接数而非请求数,能真实反映后端连接池压力,防止某节点堆积上千空闲连接却持续收新请求。 -
延迟敏感型(如实时风控、搜索建议):原生 Nginx 不支持响应时间动态调度,需引入
nginx-upstream-check-module,每 2 秒探测/healthz,连续失败 3 次才标记为 down,并搭配自定义脚本上报后端 P95 延迟,供离线调优参考。
让健康检查真正驱动流量调度
被动检查(靠请求失败触发)会导致故障窗口长达数十秒,是负载倾斜的主因之一:

- 在
upstream块中显式配置max_fails=3 fail_timeout=20s,避免单次超时就踢出节点;同时启用主动 HTTP 探活,例如check interval=3 rise=2 fall=3 timeout=1(需第三方模块)。 - 后端健康接口必须轻量:返回
200 OK+ 简单 JSON(如{"status":"up"}),禁止调用数据库或远程依赖,否则健康检查本身会成为压测源。 - 对直连 MySQL Proxy 或 Redis Sentinel 的场景,改用
tcp_check,仅验证端口连通性,耗时低于 5ms,比 HTTP 更稳更快。
避开高频导致倾斜的配置陷阱
这些细节不报错,但上线后极易引发隐性漂移:
-
禁止混用
ip_hash和weight:Nginx 会直接忽略权重,所有哈希请求固定打到某台,权重形同虚设。 -
扩容节点时慎用
ip_hash:加一台 server 会导致约 1/N 的客户端哈希重映射,会话中断。生产环境建议用 Cookie 哈希或外置 session 存储(如 Redis)解耦。 -
proxy_pass尾部斜杠必须严格匹配:写成proxy_pass http://backend/;会强制重写 URI,导致后端收到错误路径(如/api/v1/变成/v1/),引发 404 或逻辑错乱,间接造成部分节点请求失败率飙升被踢出。
验证与闭环监控不可少
配置生效≠效果达标,需建立可观测闭环:
- 用
curl -I多次请求,检查响应头中Server字段是否按预期分布;再用ab或hey压测,观察各后端ActiveConn和Requests是否与权重比例基本一致。 - 通过 Nginx stub_status 模块暴露
Active connections、Reading/Writing/Waiting等指标,接入 Prometheus + Grafana,设置告警:某节点Active connections > 2×平均值持续 1 分钟即触发排查。 - 定期导出 access log 中
$upstream_addr字段,统计各节点请求占比偏差(标准差 >15% 视为异常),结合扩容节奏反向校验权重设置是否合理。














