


看到504或“upstream timed out”即可确定问题出在Nginx等待后端响应环节,需实时捕获日志、提取upstream地址/客户端IP/请求URI/超时阶段四字段,结合access.log中$request_time与$upstream_response_time对比,并验证后端实测耗时及Nginx超时参数配置。
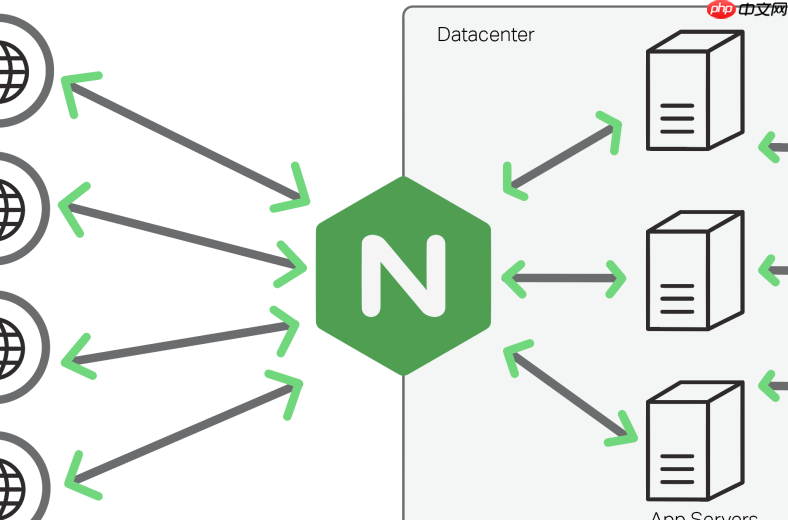
看到 504 Gateway Timeout 或 error.log 里反复出现 "upstream timed out",基本可以确定问题出在 Nginx 等后端响应这一步——不是客户端慢,也不是 Nginx 崩了,而是它发完请求后,迟迟没等到后端回话。
快速锁定超时日志并提取关键线索
别等用户反馈再查。用命令实时盯住源头:
-
tail -f /var/log/nginx/error.log | grep -i "upstream timed out"—— 最直接的实时捕获方式 - 加时间过滤更精准:
awk '/2026\/08\/21.*upstream timed out/' /var/log/nginx/error.log - 若用 systemd 管理 Nginx:
journalctl -u nginx -f | grep -i "upstream timed out"
一条典型日志里藏着四个关键字段,必须立刻抓出来:
-
upstream 地址:如
http://backend-svc:8080/v2/pay→ 指向具体服务与接口 -
client IP:如
10.20.30.40→ 判断是否来自某台调用方、爬虫或特定区域 -
request URI:如
/v2/pay→ 和 access.log 对齐,查该路径历史耗时趋势 -
超时阶段描述:如
while reading response header from upstream→ 明确后端已收请求但未发响应头,排除连不上、也排除传体慢
用 access.log 验证真实耗时瓶颈
error.log 只说“超时了”,access.log 才告诉你“到底卡了多久”。前提是你的 log_format 包含关键变量:
- 确保配置了:
log_format main ... '$request_time $upstream_response_time $upstream_addr'; - 找同一连接 ID(如日志里的
*7890)在 access.log 中的对应行 - 重点看末尾两个数字:
60.123 128.456→ 前者是 Nginx 总耗时,后者是后端真实响应时间
如果 $upstream_response_time 接近或等于 proxy_read_timeout(比如都是 60),说明后端真卡住了;如果它远小于 timeout 值但依然报 504,则可能是网络抖动、重试失败或后端提前断连。

交叉验证后端状态与 Nginx 超时配置
不能只看日志就调大 timeout——先确认是不是后端本身的问题:
- 绕过 Nginx 直连后端:
curl -w "\n%{time_total}\n" -s http://backend-svc:8080/v2/pay,看实测耗时 - 检查后端资源:CPU、内存、线程池、数据库连接数、慢查询日志
- 查当前生效的 Nginx 超时值:
nginx -T 2>/dev/null | grep -E "proxy_(connect|send|read)_timeout"
重点关注三项参数是否匹配业务实际:
-
proxy_connect_timeout:建连超时,一般设 5–10 秒 -
proxy_send_timeout:发完请求后等后端接收完成,30–60 秒较稳妥 -
proxy_read_timeout:最常触发 504 的项,应略大于后端 P99 响应时间(如后端最长 120 秒,可设为 180)
区分 504 和 502,避免误判方向
504 和 502 都是网关错误,但根因完全不同:
- 504:Nginx 成功连上后端,后端收了请求但迟迟不给响应 → 查后端性能、慢查询、锁、GC
- 502:Nginx 连不上后端(服务宕、端口不通、socket 文件缺失)或后端返回非法响应 → 查后端进程、端口监听、协议兼容性
日志中若带 Connection refused 或 No route to host,基本就是 502;若明确写 upstream timed out,就专注排查后端处理链路和 Nginx 等待策略。











