


核心是Nginx提前摘流并保障draining:通过动态服务发现解耦IP、主动健康检查识别503下线信号、proxy_read_timeout留出处理时间、keepalive复用连接、proxy_ignore_client_abort容忍中断,容器侧需关闭新入口并等待连接归零。
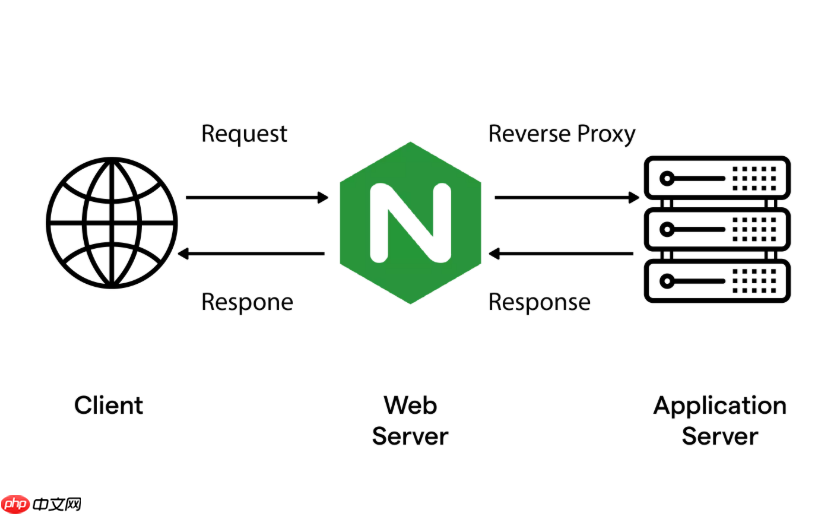
要让 Nginx 负载均衡器配合容器生命周期实现真正优雅的下线,核心不是等容器“消失”,而是让 Nginx 在容器开始退出前就停止派发新请求,并给它留出处理完存量连接的时间。这需要 Nginx 配置、容器行为、以及两者之间的协作信号三者对齐。
用动态服务发现替代静态 IP 地址
容器 IP 经常变化,硬写 server 192.168.x.x:8080 会立刻失效。必须解耦地址与配置:
- 在 Kubernetes 中,直接使用 nginx-ingress controller——它监听 Endpoint 变化,自动同步 upstream,无需人工干预
- 在 Docker Swarm 或自建集群中,用 consul-template 或 confd 监听服务注册中心(如 Consul/Etcd/Nacos),生成 Nginx 配置并热重载
- 若只能用原生 Nginx,可用
resolver+ 变量域名方式(如proxy_pass http://$backend_service),配合 DNS TTL 控制刷新频率,但更新延迟较高,仅适合低频变更场景
配置主动健康检查识别“准备退出”状态
容器下线不是突然断连,而是有明确的就绪/退出阶段。Nginx 需能感知这个信号:

- 后端容器暴露
/health/ready接口,正常返回 200;准备下线时主动返回 503 Service Unavailable - 启用 nginx_upstream_check_module(需编译支持),在 upstream 块中配置:
check interval=3 rise=2 fall=3 timeout=1 type=http;check_http_send "GET /health/ready HTTP/1.1\r\nHost: example.com\r\n\r\n";check_http_expect_alive http_2xx http_5xx; - 配合
max_fails=1 fail_timeout=10s,确保探测失败后快速标记节点为 down,避免流量打过去再失败
调整代理参数保障 draining 时间窗
摘流只是第一步,关键是要让已建立的连接自然完成:
- 设置 proxy_read_timeout 60s(或更长,按业务最长耗时定),防止 Nginx 过早中断后端正在处理的请求
- 开启 keepalive 32(在 upstream 块内),复用连接,减少后端重建压力
- 启用 proxy_ignore_client_abort on,避免用户关闭页面导致 Nginx 提前终止后端仍在运行的任务
- 使用 proxy_http_version 1.1 和 proxy_set_header Connection "keep-alive",支持长连接复用
容器侧配合:控制入口关闭节奏
Nginx 不会主动等待,真正决定是否安全的是容器自身行为:
- 收到
SIGTERM后,立即关闭新请求入口:Spring Boot 可调/actuator/refresh或停用 Tomcat connector;Go Gin 可调srv.Shutdown()并等待 - 保持已有连接可读写,不强制 close,让活跃连接自然归零
- 通过
stub_status(如location /status { stub_status; })监控 Active connections,确认归零后再退出进程 - 若用 systemd 管理容器,配置
TimeoutStopSec=60和ExecStop=/bin/sh -c 'kill %p && sleep 1 && kill -0 %p 2>/dev/null || true',避免被强制 kill











