


PHP-FPM高可用核心是Nginx智能转发至健康实例,需多实例部署、Nginx健康探测、Web与PHP层隔离、故障快速恢复。
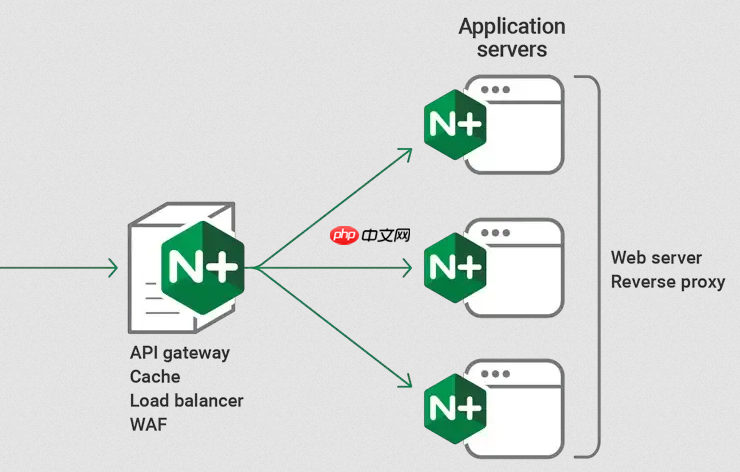
PHP-FPM 本身不是分布式服务,无法像数据库那样天然支持多节点集群,但在生产环境中实现其高可用,核心思路是:**让 Nginx 能持续、智能地将 PHP 请求转发给健康、可用的 PHP-FPM 实例**,同时配合架构分层与故障隔离。这不是“PHP-FPM 集群”,而是“PHP-FPM 服务池 + 健康感知的反向代理层”。
1. 多实例部署与进程管理优化
单台服务器上运行多个 PHP-FPM 池(pool),或在多台应用服务器上各自部署独立的 PHP-FPM 服务,是基础前提:
- 每个 pool 使用独立的 Unix socket(如
/run/php/www-pool.sock)或端口(如127.0.0.1:9001),避免资源争用 - 配置
pm = dynamic或pm = ondemand,结合pm.max_children、pm.start_servers等参数匹配实际负载(例如 4核8G 服务器建议pm.max_children=50) - 启用
slowlog和request_terminate_timeout,防止慢脚本拖垮整个 pool - 所有 pool 启用
catch_workers_output = yes,便于捕获 stderr 日志排障
2. Nginx 层实现后端 PHP-FPM 的健康探测与自动剔除
Nginx 官方不原生支持 HTTP 级别健康检查,但可通过以下方式补足:
- 使用 第三方模块 ngx_http_upstream_check_module(需编译安装),对 PHP-FPM 的 FastCGI 端口做 TCP 连通性检测
- 更推荐方案:在每台 PHP-FPM 服务器上部署一个轻量级 HTTP 健康探针(如用 Python/Go 写个
/healthz接口),返回 200 表示 PHP-FPM 进程池响应正常;Nginx upstream 配置health_check指向该接口 - 配置示例:
upstream php_backend {
    zone php_servers 64k;
    server 192.168.1.10:8080 max_fails=3 fail_timeout=30s;
    server 192.168.1.11:8080 max_fails=3 fail_timeout=30s;
    health_check interval=5 fails=2 passes=2 uri=/healthz;
}
3. 架构分离:Web 层与 PHP 应用层物理/网络隔离
这是提升整体可用性的关键设计,避免单点故障蔓延:

立即学习“PHP免费学习笔记(深入)”;
- Nginx 负载均衡节点(可双机 Keepalived VIP)只负责 TLS 终结、静态资源、路由和反向代理,不运行 PHP
- PHP-FPM 实例部署在独立的应用服务器集群中,与 Web 层通过内网通信(如 FastCGI over TCP 或 Unix socket via NFS/sshfs 共享代码,但更推荐容器化或同步分发)
- 数据库、缓存(Redis)、对象存储等全部外置,PHP 应用无状态化,任意节点宕机不影响会话延续(session 存 Redis)
- 若使用 Kubernetes,直接用 Service + Deployment 管理 PHP-FPM Pod,由 kube-proxy 或 Ingress Controller 自动完成服务发现与健康转发
4. 故障快速恢复与发布保障
高可用不仅是“不挂”,更是“挂了能秒级恢复”:
- PHP-FPM 配置变更后,用
systemctl reload php-fpm实现零停机重载(需确保pm.start_servers设置合理) - 配合 CI/CD 流水线,新版本 PHP 应用上线前自动触发 smoke test(调用 /healthz + 关键业务接口),失败则自动回滚
- 所有 PHP-FPM 服务器统一配置管理(Ansible / SaltStack),确保日志路径、OPcache 设置、错误报告等级完全一致
- 强制启用 OPcache 并设
opcache.validate_timestamps=0(配合部署时 touch opcache reset 文件),避免文件变更引发性能抖动
不复杂但容易忽略:真正的高可用不在单个组件多强,而在于每一层都有明确的边界、可观测性和快速止损能力。Nginx + PHP-FPM 的高可用,本质是一套协同工作的服务治理策略。












