





proxy_next_upstream是Nginx实现后端故障自动切换的核心机制,需显式配置error、timeout、http_502/503/504等错误类型,并配合proxy_next_upstream_tries、proxy_next_upstream_timeout及upstream中max_fails/fail_timeout健康检查才能安全生效。
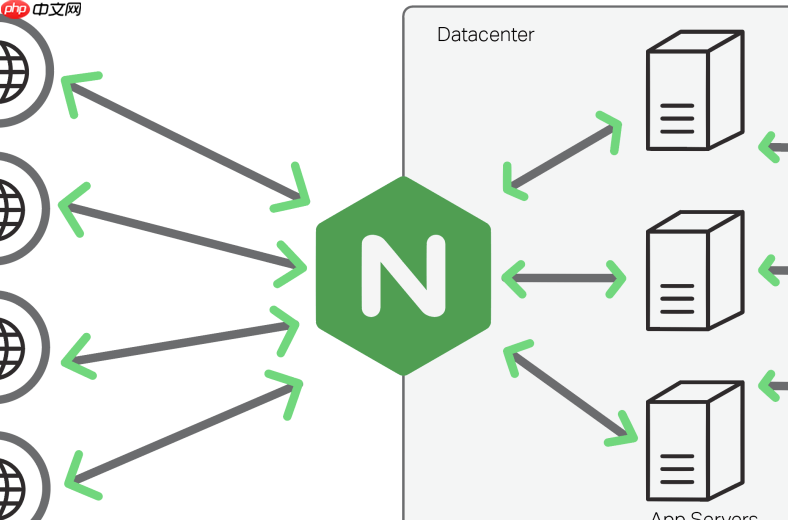
302 重定向本身不用于后端故障时的节点切换——它是一种客户端跳转机制,由浏览器执行,无法实现服务端内部的“平滑故障转移”。真正负责后端节点自动切换的是 proxy_next_upstream 机制,配合健康检查与上游配置。所谓“用 302 引导到备用节点”,实际是概念混淆;正确的做法是在反向代理层拦截失败请求,内部重试其他节点,用户无感。
别用 302 做故障切换,用 proxy_next_upstream 才对
当后端某台服务器宕机或返回 502/503/504,Nginx 不该让用户看到错误页或跳转到另一个域名,而应立即把请求转发给健康的节点:
- 在
upstream块中定义至少两个主节点,例如:upstream backend {<br> server 192.168.1.10:8080 max_fails=2 fail_timeout=5s;<br> server 192.168.1.11:8080 max_fails=2 fail_timeout=5s;<br>} - 在
location中启用重试逻辑:proxy_next_upstream error timeout http_502 http_503 http_504;<br>proxy_next_upstream_tries 2;<br>proxy_next_upstream_timeout 10s;
- 这样首次请求失败后,Nginx 自动选下一个节点重发,整个过程对用户透明,地址栏不变,也不触发浏览器跳转
如果真要“引导用户”,那是降级页面,不是切节点
当所有后端都不可用时,可统一返回一个静态维护页(非跳转),避免暴露错误细节:

- 配置一个本地 fallback 服务:
server 127.0.0.1:8081 backup;(放在 upstream 块末尾) - 运行一个轻量 HTTP 服务(如 Python http.server 或 Nginx 静态页)监听 8081,返回
/maintenance.html - 此时用户看到的是友好提示页,而非 502 错误,也无需 302 跳转——更稳定、更快、SEO 友好
为什么不能靠 302 实现节点切换?
因为 302 是返回给浏览器的状态码,意味着:
- 用户浏览器会发起第二次请求,增加延迟和失败风险
- POST 等非幂等请求可能被重复提交(浏览器常自动重发)
- 需要额外维护多个可访问的备用域名或路径,运维复杂度高
- 无法控制重试次数、超时、失败判定逻辑,远不如
proxy_next_upstream精准可靠
验证是否生效的关键动作
不要只看配置是否写对,要实测行为:
- 临时停掉一台后端服务,用
curl -v http://your-domain/api/test观察响应是否仍成功,且Server头来自另一台 IP - 检查 Nginx error log,搜索
upstream failed和next upstream日志,确认重试发生 - 模拟网络超时:在某节点上用
iptables -A OUTPUT -p tcp --dport 8080 -j DROP,验证是否快速切走











