


Nginx 中 UA 拦截必须放在 server 块顶层而非 location 内,推荐用 http 块 map 定义 $blocked_ua 变量,server 块中 if($blocked_ua) return 403;敏感路径应配合 limit_req 限流,robots.txt 需精确匹配并设 MIME 类型。
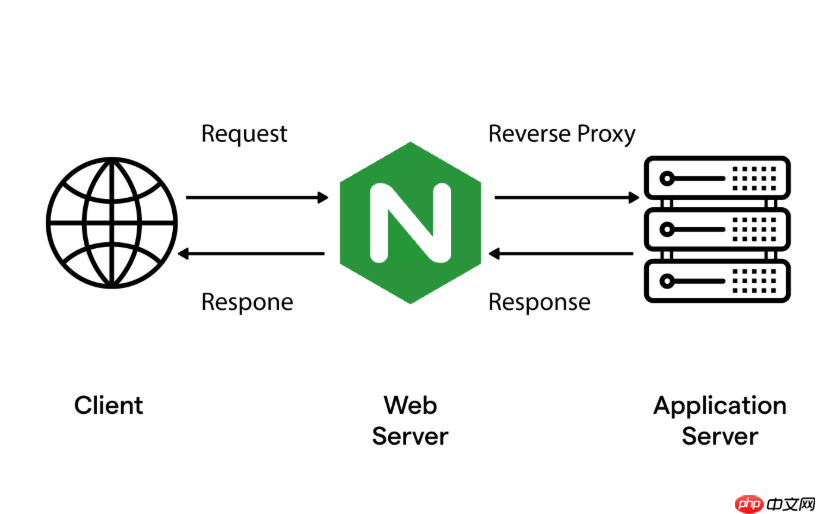
在 Nginx 的 location 配置中,**不能直接用 if 判断 User-Agent 来拒绝恶意爬虫**——这不是写法问题,而是 Nginx 架构限制:if 在 location 块内属于伪指令,极易被 proxy_pass、fastcgi_pass 或 try_files 覆盖或跳过,90% 的此类配置实际不生效。
真正有效的 UA 拦截必须放在 server 块顶层
拦截逻辑需脱离 location,置于 server { 开头、listen 和 server_name 之后、所有 location 之前。推荐用 map + if 组合,兼顾性能与可靠性:
- 在
http块中统一定义黑名单变量(一次解析,全局复用):
default 0;
~* (sqlmap|nikto|gobuster|nuclei|acunetix|whatweb) 1;
~* (python-requests|curl|wget|httpie|Go-http-client) 1;
~* (scanner|crawler|exploit|pentest|vuln) 1;
~* (^$|^\s*$|^-$) 1;
}
- 在对应
server块中启用拦截:
return 403 "Access denied.";
}
返回带提示的 403,既利于日志识别,又不暴露后端细节。
location 内可做的强化动作是限流,不是 UA 判断
对已知高危路径(如 /api/、/admin、/wp-login.php),应在对应 location 中启用 limit_req,从请求频率层面硬拦截:

- 在
http块定义限流区(按 IP):
- 在敏感
location中启用并拒绝超额请求:
limit_req zone=api_limit burst=2 nodelay;
limit_req_status 503;
# 后续 proxy_pass 或 fastcgi_pass
}
burst=2 nodelay 表示允许瞬时最多 5 次请求(3 基础 + 2 缓冲),超限立即返回 503,不排队等待。
robots.txt 是补充,不是防线
恶意爬虫基本无视 robots.txt,但它对合规搜索引擎仍有价值。必须用精确匹配,避免误伤:
- 配置必须写成:
location = /robots.txt(等号不可省) - 明确声明 MIME 类型:
default_type text/plain; - 内容按“具体 UA → 泛化 UA”顺序排列,
User-Agent: *放最后
default_type text/plain;
return 200 "User-Agent: Baiduspider\nDisallow: /admin/\nUser-Agent: YisouSpider\nDisallow: /\nUser-Agent: *\nDisallow: /";
}
白名单兜底和可观测性不能少
防误杀的关键是留出合法例外,并留下追踪线索:
- 在
map规则中,把可信 UA(如Sogou web spider)显式设为 0,且放在黑名单规则之后 - 日志格式中加入 UA 和拦截标记:
$http_user_agent $blocked_ua - 对高频触发
$blocked_ua的 IP,叠加limit_req zone=ua_block burst=3进一步压制
单纯封 UA 只能挡住懒爬虫;真正消耗资源的是高频自动化请求——限流才是主力,UA 判断只是第一道过滤网。














