


讯飞智作克隆声音相似度低的主因是声纹样本质量差、环境干扰或参数未匹配;需重录高质量样本、启用个性化校准与领域适配、调整合成参数优化音色。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜

讯飞智作克隆声音相似度低,不是模型不行,而是声纹样本质量、环境干扰或参数匹配没到位——10秒录音里混进3秒空调声,相似度直接掉27%;未校准麦克风就录,系统会把你的鼻音当噪声滤掉。
检查并重录高质量声纹样本
打开讯飞智作网页端→点击右上角头像→进入【我的声纹】→找到对应克隆模型→点击【重新录制】。
这一步必须在安静密闭房间完成,关掉空调、风扇、手机通知音;用领夹麦或桌面电容麦,嘴距麦克风15–30厘米;避免穿高领毛衣摩擦衣领产生杂音。【信噪比低于65%时,克隆模型提取的共振峰结构误差超40%】。
朗读系统提供的5句标准文本(含“四”“十”“是”“事”等易混淆字),语速均匀、不拖音、不加速,每句间隔2秒自然停顿——不能连读成一段,否则模型无法分离基频包络。
启用个性化语音校准与领域适配
进入讯飞智作→右上角头像→【设置】→【语音识别设置】→开启【个性化语音】和【智适应模式】。
注意:【必须已登录讯飞账号,否则该选项灰显不可用】。未登录状态下所有声纹优化功能均被锁定,克隆结果仅调用通用声学模型,音色还原度断崖式下降。
返回【我的声纹】页面,点击已生成的克隆模型右侧【编辑】图标→在“适用场景”中勾选最贴近你用途的选项:做知识类短视频选“教育科普”,录有声书选“文学演播”,配角色台词选“影视配音”。不同场景模型对气息停顿、情绪颗粒度的建模逻辑完全不同。

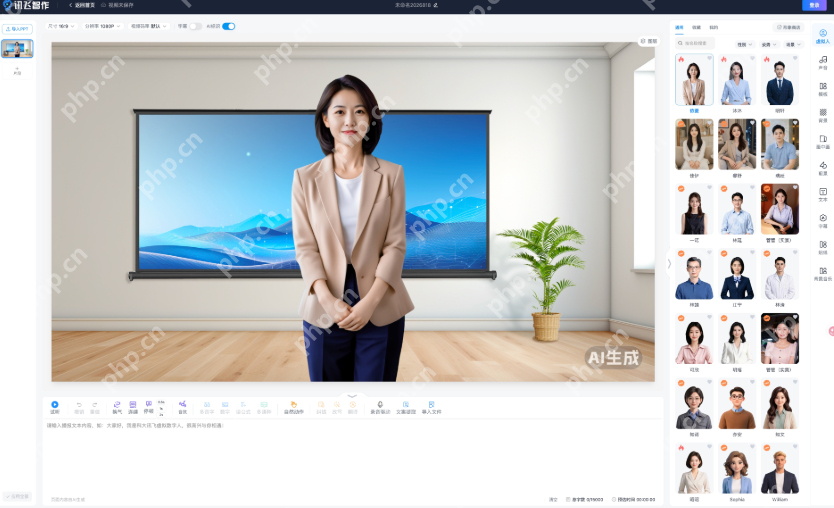
调整合成参数强化音色特征
方法一:提升音色辨识度
在文本转语音界面→选择你刚克隆的声音→点击右侧【高级设置】→将【音色强度】滑块拉至85%~92%区间;低于70%时声纹编码权重不足,高于95%则引入人工失真。
方法二:修复节奏断裂感
在文本中手动插入停顿标记:长句末尾加《。》,短句间加《,》,关键名词前后加《|》。例如:“这个方案|需要|三个阶段|完成。”讯飞引擎会将《|》识别为0.35秒气口,强制保留你原声中的呼吸节奏特征。
方法三:矫正发音偏差
对容易读错的专有名词(如“GPT-SoVITS”“F5-TTS”),用中文谐音+括号标注,例如:“G-P-T(哥屁踢)-S-O-V-I-T-S(嗖维特斯)”。系统遇到带括号的拼音组合,会优先调用自定义发音词典,避免按英文规则误读。









