


Nginx需分阶段精准设置超时并配合故障转移与后端协同:proxy_connect_timeout(2–5s)、proxy_send_timeout(10–30s)、proxy_read_timeout(按P95设,如15s);启用max_fails、proxy_next_upstream等实现自动摘除与重试;强制DNS解析、限制资源占用;后端超时须比Nginx小3–5秒,形成闭环。
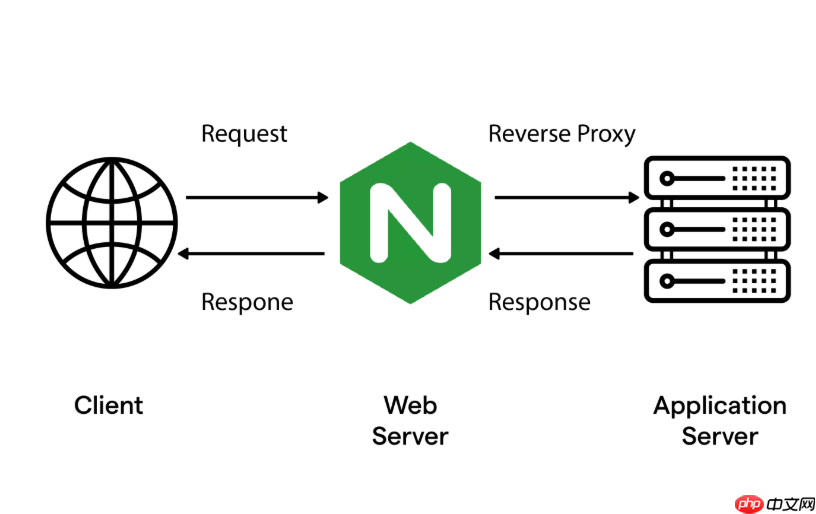
外部依赖服务(如数据库、认证中心、下游微服务)宕机时,Nginx 代理层若缺乏主动防御机制,极易被拖入长等待、连接堆积、worker 耗尽的级联超时状态。这不是“调大 timeout 就能解决”的问题,而是要让 Nginx 在感知异常后快速失败、自动切换、限制影响范围。
精准分阶段设超时,避免单点卡死全局
建连、发请求、等响应三个环节必须独立控制,防止一个慢依赖拉垮全部路径:
- proxy_connect_timeout 设为 2–5 秒:仅控制 TCP 握手,超时即断,不进重试计数;内网服务建议 ≤3s,公网回源可放宽至 5s
- proxy_send_timeout 设为 10–30 秒:针对含大 body 的请求(如上传、批量导入),空闲发送时间超限就断,避免占用连接不释放
- proxy_read_timeout 按业务 P95 耗时设置,而非拍脑袋:例如后端平均响应 6s、P95 是 12s,则此处设 15s;对明确长耗时接口(如报表导出)单独 location 配置,不污染高频接口
启用故障转移机制,让超时触发真实兜底
光有超时只是“等完再报错”,必须配合重试与节点摘除,把单次失败转化为弹性恢复:

- 在 upstream 块中配置 max_fails=2 fail_timeout=30s:连续两次超时或错误即标记节点不可用,30 秒后自动探测恢复;fail_timeout 建议 ≥ 2×proxy_read_timeout,防抖动误摘
- 在 location 或 upstream 中启用 proxy_next_upstream error timeout http_502 http_503 http_504:确保超时、连接拒绝、后端返回典型网关错误都能触发换节点
- 用 proxy_next_upstream_tries 3 限制整轮最多尝试 3 次(首次 + 2 次重试),搭配 proxy_next_upstream_timeout 20s 控制整轮重试总耗时,避免雪崩式重试
切断无效等待,防止资源被长期占满
依赖挂掉后,大量请求可能卡在 DNS 解析、上游连接池、缓冲区等环节,需主动干预:
- 强制启用运行时 DNS 解析:配置 resolver 114.114.114.114 8.8.8.8 valid=15s;,并在 upstream server 行加 resolve(如
server api.auth.example.com resolve;),避免因 DNS 缓存过期或 IP 变更导致永久阻塞 - 禁用无意义的 keepalive 复用:若后端已不可达,复用连接反而延长失败感知时间;可临时关闭 keepalive,或缩短 keepalive_timeout 至 10–15s 加速清理
- 限制单请求资源占用:用 client_max_body_size 10m 拦截超大上传,用 proxy_buffering on; proxy_buffers 8 16k; 控制缓冲上限,防慢后端持续吞 buffer 导致 OOM
配合后端协同,形成超时闭环
Nginx 的超时策略只有和下游服务自身超时对齐,才能真正起效:
- Java 应用(如 Spring Boot)需设置 server.tomcat.connection-timeout 或 server.jetty.idle-timeout,值应比 Nginx 的 proxy_read_timeout 小 3–5 秒,确保后端先断连,Nginx 能捕获 Connection reset 并快速重试
- 数据库连接池(如 HikariCP)的 connection-timeout 和 validation-timeout 也需小于 Nginx 层超时,避免应用卡在获取连接阶段,Nginx 却还在傻等响应
- 在关键路径添加健康检查探针(如
location /health { proxy_pass http://backend/health; proxy_cache_bypass $arg; }),供监控系统实时识别节点状态,辅助人工干预











