python 在网络爬虫开发中应用广泛,其关键环节在于高效获取接口数据。得益于强大的第三方库生态,仅依靠内置的 urllib 模块,就能轻松发起 http 请求、接收响应内容,并完成后续的数据解析与提取,整个过程简洁直观、扩展性强。
1、 创建一个新的 Python 脚本文件,导入 urllib、json 等基础模块。
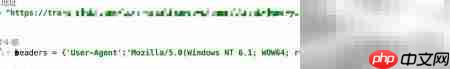
2、 指定目标 API 的 URL 地址,并构造合适的请求头(Headers)以模拟真实客户端行为。
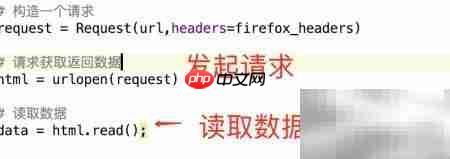
3、 利用 urllib.request.urlopen() 方法发起请求,读取并获取服务器返回的原始响应数据。

A Python CLI skill for Cutout.Pro visual APIs — background removal, face cutout, and photo enhancement. Supports file upload & image URL input.
下载
调用 Cutout.Pro 视觉处理 API 进行背景移除、人像抠图和照片增强,支持文件上传与图片 URL 输入。
立即学习“Python免费学习笔记(深入)”;
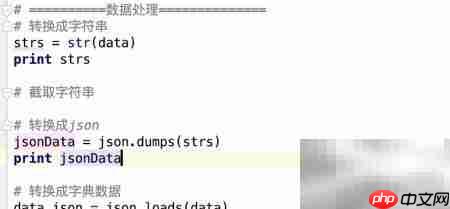
4、 对响应结果进行结构化解析:如解码为字符串、转换为 JSON 格式、转为字节流等,并从中精准提取所需字段的值。