








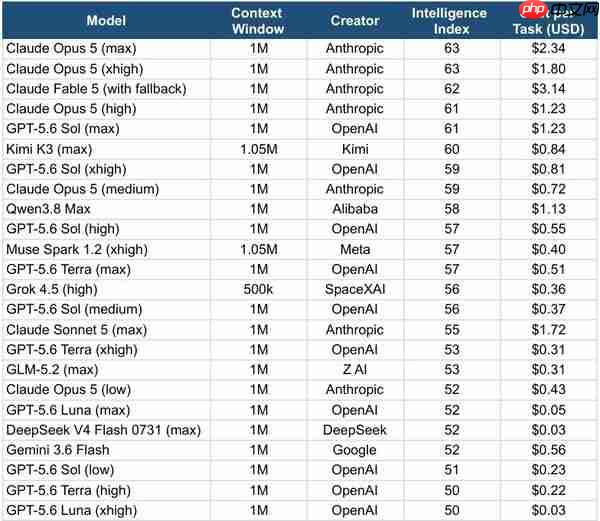
中国人工智能模型正以迅猛势头缩小与openai、anthropic等国际顶尖模型的性能差距,更在“性能比”——即单位任务成本这一核心维度上展现出显著领先优势。最新数据显示,由独立ai评估平台artificial analysis(aa)发布的全球前20大模型榜单中,deepseek v4 flash以单任务仅3美分的极低成本,成为当前最具性价比的选择。
DeepSeek
性能鸿沟持续收窄,国产模型稳居第一梯队
过去,中国AI模型多以价格优势切入市场。但随着月之暗面Kimi K3、阿里巴巴Qwen 3.8 Max等新一代模型密集发布,国产大模型已成规模进入AA综合智能指数前十。若将榜单扩展至前20名,本月初刚上线的DeepSeek V4 Flash亦成功跻身其中。
在智能指数达60分以上的顶级模型阵营里,唯一开放权重的代表是月之暗面Kimi K3(60分)。其得分仅比当前榜首Claude Opus 5(63分)低3分,较GPT-5.6 Sol也仅差1分;而单任务成本仅为84美分,在前沿模型中处于低位水平。
任务成本:衡量企业真实AI开销的关键标尺
在模型成本评估中,单纯关注令牌单价并不全面。推理过程中,模型需消耗大量内部“思考”令牌用于逻辑推演与上下文建模,因此即便单价低廉,完成一次完整任务的总支出仍可能偏高。“任务成本”更能体现企业实际负担——即为达成特定目标所耗费的全部令牌资源。
DeepSeek V4 Flash智能指数为52分,与OpenAI GPT-5.6 Luna(max模式)持平,但任务成本仅3美分,明显优于后者的5美分。尤为关键的是,DeepSeek V4 Flash首字响应时间(TTFT)为1.17秒,端到端响应耗时19.49秒;而GPT-5.6 Luna(max)的TTFT超过135秒。两者智能表现与成本接近,但DeepSeek在响应效率上的优势极为突出。
响应速度叠加部署自由度:双重竞争力凸显
在响应时效方面,Claude Opus 5表现优异:TTFT为5.92秒,端到端响应时间仅14.68秒,整体延迟约为同级模型平均值的四分之一。

此外,DeepSeek V4 Flash采用MIT开源协议,支持企业本地化部署与私有化托管;而GPT-5.6 Luna仅提供封闭API服务。这一差异直接影响开发者的技术选型与长期运维策略。
阿里巴巴最新推出的Qwen 3.8 Max参数量达2.4万亿,智能指数58分,位列榜单第10位,印证了其“史上最强Qwen”的定位。不过其单任务成本为1.13美元,高于同档位竞品。
在1美分价位段,GPT-5.6 Luna(low模式)、MiMo-V2.5和Llama 4 Scout均榜上有名。其中MiMo-V2.5(智能指数37分)在该价位区间内综合性价比最优。
企业AI预算告急:Uber年度支出四月即用尽
AI支出激增已成为企业普遍面临的现实挑战。据《福布斯》5月报道,Uber因工程师大规模使用Anthropic Claude Code,导致2026年全年AI预算在4月便提前耗尽。在一个约5000人的技术团队中,Claude Code的快速普及使AI投入远超预期,公司随后为每位员工设定了每月1500美元的代理编程工具使用上限。
亚马逊同样遭遇类似困境。其内部AI项目借助Anthropic Claude Sonnet执行商品信息与作者数据匹配任务,最终成本飙升至原始预算的9.6倍,总额近180万美元。更严峻的是,该成本失控问题在长达5个月内未被及时识别。
随着AI能力在企业内部加速渗透,尤其向代理式应用与复杂推理任务延伸,令牌消耗带来的财务压力正急剧上升。厂商虽尝试通过下调令牌单价或引入“提示缓存”机制缓解压力,但缓存命中仍需计费,且上下文越长,累计成本越高;一旦缓存失效(如对话中断超5分钟、历史消息被修改),费用将按原始价格重新计算。
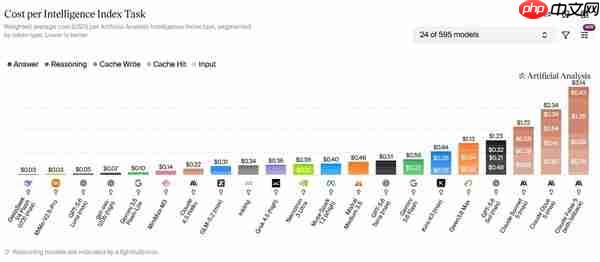
AA智能指数系加权复合指标,整合GDPval-AA v2、τ-Bench Banking、Terminal Bench 2.1、SciCode、HLE、GPQA Diamond、CritPt、AA-OmniScience、AA-LCR共9项权威评测结果。任务成本则基于各模型在上述9项测试中实际消耗的令牌总量(含输入、缓存命中、缓存写入、推理运算及输出)乘以对应令牌单价得出。需特别说明:该指标聚焦编码、数学、科学及代理类任务场景,不适用于纯文本翻译、通用聊天或日常办公等轻量级应用。
















