


oceanbase首次对外披露其支撑蚂蚁灵光ai生成应用的数据架构实践。该架构以面向海量应用的逻辑表设计、共享物理存储机制及受控sql计算能力为核心,构建出“应用数据模型彼此独立、底层资源高效复用”的新型数据库体系,为ai生成类应用的大规模部署与稳定运行提供了坚实的数据底座。
据今年4月统计,蚂蚁灵光平台已累计产出约3000万个闪应用。随着AI技术大幅降低应用开发门槛,由AI Agent自主生成的应用呈现爆发式增长。在此背景下,传统数据库架构遭遇全新挑战:一方面需保障每个应用具备专属的数据建模与计算能力;另一方面又必须规避为数以千万计的应用单独部署数据库所带来的存储冗余与运维负担。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
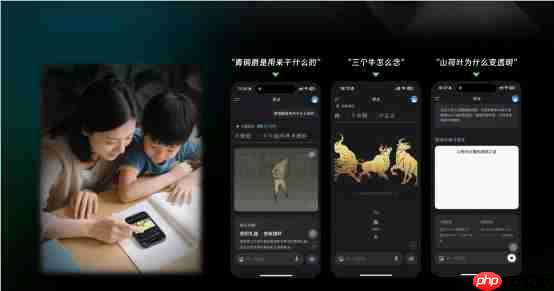
为应对上述难题,OceanBase创新性地提出了专为海量AI应用定制的“逻辑表”架构方案。在使用层,每个闪应用仍保有完全独立的数据表结构,支持自由建表、写入数据及执行标准SQL查询;而在底层,所有应用共用同一套物理存储资源。借助OceanBase JSON Table SDK,应用数据以JSON格式统一写入共享表中,数据库则依据各应用私有的Schema定义,自动完成数据映射、查询解析与聚合运算,从而实现细粒度、高精度的数据处理能力。
相较将全部数据粗放式存入单一JSON大表,或为每个应用单独分配物理表的传统方式,该架构显著缓解了海量应用场景下的数据库管理压力,并严格确保多租户之间的权限隔离与数据安全。当某一应用数据量持续攀升、性能需求提升时,系统还可平滑迁移至专属物理表,兼顾扩展性与高性能。
OceanBase指出,本次落地实践不仅成功验证了数据库对AI原生应用的数据治理能力,更标志着数据库正加速向AI就绪型数据平台演进。今年6月,OceanBase正式推出新一代湖库一体AI数据库,首次实现结构化数据、非结构化数据与向量数据的统一纳管,全面支撑AI Agent实时获取完整业务上下文。目前,该能力已在蚂蚁集团内部“阿福”“灵光”等核心AI场景完成验证,并正面向企业客户开展规模化测试。
伴随AI Agent逐步成为下一代主流应用范式,数据基础设施的战略价值日益凸显。OceanBase将持续深耕面向Agent的数据底座建设,助力企业级AI应用实现更高效、更稳定、更可持续的规模化落地。












