


☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
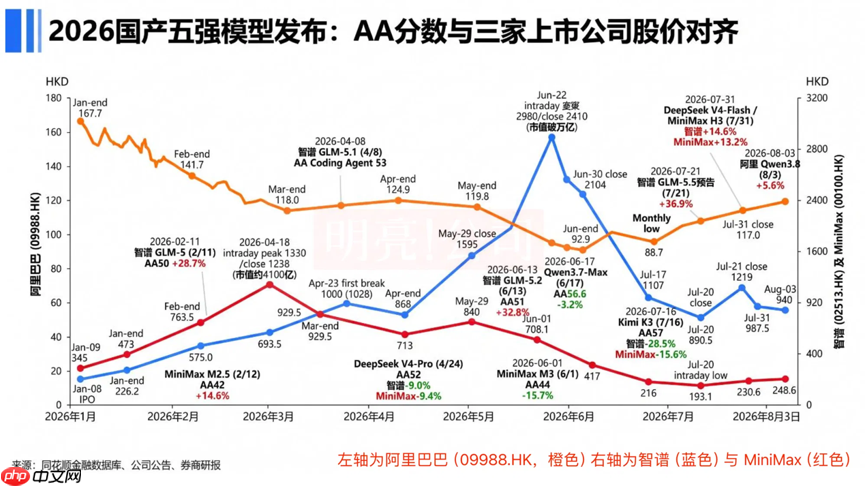
8月3日,阿里巴巴正式推出Qwen 3.8-Max版本,据官方披露,该模型总参数量达2.4万亿,激活参数为950亿。当日收盘,阿里巴巴港股(89988.HK)股价上扬6.75%。
7月31日,DeepSeek正式发布V4 Flash版本。Artificial Analysis指出,此版本在单任务成本维度(非单Token成本)上,目前处于行业最低水平,其成本约为Anthropic Fable 5的1/105。
7月17日,Kimi K3模型上线,智谱(02513.HK)与MiniMax(00100.HK)股价同步走低。数据显示,智谱在7月17日(周五)及7月20日两个交易日内跌幅达42.47%,MiniMax同期累计下跌约24.57%。K3发布初期曾在Artificial Analysis(以下简称“AA”)编程榜单中登顶,有观点认为,智谱此前依托GLM-5.2构建的“国产最强开源模型”叙事因此受到明显削弱。
但仅隔两周,即7月31日,DeepSeek V4 Flash与MiniMax H3(视频生成模型)同步亮相,港股AI板块随即回暖。当日智谱涨幅约14.56%,MiniMax上涨约13.15%,阿里巴巴港股亦收涨4.73%。
前一次竞品发布引发模型厂商股价下挫,后一次则带动整个板块上行——市场对两次事件的反馈截然不同。
一种解读是:资本市场对DeepSeek战略定位的认知已发生迁移。4月V4预览版发布时,市场更多将其视作对模型公司估值的潜在压制力量,这一逻辑在Kimi K3发布时仍具延续性;而至7月底,V4 Flash被重新定义为国产开源生态的成本新基准,同时标志着能力下限的系统性抬升,从而有望放大所有开源模型企业的长期成长空间。
8月3日港股收盘后,智谱股价回调4.73%;MiniMax则上涨7.2%,或受益于H3所强化的差异化技术路径。
回溯近半年来中国已上市大模型企业的股价走势可见,由开源模型性能SOTA所驱动的估值跃升窗口正持续收窄——过去迭代周期以季度或月份计,如今已压缩至双周乃至单周级别。长远来看,单一模型的性能表现、评测分数及排名,已难以构成支撑公司长期估值的核心依据。
与此同时,针对国内主流开源模型厂商的估值逻辑,资本市场正逐步转向中观层面,与北美市场对标。大语言模型赛道正在经历“圈层收缩”:从“三足鼎立”加速演进为“双寡头”格局,基础模型领域的参与者数量将持续减少。在此背景下,一款短期内评分领先、排名靠前的模型,已不足以成为企业留在核心竞争圈层的充分条件。
模型榜单曾是估值叙事的直接支点
若需锚定一个观察市场情绪转变的关键节点,智谱与MiniMax的解禁期可视为相对合理的参考坐标:一方面该时段临近年中,另一方面两家公司上市仅相隔一日,市场叙事起点高度一致。
智谱堪称上半年“模型即估值”逻辑的典型代表。2月GLM-5开源发布,AA评分为50分,首次实现开源模型在该榜单突破50分大关。AlphaEngine数据显示,智谱当日股价飙升28.68%,T+3累计涨幅达132.07%。6月GLM-5.2发布后,AA智能指数升至51分,跻身全球前三,智谱在官宣次日大涨32.82%,6月下旬市值一度突破万亿港元。
影响估值的不仅限于模型性能,还包括商业化节奏。智谱在GLM-5发布时同步上调Coding Plan服务价格30%,直接拉动API收入增长。彼时市场普遍接受的逻辑是:模型能力跃升→榜单排名提升→支撑价格上调→调用量不降反增→验证定价权存在。这正是纯模型厂商获取估值溢价最直接的路径。
MiniMax早期亦曾复现类似叙事。2月M2.5发布后,公司股价当日上涨14.62%,T+3累计涨幅达89.08%。但其底层逻辑与智谱存在差异:M2.5在AA智能指数中得分约42分,全球排名居15名开外,但SWE-bench测试结果与OpenRouter平台调用量数据提供了另一重佐证。当时市场接纳的是“榜单表现偏弱、实际调用强劲”的商业化叙事。
进入6月,MiniMax模型发布对估值的支撑力明显减弱,尤其是M3被指“不及预期”。5月31日晚M3上线,6月1日股价高开低走,最终收跌15.71%。尽管M3支持百万级上下文并采用自研MSA架构,但在AA智能指数中得分仅为约44分,处于跟随梯队。
更关键的是,M3提价动作缺乏足够有力的榜单排名与调用量数据支撑其定价权。市场并未将此次涨价解读为商业化能力增强,反而视其为估值兑现压力的集中释放。
阿里Qwen则呈现另一种图景。Qwen系列模型迭代频密、技术实力稳居第一阵营,但阿里股价极少因单一模型发布产生显著波动。其估值变量涵盖阿里云营收、MaaS平台进展、资本开支节奏、AI应用分发能力、海外云业务映射及集团整体基本面。6月17日Qwen 3.7-Max正式发布,部分口径下AA得分为56.6分,位列中国第一、全球第六,但阿里美股当日下跌3.18%,T+5累计跌幅达14.33%。
Kimi与DeepSeek虽未上市,却已成为上市模型公司的外部估值锚点。Kimi K3发布后,智谱与MiniMax股价下探,印证了未上市企业亦可通过模型排名变动,实质性影响二级市场对已上市模型公司的价值判断。

DeepSeek的影响则更为复杂:4月V4预览版发布时,模型厂商股价承压、硬件股走强,市场将其理解为对模型层估值的压制;而7月V4 Flash正式发布后,智谱、MiniMax、阿里及算力链相关标的集体上扬,反映出市场正转向以生态视角进行定价。
SOTA窗口收窄,单次领先难再作为长期估值基石
两家公司解禁前后,市场叙事逻辑发生了显著位移。随着SOTA维持周期不断缩短,模型性能指标与估值之间的关联正趋于弱化。
智谱与MiniMax均于7月迎来解禁窗口,但市场反应分化明显。智谱当月解禁比例约为5.76%,7月8日至9日前后股价仍保持上行态势,表明市场当时仍认可GLM-5.2带来的领先优势,并对其后续GLM-5.3或更大参数旗舰模型的持续SOTA能力抱有期待。
MiniMax情形则相反。其解禁比例高达约48%,7月9日单日股价暴跌17.98%,市值跌破千亿港元。对MiniMax而言,解禁压力、M3定价权遭质疑、多模态叙事热度消退三重因素叠加,模型发布已无力对冲筹码供给冲击与估值回归趋势。
解禁之后,智谱亦迅速遭遇外部扰动。7月17日Kimi K3发布,国产模型排行榜被重构,智谱此前“国产开源第一”的溢价空间被明显压缩。7月21日,摩根大通将智谱目标价由2400港元下调至1600港元,降幅达33%,但仍维持“增持”评级。
此举表明卖方并未否定智谱自身经营质地,而是下调了市场愿为“单一领先性”支付的估值溢价倍数。换言之,公司仍可能具备稳定交付能力,但单个模型的领先周期,已无法匹配此前的估值水位。
MiniMax则借7月31日发布的H3获得阶段性修复。H3系MiniMax首度开源的多模态生成模型,被多家媒体称为AA视频编辑榜全球第一,定价为0.8元/秒,并于8月3日正式开源。对MiniMax而言,H3并非意在全面重申技术统治力,而是回应市场关于“多模态叙事是否终结”的疑虑。
此前M3发布时,市场对其提价逻辑与跟随式定位不予认可;H3则通过开源策略、多模态榜单表现及更具竞争力的定价,重新提供了一个可供讨论的价值锚点。MiniMax在7月31日上涨约13.15%,更接近低位反弹,而非长期估值重估。
上述变化背后共同指向的趋势是:SOTA窗口期正在加速收窄。模型发布节奏不等于SOTA持续时间。BenchLM统计显示,过去12个月共出现107个具有显著意义的模型发布,平均约每3天即有一款;进入2026年下半年,前沿模型发布节奏已逼近每周1至2次。
资本市场甚至无需等待模型真正“登顶”即作出反应。只要新模型足以动摇既有排序预期,或削弱原SOTA厂商的领先假设,股价便会提前调整。Kimi K3发布后智谱与MiniMax股价下挫,是对“排序重置”的即时响应;DeepSeek V4 Flash发布后板块普涨,则是对“生态成本下探”的积极反馈。
二者看似矛盾,实则统一——均表明市场正以更高频次重估模型企业价值,这也必然重塑模型公司的长期估值范式。
过去,一次SOTA即可支撑较长时间的估值溢价;如今,SOTA更多扮演短期交易信号角色。
智谱GLM-5与GLM-5.2之所以有效,源于其兼具“首次突破”“排名跃升”与“涨价验证”三重属性;MiniMax M3失效,则因跟随式发布既无法支撑提价逻辑,亦难抵消解禁压力;阿里Qwen股价弹性有限,说明平台型公司需依靠云业务收入、MaaS调用量及生态协同来承接模型能力,而非依赖榜单本身。
长期看,单次达成SOTA,并不等同于企业拥有更强的商业化潜力。模型排名动态变化,API价格受开源生态持续挤压,客户决策亦在性能、成本与场景适配间动态权衡。若一家公司仅有一次登顶记录,却缺乏持续迭代能力、调用量增长动能、客户留存机制与收入转化效率,那么SOTA带来的估值红利将很快被下一轮模型发布所稀释。
7月以来,市场已显著降低对单一模型领先的估值权重,并在叙事中主动寻求更多维“证据”,包括模型迭代速度、收入增速与价格弹性、可持续商业模式等。正如「明亮公司」此前所指出,资本市场对模型能力的估值逻辑正在经历深刻转型。当越来越多企业能够逼近前沿模型水准时,“唯性能论”已难构筑长期估值护城河,市场正进一步追问:模型能力之外的商业价值究竟何在?
在通往AGI的征途中,谁能更清晰地勾勒出可行的“技术路线图”,往往也就掌握了更大的叙事主导权。
本文来自微信公众号 “明亮公司”(ID:suchbright),作者:主编24小时在线,36氪经授权发布。














