


TIME_WAIT积压主因是Nginx主动断连,需调优内核参数和keepalive配置;CLOSE_WAIT积压主因是后端未及时关闭连接,须检查应用代码、超时设置及协议一致性。
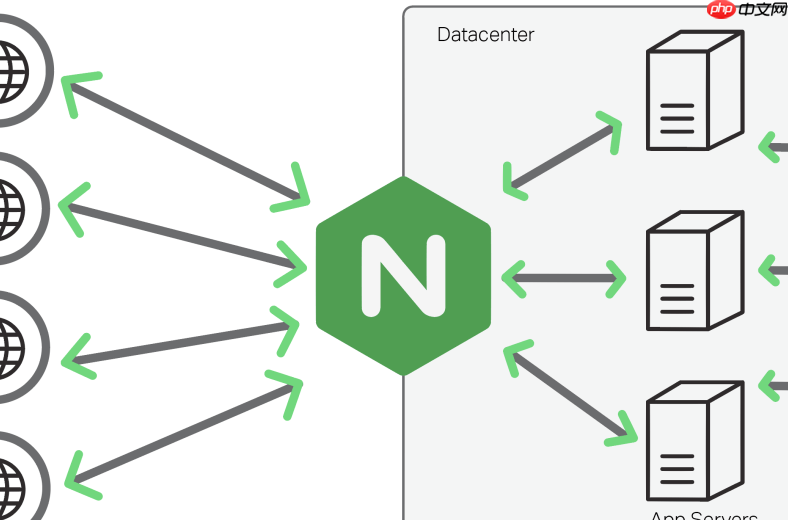
排查 Nginx 出现大量 TIME_WAIT 或 CLOSE_WAIT 连接积压,关键在于区分状态成因:TIME_WAIT 多是主动断连引发,属系统级可调参数问题;CLOSE_WAIT 多是服务端未及时关闭连接,属应用逻辑或配置缺陷。两者排查路径完全不同,不能混用方案。
快速定位当前连接状态分布
先确认问题类型和规模,避免盲目调参:
- 统计所有 TCP 状态数量:
netstat -n | awk '/^tcp/ {++S[$NF]} END {for(a in S) print a, S[a]}' - 只看 TIME_WAIT 的来源 IP 和端口:
netstat -an | grep TIME_WAIT | awk '{print $4}' | sort | uniq -c | sort -n(识别是否集中在某几个上游或客户端) - 只看 CLOSE_WAIT 并关联进程:
netstat -tnp | grep CLOSE_WAIT | grep nginx或结合lsof -i -n -P | grep CLOSE_WAIT查具体 worker 进程 PID - 用
ss -s快速查看汇总(含 total、TCP、tw、orphan 等字段),比 netstat 更轻量
TIME_WAIT 积压的典型原因与验证
TIME_WAIT 是 Nginx 主动断开连接后进入的状态,常见于以下场景:
- 客户端使用短连接(HTTP/1.0 或未带
Connection: keep-alive),每次请求都新建+关闭连接 - Nginx 配置了过短的
keepalive_timeout(如设为 5s),导致长连接频繁被提前关闭 -
keepalive_requests值过小(如默认 100),高 QPS 下连接被强制回收,触发四次挥手 - 作为反向代理时,未开启 upstream keepalive,Nginx 与后端反复建连断连
验证方法:抓包观察是否高频出现 FIN 包;检查 access 日志中 User-Agent 是否大量 HTTP/1.0 请求;对比 keepalive_timeout 与后端实际响应间隔。

CLOSE_WAIT 积压的核心判断逻辑
CLOSE_WAIT 表示对端(通常是后端服务)已发 FIN,本端(Nginx 或其后端应用)尚未调用 close()。Nginx 本身不会卡在 CLOSE_WAIT —— 它只转发、不持有业务连接。所以 CLOSE_WAIT 堆积一定发生在:
- 后端应用(如 Tomcat、Spring Boot)未正确释放连接:比如异常未捕获导致 finally 块未执行、异步任务未 await、数据库连接未 close
- 后端设置了过长的 socket timeout(如 Tomcat 的
connectionTimeout),让连接挂起等待而非及时关闭 - Nginx 与后端协议不匹配:例如 proxy_http_version 设为 1.0,但后端返回
Connection: close,Nginx 转发后客户端可能误判 - 后端存在资源泄漏(线程池满、连接池耗尽),无法处理新请求,旧连接堆积在 CLOSE_WAIT
重点查后端日志中的异常堆栈、连接池监控指标(如 Druid 的 activeCount)、以及 lsof -p [backend_pid] 看对应进程的 socket 数量和状态。
针对性优化与修复措施
确认问题类型后,按需调整:
-
TIME_WAIT 优化:启用内核重用(
net.ipv4.tcp_tw_reuse = 1),确保net.ipv4.tcp_timestamps = 1(recycle 已废弃,不建议开启);增大本地端口范围(net.ipv4.ip_local_port_range = 1024 65535);调高 time-wait bucket 上限(net.ipv4.tcp_max_tw_buckets) -
CLOSE_WAIT 修复:检查后端代码中 HTTP 客户端、数据库连接、文件句柄是否都 try-with-resources 或显式 close;缩短后端 socket 超时(如 Tomcat connector 的
connectionTimeout设为 15–30s);Nginx 中强制使用 HTTP/1.1 并清除 connection 头:proxy_http_version 1.1; proxy_set_header Connection ''; -
upstream 连接复用:在 upstream 块中添加
keepalive 32;,并在 location 中配置proxy_pass http://backend;后加keepalive_timeout 60s;(注意不是 nginx 全局 keepalive_timeout)











