





内存满载时Nginx应设weight=0临时降权:停止分发新请求、保留健康检查与长连接,配合监控脚本自动触发与恢复。
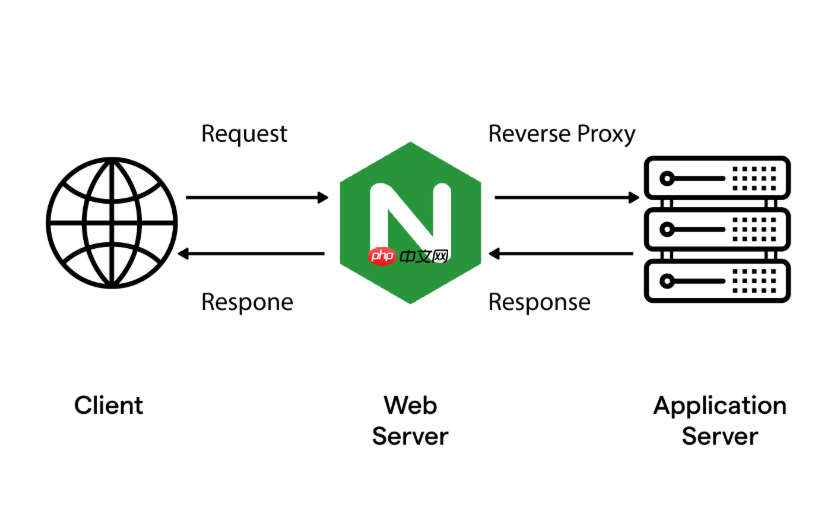
后端机器内存跑满时,Nginx 自身无法自动感知该状态,但可以通过外部监控联动 + 临时降权实现平滑降级——核心是“不让新请求继续压上去”,同时保留健康检查通道,避免误剔除或中断已有连接。
内存满载的典型表现与风险
内存耗尽会导致进程响应变慢、GC 频繁、OOM Killer 杀进程,甚至服务假死。此时若 Nginx 仍按原权重持续派发请求,会加剧堆积、触发超时和级联失败。单纯靠 max_fails 或 health_check 往往滞后(需多次失败才摘除),而直接设 down 又会切断健康探测,失去恢复判断依据。
用 weight=0 实现“静默观察式”降权
这是最稳妥的临时应对方式:既停止分发新请求,又保留探测能力,为后续恢复留出路径。

- 将目标节点权重设为 weight=0(不是删掉或加 down),例如:
server 192.168.1.50:8080 weight=0; - 它仍参与主动健康检查(如
check interval=3 rise=2 fall=3),可实时反馈是否恢复 - 已有长连接不受影响,正在处理的请求能自然完成
- 修改后执行
nginx -t && nginx -s reload,毫秒级生效,不中断其他节点
搭配监控脚本实现自动触发
人工操作有延迟,建议用轻量脚本监听内存指标并自动降权:
- 采集方式:通过 node_exporter + Prometheus 或本地
free -m | awk '/Mem:/ {print $3/$2 * 100.0}' - 触发条件示例:连续 2 分钟内存使用率 > 95%,则生成新 upstream 配置,将对应节点 weight 改为 0
- 恢复逻辑:连续 5 分钟内存
- 安全防护:每次写配置前备份、
nginx -t校验、拒绝小数/负数/空值
进一步缓解瞬时压力的协同配置
仅降权还不够,需配合其他机制防止流量“挤兑”剩余节点:
- 启用 least_conn:在权重基础上优先选连接数最少的节点,避免某台高权重点被慢请求占满
- 限制单机并发:max_conns=1024,防止单节点被突发流量打穿
- 增强重试容错:
proxy_next_upstream error timeout http_500 http_502 http_503 http_504;,配合 max_fails=2 fail_timeout=10s 加快故障识别 - 关键接口开启缓存兜底:
proxy_cache_use_stale error timeout http_500 ...,避免全量请求直接穿透失败









