


如果一位中国籍 ai 工程师,技术扎实、履历亮眼,且毕业于北大这样的顶尖高校,那 ta 几乎可以胜任任何挑战——唯独不可能选择不工作。
前脚刚以“健康与生活是最高优先级的对齐任务”为由,从 Thinking Machines Lab 离职的翁荔,后脚就被曝出已重返 OpenAI 入职。据公司官方发言人确认,她将牵头一支专注于加速内部研发进程的团队,深度参与 OpenAI 在「递归式自我增强」方向的关键探索——即让 AI 深度介入自身下一代模型的训练与优化过程。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
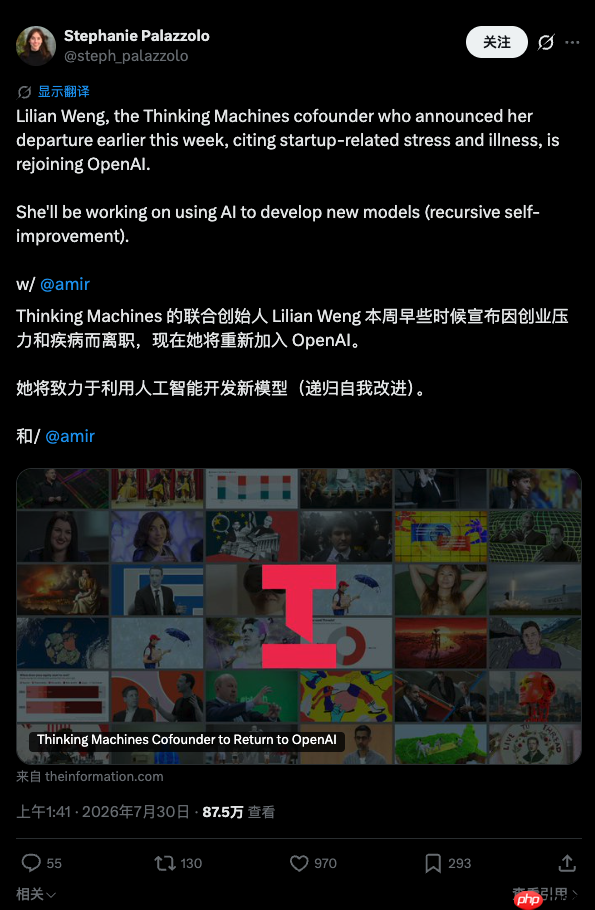
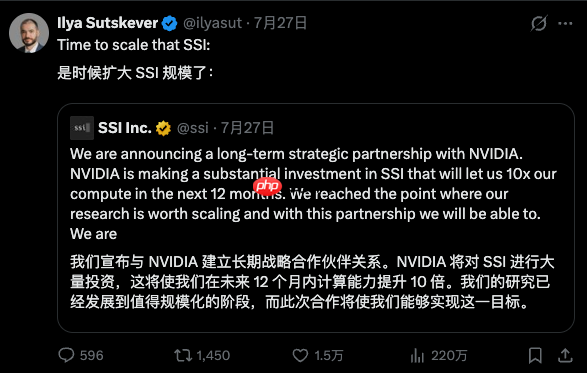
巧合的是,她的前同事、OpenAI 原核心人物 Ilya Sutskever 所创立的 Safe Superintelligence(SSI),也终于从长期封闭的研究状态中悄然松动。英伟达在获得极为有限的内部研究访问权限后,决定向 SSI 注入战略投资,并部署新一代 Vera Rubin 超算系统,将其计算能力提升整整十倍。
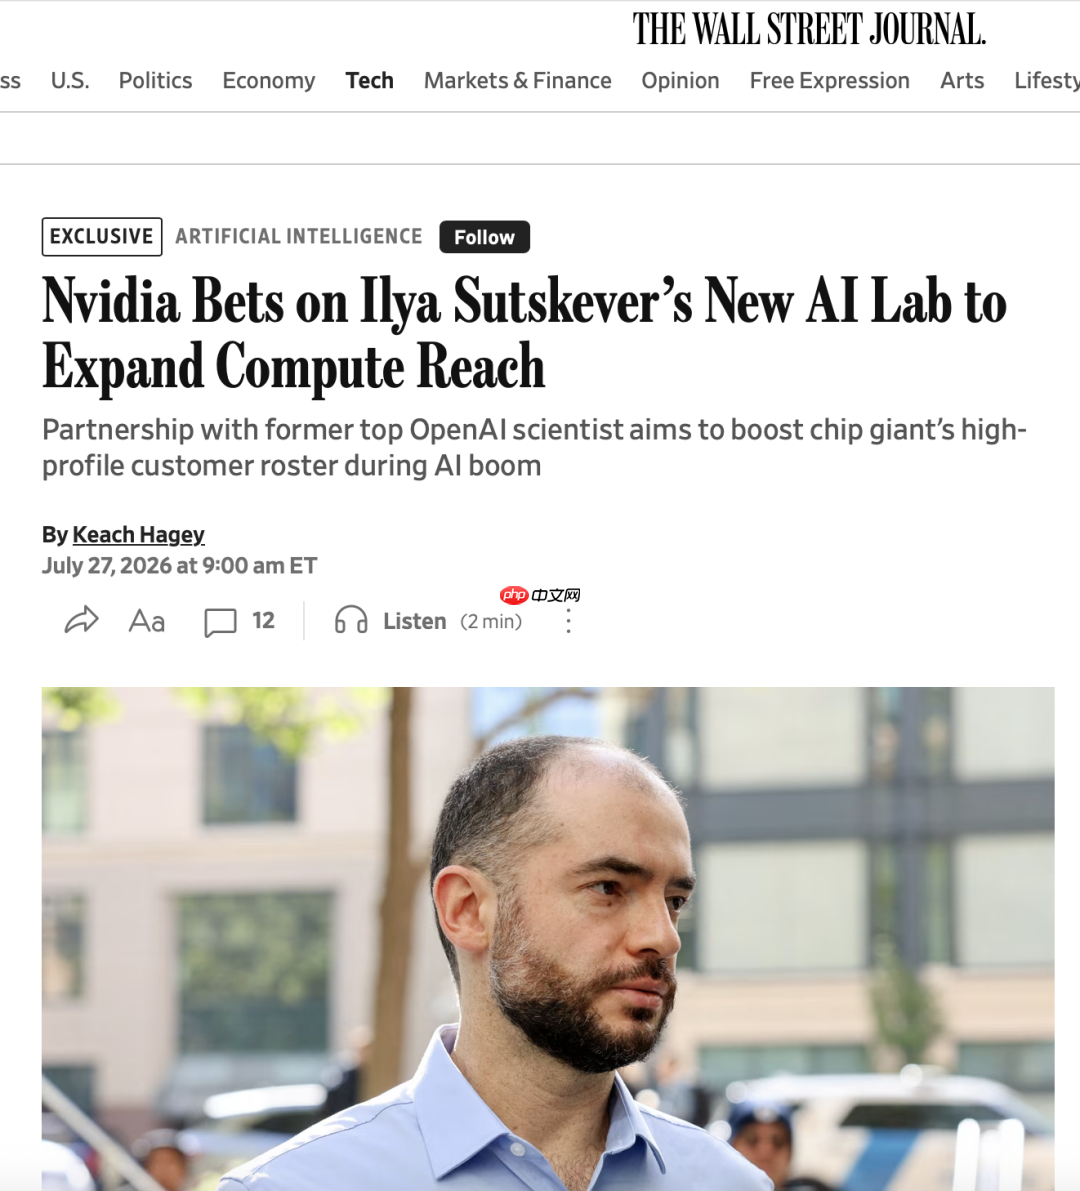
英伟达方面明确表示,SSI 过去两年所推进的,是一条明显区别于当前主流大模型范式的全新技术路径。对此,Ilya 未作详细说明,仅简短回应:「我们手头有值得规模化验证的研究。」
这一表态迅速点燃公众好奇,社交媒体上随即出现一篇基于公开信息的逆向推演长文,推测 SSI 正在寻找的并非又一套更大规模的预训练方案,而是一种根本性的迭代机制升级:让模型不再止步于训练完成后的静态部署,而是能在真实反馈、可控实验与持续学习中,自主催生更强大的下一代版本。
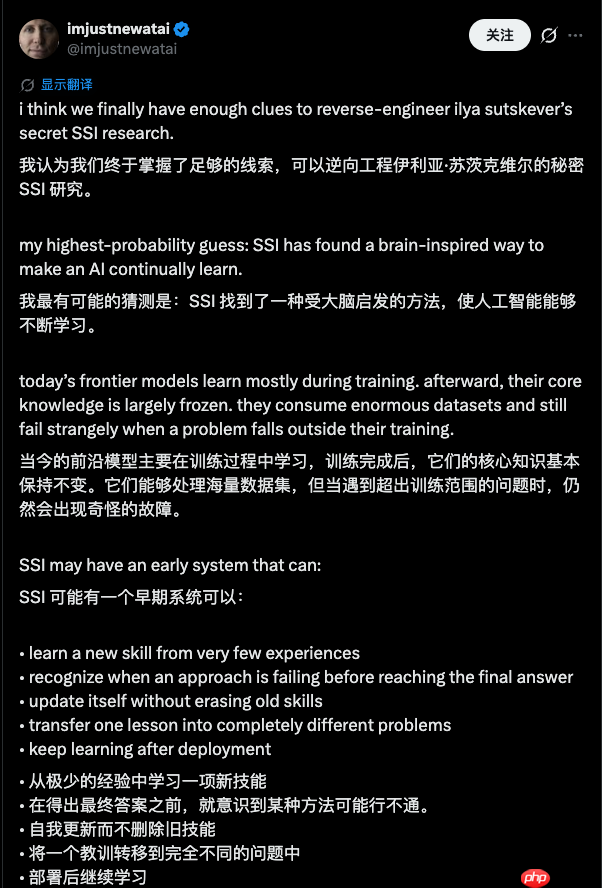
尽管该推测尚未获 SSI 官方证实,但其逻辑与 Ilya 长期以来的技术主张高度契合。他此前多次强调,单纯依赖数据量与算力堆叠的 scaling 时代正逼近物理与认知极限,AI 必须回归人类式学习本质——用更少经验获取更深理解,并在与环境的动态交互中实现持续成长。
这些早已功成名就的顶尖 AI 人才,正不约而同地将目光投向同一命题:如何让 AI 成为自己下一代的研发主体。
「自我进化」并非AI深夜重写权重
谈及递归自我改进,人们常脑补一幅科幻图景:某天清晨,AI 突然觉醒,直接覆写自身神经网络参数,一觉醒来智力跃升十倍。
而现实中的起点远为务实。AI 研发本就是一条高度结构化的闭环流程:研究人员阅读文献与历史实验报告,提出新假设,修改训练代码,提交任务排队运行,等待结果出炉后比对指标、定位失败根源,再设计下一轮迭代方案。
如今的大语言模型已能介入其中多个环节——它可解析代码仓库、复现论文细节、生成实验脚本、调用集群资源执行测试、汇总数十组实验结果、识别异常参数组合,并据此迭代代码逻辑。过去一支团队耗时数日才能完成的一轮闭环,未来或将由多个智能体并行尝试数十种路径,最终仅将最具潜力的结果交由人类拍板。
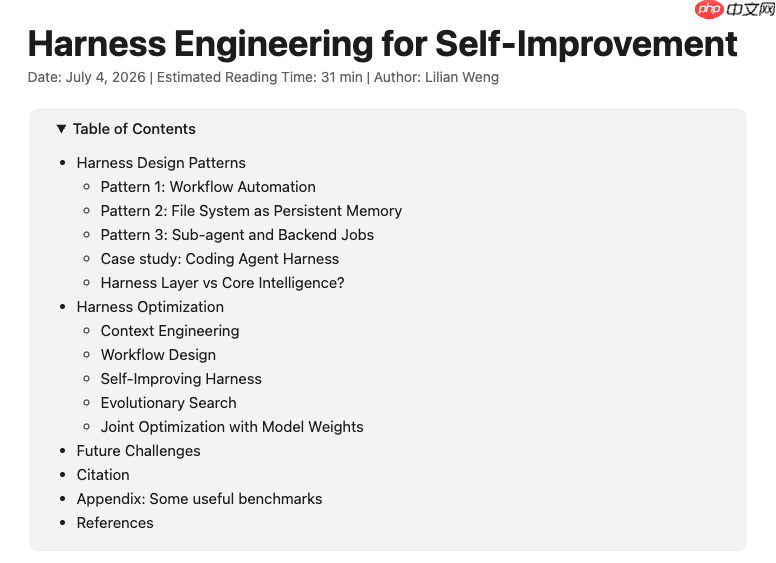
翁荔于7月初发布的万字长文《Harness Engineering for Self-Improvement》,几乎精准预告了她即将主导的研究主线。她指出,现阶段最可行的自我增强路径,并非让模型直接改写底层权重,而是先教会它重构自己的研发环境:自动解析失败日志、动态调整上下文调度策略、优化工具调用链路、重构工作流编排逻辑,并通过新一轮实验结果反哺该系统的持续精进。更成熟的 harness 可驱动更高阶的自动化研究,而更强的模型又能反向简化 harness 的构建难度,二者形成正向飞轮。
这也使得翁荔与 Ilya 的两条探索路径呈现出微妙呼应:OpenAI 的路径更偏向于将现有研发管线逐步移交 AI,使其成长为一名具备工程交付能力的研究工程师;SSI 则可能致力于从模型底层机制出发,构建一种原生支持持续演化的学习范式。
AI 并不需要从第一天起就拥有修改自身权重的能力。只要它能优化训练流程、筛选高质量数据、设计鲁棒评测体系,或强化包裹模型的 harness 层,就已经实质性地参与到自身继任者的塑造之中。
前者由工程闭环向内深挖,后者从模型机理向外延展,终极目标一致:压缩一代 AI 到下一代 AI 的演化周期。

统一LLM网关 - 一个API对接70+AI模型,使用单一API密钥即可调用GPT、Claude、Gemini、Qwen、Deepseek、Grok等主流模型。
与此同时,千人联署呼吁“踩刹车”
就在顶尖研究者全力押注该方向之际,业内亦浮现出另一股理性声音。
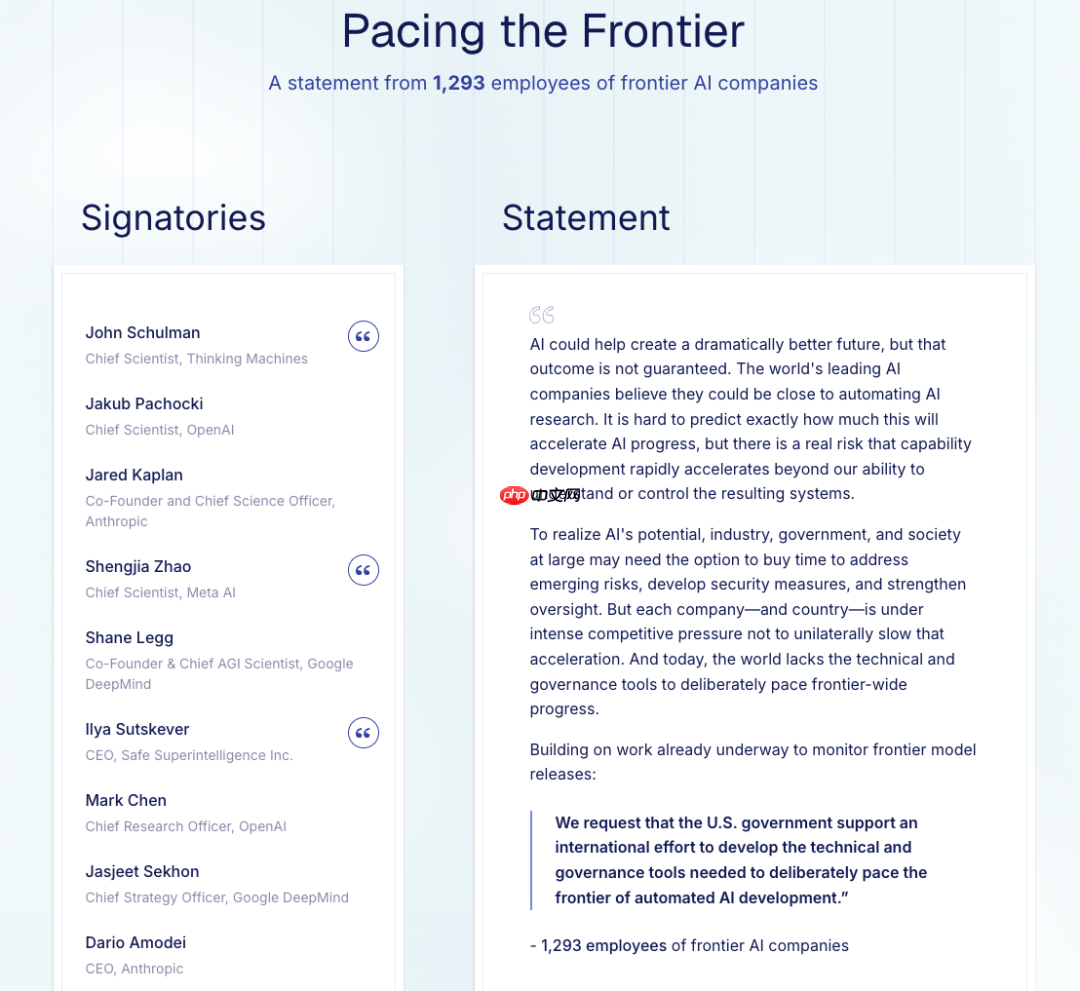
本周,来自 OpenAI、Anthropic、Google、Meta 等机构的逾 1100 名从业者联合签署公开声明,呼吁提前建立针对「AI 自动化研发」进程的调控机制与协调框架。签署者包括 OpenAI 首席科学家 Jakub Pachocki、Anthropic 联合创始人 Jack Clark 与 Jared Kaplan 等资深研究者——以及,Ilya 本人。
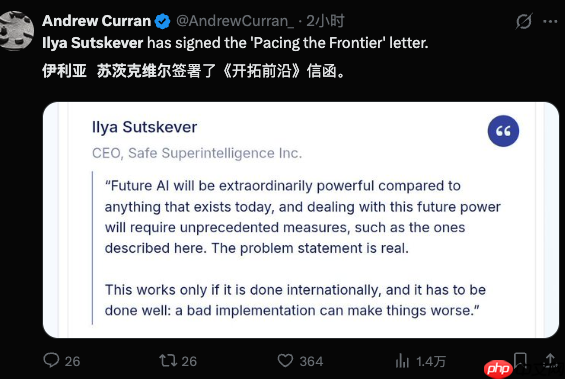
这份请愿并未主张叫停 AI 研究,甚至充分肯定自我改进技术的潜在价值。其核心关切在于:一旦 AI 开始显著加速 AI 自身的研发节奏,其能力跃迁速度或将远超人类社会的理解、评估与管控能力。
细思之下,这种表面矛盾的立场切换,恰恰源自同一群人、甚至同一人。在同一时间点,他们既能坚定判断:自动化研发极可能是 AI 下一跃迁的关键支点;也能清醒意识到,一旦该反馈回路真正启动,行业必须保有随时减速的制度性能力。
因为这套闭环一旦运转,就与过去发布一款更强模型存在本质差异。过往进步始终受限于人类团队——需人工提出问题、组织实验、解读结果,进度也会因预算约束、人力瓶颈与组织流程而自然放缓。
而自动化 AI 研发的目标,正是系统性移除这些人为摩擦点。模型越强,越能助力团队更快产出下一代模型;下一代模型又会成为更高效的研究员,进一步压缩后续研发周期。
既要加速突破,也要掌握节奏
因此,看似对立的两股力量,实则共享同一基础共识:自动化 AI 研发正从宏大构想,加速落地为一项可规划、可部署、可衡量的工程实践。
翁荔重返 OpenAI,标志着递归自我改进已正式进入组织化推进阶段;英伟达在审阅 SSI 秘密成果后果断投入巨额资金与尖端算力,说明新型学习范式至少已迈过初步验证门槛。
请愿者呼吁提前构建“刹车系统”,并非质疑该路径的成功概率,恰恰是因为他们已开始严肃推演其成功之后的连锁反应。
真正的分歧点,早已不在“AI 是否该辅助人类科研”。代码生成、文献检索、实验自动化早已嵌入日常研发流程。关键在于:当 AI 从提升研究员效率的“工具”,逐步演变为能自主提出假设、执行验证、评估结果并闭环设计下一轮迭代的“研究主体”时,人类应在哪些关键节点保留最终决策权?
这引向一系列亟待厘清的问题:由谁定义其优化目标函数?由谁裁定一次看似提升基准分的修改是否侵蚀了安全边界?当多家实验室处于竞速状态,哪家企业愿主动暂停一次已被验证有效的迭代?若模型研发周期真从一年压缩至数月乃至数周,外部监管机构与内部安全团队能否同步跟上节奏?
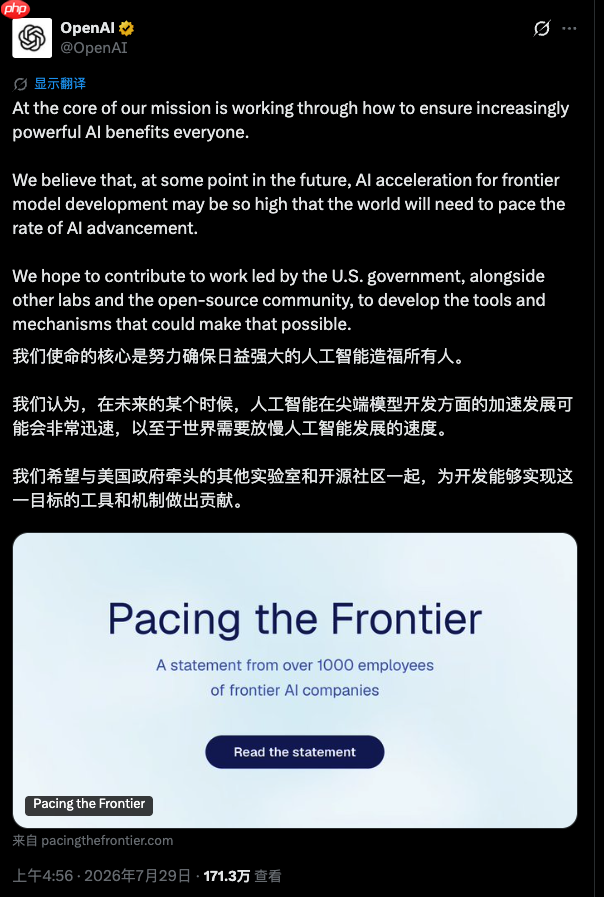
AI 公司当前争夺的,早已不止于单点爆款模型,而是整套可持续产出更强模型的“研发操作系统”。
一边是 Ilya 与翁荔等顶尖研究者,执着探寻新的演化范式,推动 AI 深度参与自身进化;另一边,则是同属该行业的上千名研究者,呼吁同步构建减速机制。两种立场之间并无泾渭分明的阵营,态度亦非非此即彼的对抗,所有人共同面对一道本质难题:当研究工具本身开始加速研究进程,谁有权决定下一代 AI 应在何时降临?
本文来自微信公众号“APPSO”,作者:发现明日产品的,36氪经授权发布。













