


7 月 3 日,hashicorp 联合创始人、ghostty 作者 mitchell hashimoto 在社交平台发布了一条简短推文:“i read the code”,迅速引发广泛关注,浏览量逼近 83 万次。
20 天后,软件工程界泰斗 Robert C. Martin(即广为人知的 Uncle Bob,《代码整洁之道》作者,拥有逾六十年编程经验)抛出截然不同的观点:“我完全不去读 Agent 写出来的任何代码。”
两条推文,两位全球顶尖开发者,两种针锋相对的态度,瞬间点燃整个技术社区,掀起一场持续数周的深度思辨风暴。
“我读代码”:理解仍是工程职责的核心
对于 AI 生成的代码,Mitchell Hashimoto 的做法是——亲自阅读。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
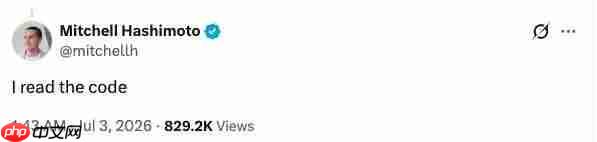
彼时 Anthropic 的 Fable、GPT-5.6 等新一代模型刚刚亮相,编程智能体能力持续跃升,“Vibe Coding”理念的支持者正信心高涨,认为“凭直觉写代码”已获得新一轮技术背书。于是,这条原本仅描述个人工作习惯的三词推文,很快被解读为对 Vibe Coding 风潮的一次明确质疑。
那么问题来了:AI 输出的代码,人类是否仍需逐行审阅?
一方坚持,阅读代码是开发者不可让渡的职业底线。只要代码由你提交、部署并长期维护,你就必须清楚它在做什么,也必须能在故障发生时独立定位与修复。另一方则指出,逐行审查正日益成为低效的“刻舟求剑”:AI 编码速度早已远超人工核查节奏;若继续强求全量阅读,刚被释放的开发效率,又将被审查瓶颈重新拖回原点。
分布式系统专家、《分布式系统可观测性》作者 Cindy Sridharan 表达了极为坚定的立场:“每当我听到有人说‘代码全是 Claude 写的,我根本不知道它怎么运行’,我就断定——此人不具备调试能力。无需争论。无法调试,就谈不上拥有或掌控;而一套连你自己都无法掌控的代码,任何真正重视可靠性与稳定性的团队,都不会将其托付给你。”
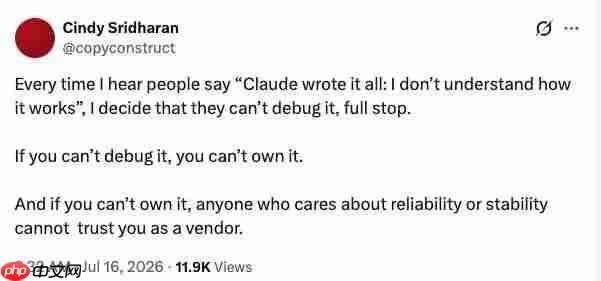
在她看来,能否独立调试,是衡量开发者是否真正掌握代码的硬性标尺。现实中,她屡见开发者直接采纳 Claude 提供的修复方案,却在面对稍复杂的 Bug 时反复试错、耗时良久,才勉强定位根源。
开源工程师 Christine Lemmer-Webber 将这一演进路径命名为 “Vibe 滑坡”:起初,人们谨慎使用 AI 辅助编码,并严格执行代码审查;但随着交付节奏加快,审查标准悄然松动,最终滑向完全依赖直觉的 Vibe Coding。她强调,这种退化往往并非主动选择,而是惯性驱动下的被动滑落。
“人们对这段演进路径的实际掌控力,远低于他们自我感知的程度。”
在效率至上的洪流中,每个质量关卡都可能被悄然弱化,现实中也难以设立真正有效的“急停机制”。更棘手的是,即便是资深程序员,也未必能从一段仅百行的程序中发现全部缺陷。而如今,大语言模型单次输出动辄数百甚至上千行代码,人类要完成全面、深入的审查,其难度正呈指数级攀升。
“我不读”:Uncle Bob 以体系化约束替代人工细读
20 天后,一位更具历史分量的声音加入论战。
Robert C. Martin(Uncle Bob),《代码整洁之道》作者,自 20 世纪 60 年代末投身编程,至今已深耕软件开发六十余载。面对“是否阅读 AI 生成代码”这一提问,他给出斩钉截铁的回答:“我不读。”
导火索来自开发者 Ori Pomerantz 在 X 平台的一段分享:“我正尝试让 Claude 协助开发,但总觉得让它直接修改我的源文件不太安心。有人有同感吗?如果我要为代码负责,就必须理解它——哪怕只是心理层面的需求。”
他还补充道:“1983 年开始编程,算老程序员了吗?”
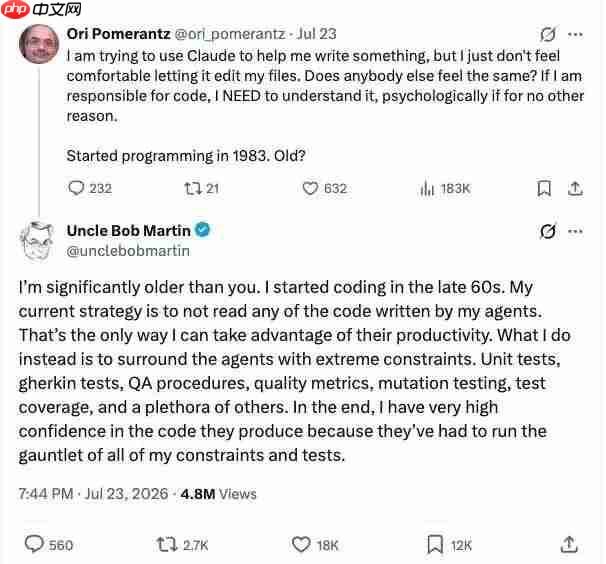
Uncle Bob 回应称,自己入行时间比 Pomerantz 更早,编程资历超过 60 年;但他当前采用的策略,正是“彻底不阅读 Agent 产出的任何代码”。
他的解法是——为 Agent 设置严苛到近乎苛刻的约束体系:单元测试、Gherkin 行为驱动测试、QA 流程、质量门禁、变异测试、覆盖率红线,以及一系列配套保障机制。只有当 AI 生成的代码成功通过所有验证关口,他才会对最终产物抱有“高度信任”。
然而,这条回应并未平息争议,反而激发出更密集的追问。该推文最终收获超 480 万次浏览,热度远超 Mitchell Hashimoto 的“I read the code”。
其中最具穿透力的问题是:若质量保障全系于这些约束,那谁来确保约束本身可靠?
有开发者进一步追问:倘若单元测试、质量指标与检查工具承担起核心把关职能,那么这些约束自身的质量,岂非已成为真正的工程挑战?Uncle Bob 的答案是:同样交由智能体编写这些验证工具。它们具备确定性、规模可控,可用于评估代码质量、校验测试覆盖率,或执行代码修改并观察错误暴露效果。
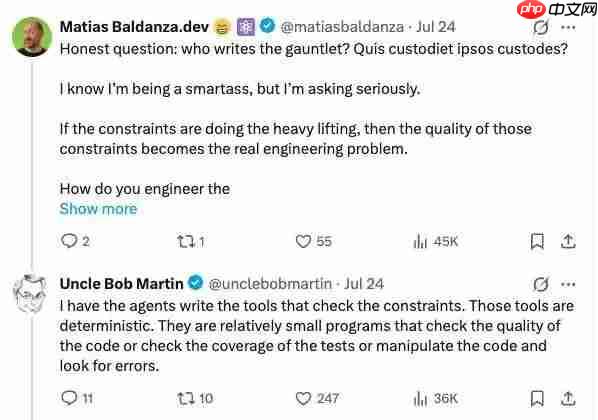

紧接着又一层追问浮现:你会审查这些验证工具本身的代码吗?
Uncle Bob 依旧回答:“不会,流程不变。”这些工具自身也被包裹在海量单元测试与验收测试之中。对他而言,判断一个工具是否可信的唯一依据,就是它能否持续通过验证、稳定达成预期目标。
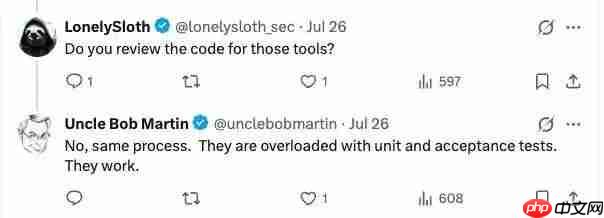
这看似陷入无限递归:Agent 写业务代码 → Agent 写测试 → Agent 写验证测试的工具 → Agent 再写验证工具的测试……Uncle Bob 的应对之道,是构建极其严密的测试生态:借助变异测试、QA 流程、Gherkin 验收测试等多重手段,让测试体系坚不可摧。Agent 若想篡改测试蒙混过关,必须同步修改大量相互耦合的测试用例,成本极高、风险极大。此外,他本人会亲自审核关键任务的 Gherkin 验收测试与 QA 流程,按重要性实施全覆盖或抽样审查,并定期执行最终人工验证。
有趣的是,这套方法论很快被工程化落地。开发者 AmazingAng 推出开源项目 old-coder,其核心哲学直接源自 Uncle Bob:放弃逐行阅读 Agent 代码,转而让代码先闯过一整套自动化验证关卡。
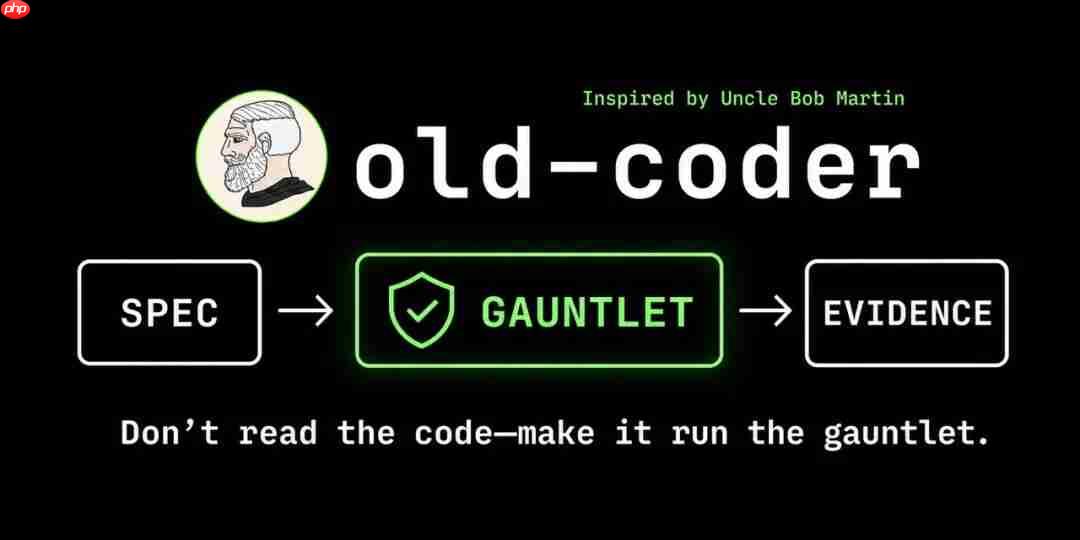
来源:https://www.php.cn/link/66a6fa1a8ebcc108e6ebd9c17e539481
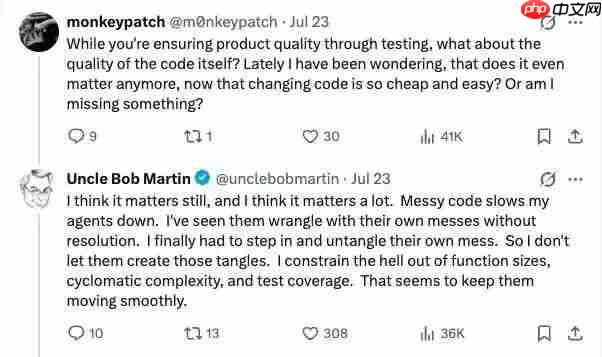
还有人提出:测试或许能保证功能正确,但代码本身的可读性、结构性、可维护性呢?既然如今修改代码如此便捷,代码是否还须如从前那般“整洁”?
对此,Uncle Bob 断言:“代码质量不仅依然重要,而且比以往更关键。”混乱的代码不仅拖慢人类开发者,更会严重阻碍 Agent 的推理与迭代。他曾目睹 Agent 在自身制造的复杂结构中反复打转,始终无法突破困局,最终仍需他手动重构、理清逻辑脉络。
因此,他对函数长度、圈复杂度、测试覆盖率等指标设下极严红线,力求从源头阻止 AI 构建难以维护的代码结构。在他看来,这些前置约束,才是保障 Agent 长期高效协同的关键。
逐行阅读,是旧时代的思维惯性?!
网络上的技术争鸣,常被简化为非此即彼的二元对立:读 or 不读?立场越极端,声量越响,中间地带那些精微的权衡与现实约束,反而被喧嚣淹没。这场围绕 AI 编程的持久讨论,其底层叩问实则更为本质:你究竟如何看待自己所写的代码之价值?
若将代码的重要性置于一条光谱之上:一端是实验性质的个人玩具项目,另一端则是支撑核电站控制系统、心脏起搏器或航空导航的关键基础设施。后者自然不容半点闪失,每一行都关乎生死。但绝大多数开发者,其实活跃于两端之间的广阔中间带——既容易高估自己代码的权重,又常忽视当下已能批量产出大量“非关键性代码”的现实。
t3.gg 创始人 Theo 的观点颇具启发性:对多数工程师而言,当前人工阅读的代码比例很可能过高,而 AI 生成的代码数量却远远不足——我们应最大化挖掘 AI 代码的潜在价值。
如果你正在开发真正至关重要的系统,恰恰更应大量生成一次性验证代码,去穷尽测试那些绝对不能出错的核心模块。这一思路,与 Uncle Bob 以验证体系替代人工理解的路径,在逻辑内核上高度一致。
在那个代码编写成本高昂、每次合并都牵一发而动全身的时代,我们必须投入大量时间阅读他人产出的每一行代码。为验证一行核心逻辑而编写千行测试?显然得不偿失。但今天,情况已然逆转——代码生成成本趋近于零。AI 可在一瞬之间产出千行测试代码;你可以为生产环境中的每一行关键代码,配套生成百行、千行乃至万行验证代码,用于压力测试、变异测试、定制化运行时分析。
定制 lint 规则?过去一生只写一两条,如今可随时批量生成。临时调试工具?以前只能依赖浏览器内置功能,现在可即时构建专属调试器与编译器 Hook。过去做压力测试需协调人力与资源,如今 AI 可自动调度云实例,反复冲击系统边界。
当代码生成成本骤降,“代码”的定义也随之拓宽:它不再仅指最终进入主干的交付产物,还可是一次性实验脚本、边缘场景模拟器、替代实现方案,或是为解答某个具体问题而存在数小时的专用工具。
假设一名工程师每日仍坚持手写并逐行验证 80 行核心代码——这部分标准绝不可妥协。但在此之外,他完全可以借助 AI 生成 800 行甚至 8000 行辅助代码,专门用于验证这 80 行。这些代码永不进入产品,却能覆盖更多异常路径、暴露潜在隐患、显著提升核心逻辑的鲁棒性。
没人会建议将心脏起搏器固件交由 AI 自由发挥。但若某套系统真的重要到“零容错”,那么为其构建更庞大、更纵深的验证体系,理应成为同等优先级的工程实践。关键代码越敏感,围绕它生成的测试、仿真与验证代码,就越应成倍增长。
我们可以将代码划分为四个层级:最顶层是纯粹的“垃圾代码”,仅用于整理文件或解答一次性问题,看一眼都嫌浪费时间;第二层是“希望它能跑通”,出错会令人烦躁;第三层是“最好别崩”,否则可能丢掉饭碗;最底层则是“一旦失效,可能夺命”。
过去,手写代码成本太高,开发者几乎将全部精力倾注于最底层与第三层,无暇向上探索。而今,AI 让顶层与第二层代码近乎免费——你应当大量涌入这些区域,用廉价代码去验证昂贵代码,而非用“所有代码都很重要”这一认知牢笼,将自己永远锁死在底层。
这正是 Uncle Bob 所倡导的“无限递归”验证范式的延伸:用海量低成本代码构筑一座测试金字塔,底部堆满可弃置的验证代码,用整座塔来守护塔尖那一小簇真正不容有失的核心逻辑。
本文来自微信公众号 “InfoQ”(ID:infoqchina),作者:Tina,36氪经授权发布。














