ai 编程似乎正步入一个略显尴尬的阶段。一方面,claude code、cursor、github copilot 等工具正深刻重塑开发流程,越来越多程序员开始借助 ai 编写函数、修复 bug,甚至生成整块功能模块。
但另一方面,开源社区却不得不直面一个现实困境:当一段代码主要由大模型产出,而提交者仅负责复制粘贴时,这份贡献究竟归属于谁?又该由谁来为其负责?
近日,GNU 编译器集合(GCC)社区就因 AI 生成代码问题引发广泛讨论,并最终达成倾向性共识:今年起,将不再接纳任何由 AI/大语言模型 Agent 生成的、具备“法律重要性”的代码贡献。
换言之,GCC 此后将拒收那些可能影响版权归属、许可证合规性或引发法律责任的核心逻辑变更——只要其源头为 AI 或基于 AI 输出衍生而来。
GCC 的核心顾虑:AI 代码最危险之处,不在缺陷本身,而在责任真空
GCC 是全球最具影响力的开源编译器项目之一,支撑着众多 Linux 发行版、嵌入式系统及底层软件生态。
不久前,GCC AI 政策工作组提交了一份关于 AI 使用的政策建议,随后获得 GCC 指导委员会批准并正式对外发布。
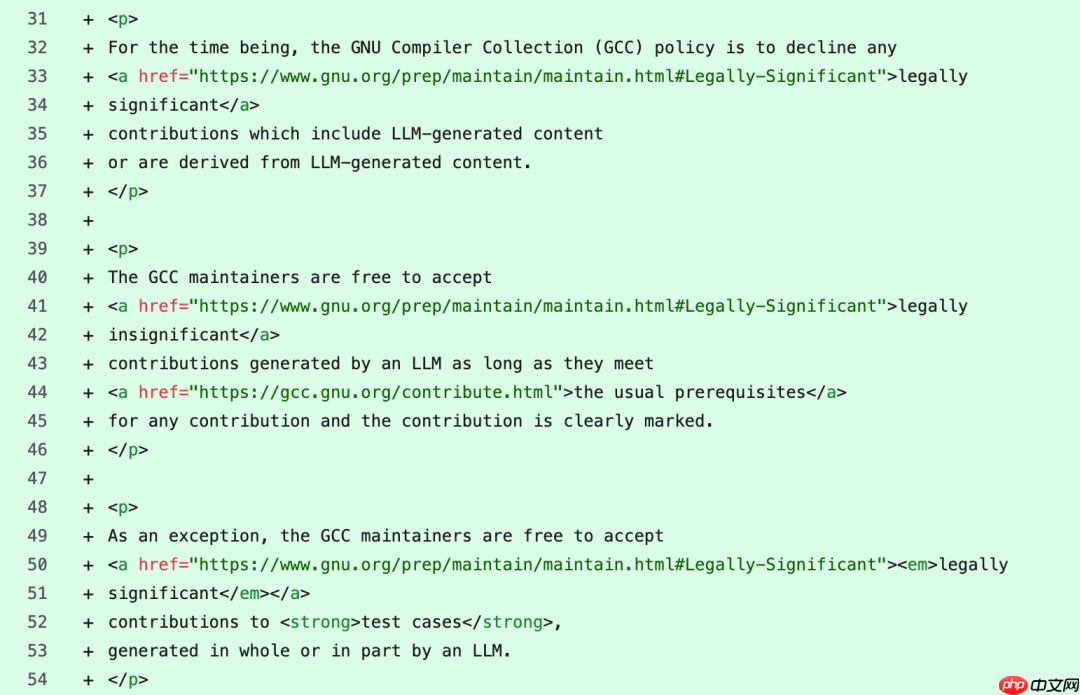
该政策已以原始 HTML 形式提交至项目文档库,其中明确了三项关键原则:
“当前 GCC 的政策是:拒绝所有包含 LLM 生成内容,或源自 LLM 输出、具有法律重大意义的代码贡献。”
“GCC 维护者可酌情接受由 LLM 生成的、法律意义较轻的贡献,但前提是这些提交必须满足全部常规代码贡献要求,并明确标注使用了 LLM。”
“作为例外,GCC 维护者允许接受全部或部分由 LLM 生成的、具有法律重大意义的测试用例类贡献。”
这一立场基本延续了 GNU 项目对 AI/LLM 贡献一贯的审慎态度。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
那么,为何要如此设限?
因为传统开源协作建立在一个至关重要的前提之上:提交代码的人,不仅是作者,更是责任人。
过去,一名开发者向 GCC 提交 Patch,意味着他已通读相关代码,理解修改意图,并愿意接受 Maintainer 的质询与审查。
但在 AI 时代,一种新型提交方式悄然浮现:开发者通过自然语言指令让 LLM 输出代码,再经简单验证即直接提交 Patch。
隐患在于,若 Maintainer 追问:“此处设计依据是什么?”“该优化是否会影响其他架构?”“此 Bug 修复是否覆盖全部边界场景?”
而提交者无法作答时,整个开源协作链条便面临断裂风险。
AI 生成代码的问题,远不止于“质量不可靠”,更在于其背后缺失真实存在的工程判断与技术权衡。
其他开源社区应对策略:Linux 设门槛、Zig 全面封禁 AI 编程
事实上,GCC 并非首个遭遇此类挑战的项目。

过去一年间,大量开源社区观察到一种新型贡献现象:由生成式 AI 驱动的海量低价值 Pull Request。对大型项目而言,真正的瓶颈从来不是编码速度,而是维护者审核成本。
Linux 内核社区对此尤为敏感。
近期,Linux 创始人 Linus Torvalds 对 AI 的态度清晰而务实——他并不排斥 AI 工具本身,反而肯定其在 Bug 探测与效率提升方面的潜力。
但他强烈反对两类行为:一是利用 AI 批量生成无效问题报告;二是提交未经充分验证的代码,徒增维护负担。
正因此,他多次公开强调:“请勿成为那种‘随手扔个不理解的报告就转身离开’的人。”
经内部协商,Linux 社区制定出一套明确规范:AI 可用于辅助开发,但提交者必须真正理解所提交代码,并承担最终责任;AI 不得替代 Developer Certificate of Origin(DCO)签署人的角色。
此外,Linux 内核还引入 Assisted-by 标签机制,要求在涉及 AI 协助的贡献中注明所用工具及模型信息。
相较之下,GCC 和 Linux 属于“有限开放”,而部分项目则采取更严格路径。例如 Zig 编程语言社区,曾明令禁止 AI 生成代码参与贡献。
Zig 维护者指出,大量 AI 产出的 Patch 将显著消耗核心维护者精力,因其审核成本往往高于自行重写。
他们担忧的是:对于小型开源项目而言,本就稀缺的维护人力若每日陷于处理 AI 提交,终将无力推进真正关键的功能演进。
开源生态依赖可信赖的代码根基
AI 技术的爆发式演进,确实在加速重构软件开发范式。但过去数十年,开源世界得以稳健运转,依靠的是一个朴素却关键的共识:每行代码背后,必须站着一个真实、可追溯、可问责的人。
此人或许来自企业,也可能是一位独立开发者,但他需能阐明自己提交的每一处改动,回应社区 Review,并为潜在后果担责。
大语言模型的兴起,正在动摇这一根基假设。
GCC 的决策表明,在基础软件领域,“AI 编程革命”不会被无条件接纳。
对于编译器、操作系统、数据库等维系数字世界运行的关键基础设施而言,代码行数从来不是衡量价值的核心指标。
真正决定其可靠性的,是代码背后的认知深度、责任归属,以及由此构建的信任体系。
AI 可以成为开发者手中更锋利的工具,但在开源世界里,最终被接纳的,永远只能是有人愿为之署名、为之辩护、为之负责的代码。
本文来自微信公众号“CSDN”,整理:苏宓,36氪经授权发布。