


Least Connections算法公平选择连接数最少的健康节点,但长任务会使其连接数持续偏高导致流量绕行;应通过keepalive复用、后端快速释放连接、异步处理长任务、max_conns限流、流量路径隔离及主动健康检查来优化。
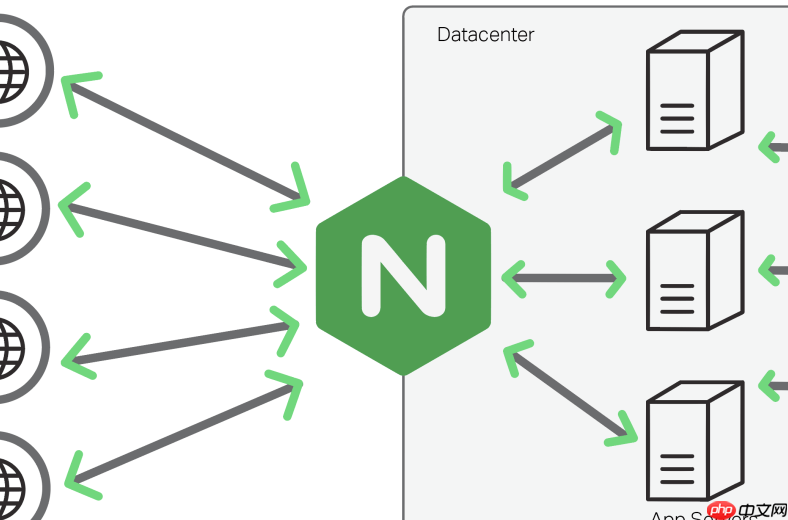
Least Connections 算法本身不会“冷落”节点,它只做一件事:每次新请求来时,选当前活跃连接数最少的健康后端。问题不在于算法偏心,而在于——当某个节点正在处理一个计算量极大、耗时极长的请求时,它的连接数会持续居高不下,导致后续请求不断被导向其他节点,形成事实上的“流量绕行”。这不是冷落,而是算法在如实反映该节点“手头活儿最多”的状态。
让长任务不长期霸占连接数
关键不是阻止 least_conn 发挥作用,而是缩短“长任务占用连接”的时间,避免单个请求把连接数锁死几十秒甚至几分钟:
-
启用 HTTP/1.1 + keepalive 复用:在 upstream 块中加
keepalive 32;,location 中设proxy_http_version 1.1;和proxy_set_header Connection '';。这样 Nginx 与后端复用连接,但连接释放由后端控制——只要后端在响应完成后主动关闭或复用连接,连接数就能及时回落。 -
后端需快速释放连接:例如 Spring Boot 中设置
server.tomcat.connection-timeout=-1(禁用连接超时),并确保maxKeepAliveRequests足够大;FastAPI/Uvicorn 启动时加--keep-alive 5;Node.js 默认支持,但需确认未手动关闭 keep-alive。 - 避免后端长轮询或阻塞式响应:对报表、AI 推理等长任务,建议改用异步模式(如返回 task_id + 轮询结果接口),而不是让单次 HTTP 请求阻塞数秒以上。这样连接能快速释放,least_conn 才有重新调度的机会。
用 max_conns 控制单节点并发上限
即使某节点连接数暂时最低,也不意味着它能无限承接新请求。通过 max_conns 设置硬性容量边界,可防止长任务拖垮整台机器:

- 高性能节点:
server 10.0.1.10:8080 max_conns=2000; - 普通节点:
server 10.0.1.11:8080 max_conns=800; - 专用长任务节点(如 AI 推理):
server 10.0.1.12:8080 max_conns=50;
当某节点活跃 upstream 连接达到 max_conns,Nginx 就自动跳过它——哪怕它此刻连接数仍是“最少”,这相当于给 least_conn 加了一道资源水位阀。
区分流量路径,不让长任务污染调度池
把长耗时请求和短平快请求隔离到不同 upstream,是最直接有效的解法:
- 为报表、导出、模型推理等单独建一个 upstream,启用
least_conn+max_conns=30–100,并配合较宽松的超时(proxy_read_timeout 300;); - 普通 API 请求走另一组 upstream,可用轮询或一致性哈希,保持低延迟响应;
- 避免混用策略——不要在一个 upstream 里既跑毫秒级查询又跑分钟级任务,否则 least_conn 的“最少连接”就失去了业务意义。
健康检查必须主动且敏感
如果某节点因 GC、锁表或线程池满而卡顿,但 TCP 连接没断、HTTP 响应也没超时,least_conn 会误判它“还空闲”。此时被动检查(靠失败触发)无效,必须靠主动探测:
- 使用 OpenResty 或打过补丁的 Nginx,配置:
health_check interval=3 fails=2 passes=2 match=status_ok; - 或至少启用被动兜底:
proxy_next_upstream error timeout http_500 http_502 http_504;
配合每个 server 的max_fails=2 fail_timeout=15s,确保慢到超时也能被临时剔除。









