


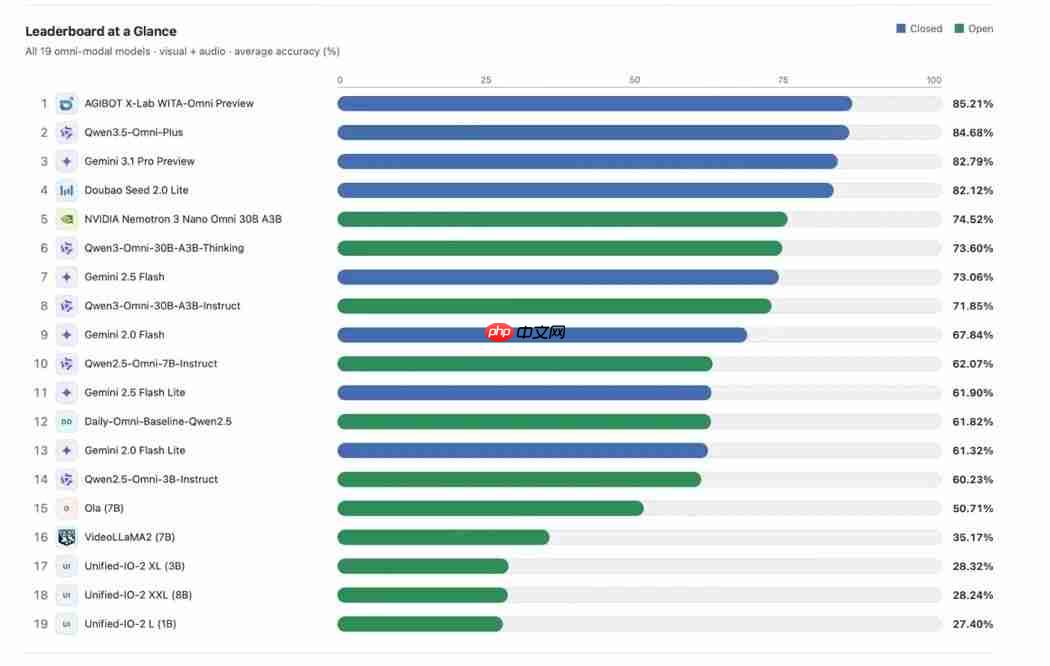
【php中文网快讯】7月28日,智元机器人官方公众号正式发布消息:其自主研发的具身原生全模态大模型——wita-omni preview,在音视频联合感知与动态时序推理方面表现卓越,以85.21分的总分荣登全球具身全模态理解权威评测榜单 dailyomni 榜首,力压通义千问、google gemini、字节豆包、nvidia 等国内外主流大模型,并在全部八项细分能力评估中,于六项指标斩获第一。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
 图片来源:智元官方公众号,下同
据悉,DailyOmni 是业内广泛认可的第三方评测平台,专注于评估模型在真实场景下对音视频流的时序对齐能力、跨模态语义融合能力及动态事件推理能力。不同于传统图文或单帧短视频理解任务,该榜单大量采用来自开放环境的真实音视频数据,重点检验模型能否精准识别声画一致性、理解动作发生顺序、并完成视觉-听觉信息的协同建模——这些能力正是人形机器人实现自然、可靠人机交互所依赖的核心感知基础。
架构突破:从 Thinker–Talker 升级为 Thinker–Talker–Actor,打通“感知—决策—执行”闭环
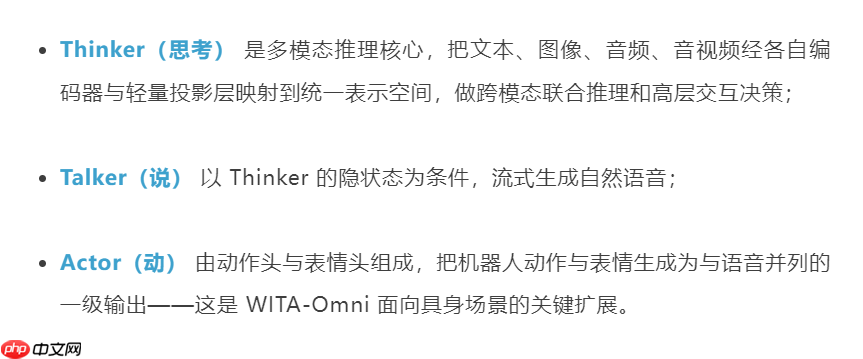
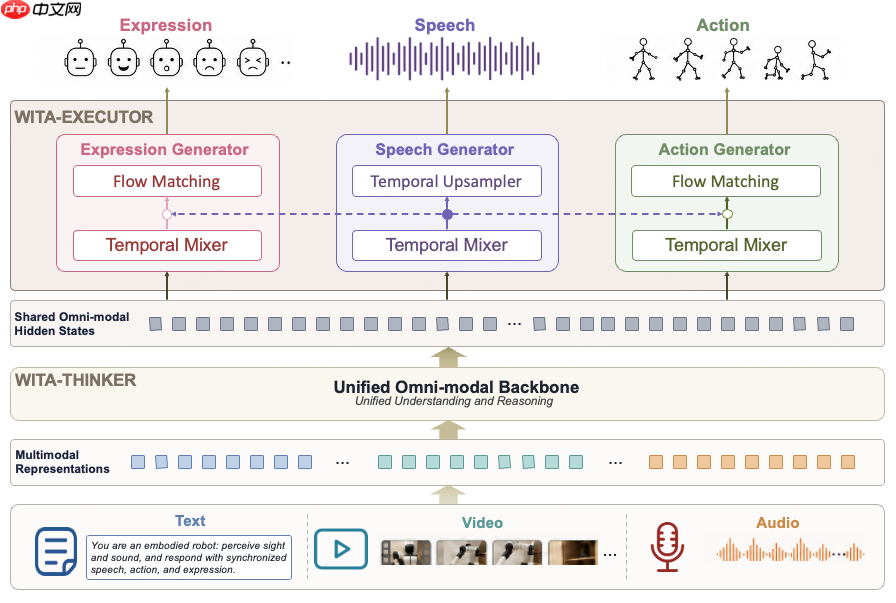
对于具身智能体而言,理解世界与做出反应本是一体两面的物理闭环过程。WITA-Omni 并未沿用将通用语言模型简单适配至机器人硬件的传统路径,而是将肢体动作、微表情等具身信号与语音输出置于同等建模优先级,首创端到端原生具身交互架构:Thinker(认知中枢)、Talker(语言表达)、Actor(行为执行)三位一体。
立即进入“豆包AI人工智官网入口”;
立即学习“豆包AI人工智能在线问答入口”;
 性能根基:分层数据体系 + 三阶段渐进式训练

从零搭建飞书机器人。支持 MiniMax/MiMo 等模型、工具调用(搜索/天气/百科/记忆)、Skill 架构。一站式交付可上线运行的飞书群聊 bot。基础版本,后续可自行升级能力
WITA-Omni 的领先性能并非源于盲目堆叠参数规模,而源自一套专为具身多模态交互定制的分层数据构建逻辑与精细化训练范式。
在基础训练阶段,模型融合千万小时级自研与高质量开源多模态数据,夯实图文理解底座,同步构建支持视听联合推理的全模态骨干网络。
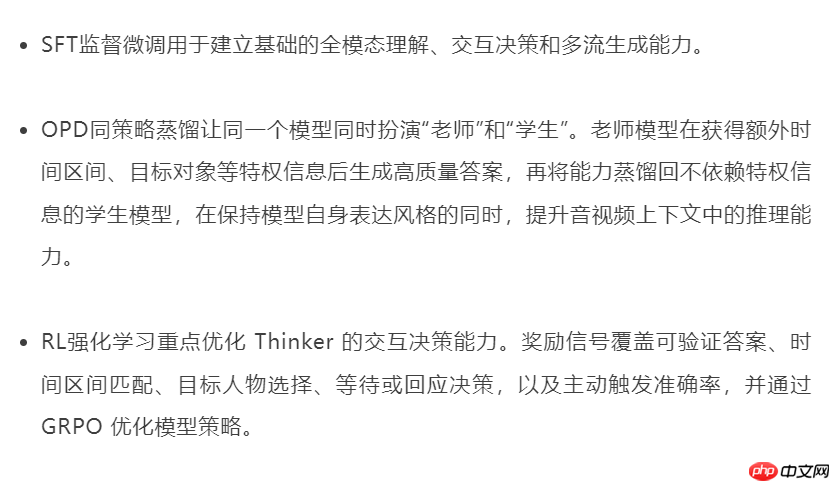
训练流程采用 SFT(监督微调)→ OPD(开放式偏好对齐)→ RL(强化学习反馈优化)三阶段递进策略,使模型具备自主判断“是否应答、何时应答、向谁应答”的上下文感知与交互意图识别能力。
 产业意义:端到端原生架构加速具身智能商业化落地
智元此次登顶 DailyOmni,不仅印证了 WITA-Omni 在物理世界音视频时序建模任务中的显著优势,更标志着其成为全球首个真正面向机器人本体设计、具备完整端到端多模态交互能力的大模型。
该模型的实质性突破,不止在于扩展了输入模态的种类,更在于实现了感知、认知、动作在统一时间轴与统一语义空间下的深度耦合与协同演化。














