





Nginx无法自动感知后端磁盘满状态,weight为静态参数不随磁盘状态动态调整;可通过weight=0临时下线节点并配合被动或主动健康检查实现自动剔除,再结合日志与监控及时识别和恢复。
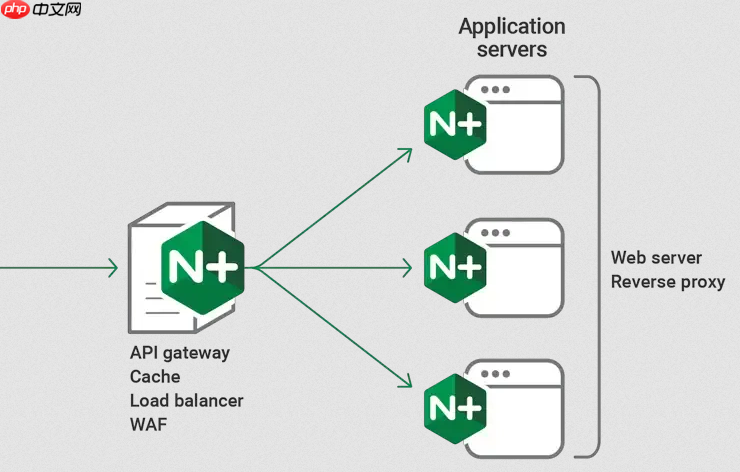
Nginx 本身无法自动感知后端服务器磁盘是否写满,也就不能基于磁盘状态动态调整 weight。weight 是静态配置参数,只在 Nginx 加载配置时读取一次,不随后端健康状况实时变化。但你可以通过“临时下线 + 健康检查联动”的方式,实现等效于“权重置零”的效果——即让流量完全不再打到那台磁盘已满的服务器上。
用 weight=0 实现人工临时下线
weight=0 不是“禁用权重”,而是 Nginx 官方支持的显式停用节点方式:
- 该节点仍参与健康检查(如
max_fails/fail_timeout或主动探针) - 但只要状态为“健康”,Nginx 就永不向其转发请求(流量分配比例中占比为 0)
- 配置生效只需重载(
nginx -s reload),无需重启
✅ 正确写法(在 upstream 块内):
upstream backend {
    server 192.168.1.10:8080 weight=5;   # 正常节点
    server 192.168.1.11:8080 weight=0;   # 磁盘满时手动设为 0
}
⚠️ 注意:weight=0 不等于“移除”,它保留了节点记录,方便快速恢复(改回非零值并 reload 即可)。
必须配合健康检查,否则 weight=0 失去意义
磁盘写满通常会导致后端服务响应变慢、超时或直接失败。仅靠 weight=0 是被动操作,真正要防住的是——还没来得及人工干预时,流量就已打过去。所以必须启用自动剔除机制:
-
启用基础被动检查(推荐必配):
upstream backend {
    server 192.168.1.10:8080 weight=5 max_fails=3 fail_timeout=30s;
    server 192.168.1.11:8080 weight=0 max_fails=3 fail_timeout=30s;
}
当磁盘满引发连续 3 次超时(默认
proxy_next_upstream timeout error),Nginx 会自动将该节点标记为unavailable,即使weight非零也跳过——这是比人工改weight=0更及时的兜底。 -
对关键业务,建议加主动健康检查(需编译
nginx_upstream_check_module):upstream backend { check interval=3 rise=2 fall=3 timeout=1 type=http; check_http_send "HEAD /health HTTP/1.0\r\n\r\n"; check_http_expect_alive http_2xx http_3xx; server 192.168.1.10:8080 weight=5; server 192.168.1.11:8080 weight=0; }主动探活
/health接口,若返回非 2xx/3xx(比如磁盘满时返回 503 或超时),立即踢出节点。

磁盘写满的典型表现与提前识别建议
后端磁盘满不会立刻报错,但会逐步暴露在 Nginx 日志和指标中:
-
error.log出现大量upstream timed out (110: Connection timed out)或no live upstreams while connecting to upstream -
access.log中对应 IP 的502/504状态码突增 -
proxy_next_upstream统计显示某节点失败率飙升(可通过 Prometheus +nginx_vts模块监控)
发现异常后,应:
- 登录后端服务器,运行
df -h确认/或应用日志/临时目录是否 100% - 若确认磁盘满,立即执行
weight=0+ reload,并清理磁盘(如删旧日志、清缓存) - 恢复后,先观察 5 分钟无错误,再将
weight改回原值(如从0改为5),reload 切回流量
不复杂但容易忽略














