


Least Connections算法因内存泄漏导致“假死”连接污染连接数统计,使新请求堆积、延迟飙升;需通过连接状态、内存监控、健康检查等交叉验证并实施限流与超时优化。
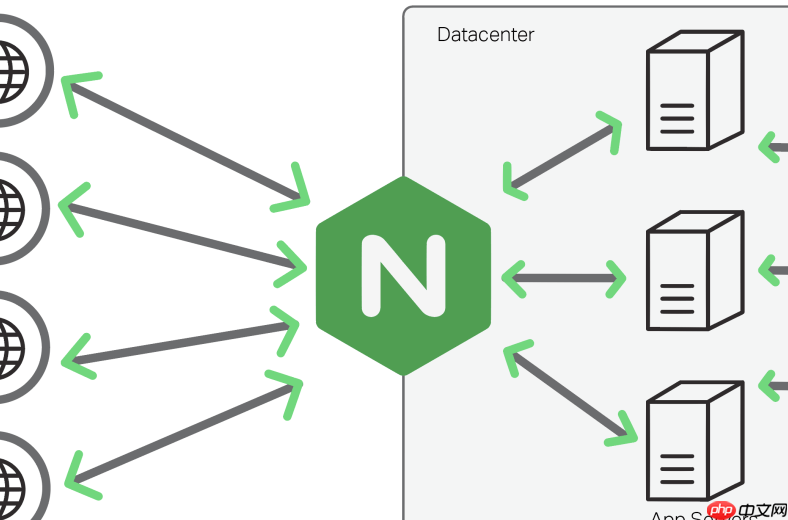
Least Connections 算法本身不感知内存状态,但后端内存泄漏引发的“假死”会直接污染连接数统计——连接长期挂起不释放,least_conn 却仍视其为“可用”,导致新请求持续堆积、延迟飙升。排查关键在于:**确认连接数异常升高是否由内存泄漏驱动的假死连接造成,而非单纯高负载**。
看连接状态是否“低活跃、高滞留”
least_conn 依赖的“活跃连接数”必须真实反映后端处理能力。内存泄漏常导致线程阻塞、GC 停顿或 goroutine 泄漏,表现为:
- 连接已建立、请求已发出,但响应迟迟不来(upstream_response_time 有值但远小于 request_time)
- 同一后端节点在 /nginx_status 中 active connections 持续维持在 5–20 区间,既不高到触发 max_fails,也不归零,且 upstream_connect_time 稳定但 upstream_header_time 显著拉长
- 错误日志中反复出现 "recv() failed (104: Connection reset by peer)",说明后端进程还在跑,但处理中途主动 RST 断连——这是内存耗尽触发 runtime panic 或 OOM Killer 杀进程前的典型信号
查后端内存与连接池是否失配
内存泄漏不会立刻宕机,但会逐步侵蚀连接处理能力。需交叉验证:

- 登录对应后端机器,运行 free -h && top -b -n1 | grep nginx\|java\|node,观察 RSS 是否随时间单向增长、swap 是否被使用
- 检查后端连接池配置是否与 Nginx keepalive 冲突:例如 Tomcat 的 maxKeepAliveRequests=100 但 Nginx upstream keepalive 32,若后端提前关闭空闲连接,Nginx 会误判为连接泄漏,连接数虚高
- 调用后端健康接口(如 /actuator/health),重点看 diskSpace、db、threadPool 子项是否超阈值或响应超时——内存泄漏常伴随线程池满、数据库连接获取失败
验 Nginx 是否因假死连接误判“低压力”
least_conn 选中一个节点,只因它的 active connections 数字小,但这个数字可能全是“僵尸连接”。验证方法:
- 用 ss -tan state established | grep :8080 | wc -l 在后端本机统计真实 ESTABLISHED 连接数,对比 Nginx stub_status 显示值:若后者显著偏高,说明 Nginx 认为还在复用的连接,后端早已关闭或卡死
- 开启 access_log 自定义字段:$upstream_addr $upstream_connect_time $upstream_header_time $upstream_response_time,筛选出某台后端所有请求,看是否存在大量连接耗时集中在 proxy_read_timeout 边界(如 10s),且 header_time 接近 timeout ——这是内存卡死后无法写出响应头的铁证
- 临时给该后端加 max_conns=1,观察流量是否立即切走;若仍持续转发并报 502,则证实 least_conn 正在被虚假连接数误导
堵住泄漏路径并强制收敛
发现确由内存泄漏引发假死后,不能只等自动恢复,要主动干预:
- 在 upstream server 行中加入 max_conns=50(根据实际线程池大小设为 1/2~1/3),让 least_conn 在连接数达限时自动跳过,相当于对泄漏节点做硬限流
- 收紧 proxy_read_timeout 8s(比后端业务超时少 2s),配合 proxy_next_upstream timeout http_504,确保慢响应尽早重试,避免连接长期占位
- 启用主动健康检查:health_check interval=5 fails=1 passes=2 match=http_2xx;,探测路径必须包含内存敏感逻辑(如调用含缓存预热的 /health/full),而非静态 200
- 后端侧同步采集 jstat -gc 或 pprof heap,确认 old gen 持续增长、GCLockerInitiatedGC 频发,即可锁定泄漏源头











