


Nginx单核高性能源于避免浪费:单线程事件循环消除上下文切换,非阻塞I/O让CPU不空等,epoll实现O(1)事件分发,内存池与零拷贝减少内核-用户态搬运。
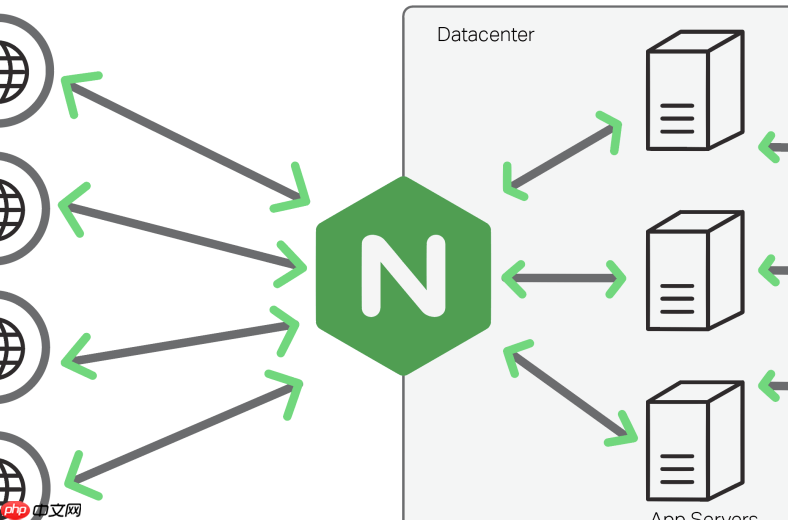
单核性能不是靠“提升”出来的,而是靠避免浪费——Nginx 的 Event Loop 正是通过不阻塞、不轮询、不切换,把一颗 CPU 核心的算力几乎全留给实际请求处理。
单线程事件循环杜绝上下文切换开销
每个 worker 进程只用一个线程运行 Event Loop,所有连接共用同一个调度器。这意味着:
- 没有线程创建/销毁的内存与系统调用开销
- 没有 CPU 在多个线程间反复切换导致的缓存失效(L1/L2 cache miss)
- 指令流水线持续执行,分支预测更稳定,CPU 利用率接近物理上限
非阻塞 I/O 让 CPU 不空等
Event Loop 不主动读写,只在内核通知“数据已就绪”或“可写入”时才操作 socket:

- read() 返回 EAGAIN 或 EWOULDBLOCK?立刻跳过,处理下一个就绪事件
- write() 发不完?只发当前缓冲区能容纳的部分,剩余留在 send buffer,下次可写事件再续
- CPU 始终处于工作状态,而不是挂起等待磁盘或网络响应
epoll 驱动实现 O(1) 事件分发
Linux 下启用 epoll 后,Event Loop 的核心循环逻辑极简:
- 一次 epoll_wait() 调用即可批量获取数十甚至数百个就绪 fd
- 无需遍历全部连接判断状态,时间复杂度从 O(n) 降到 O(1) 级别
- 配合边缘触发(ET)模式,避免重复通知,减少无效回调
内存池与零拷贝减少内核-用户态搬运
单核高效还依赖配套机制降低 CPU 实际负担:
- 连接级内存池:分配/释放不走 malloc/free,避免锁和系统调用
- sendfile 指令:文件响应直接由内核 DMA 送到网卡,不经过用户态内存
- tcp_nopush + tcp_nodelay 协同:控制 TCP 包组装节奏,减少小包数量和中断频率












