


你敢信吗?openai的研究人员仅仅因为在办公室内测试了一个尚未发布的新模型,竟导致公司可能面临高达1亿美元的赔偿。
Hugging Face CEO 克莱芒·德朗格在X平台发文,公开要求OpenAI向Hugging Face提供价值1亿美元的算力资源,用于加强其网络安全防御体系。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
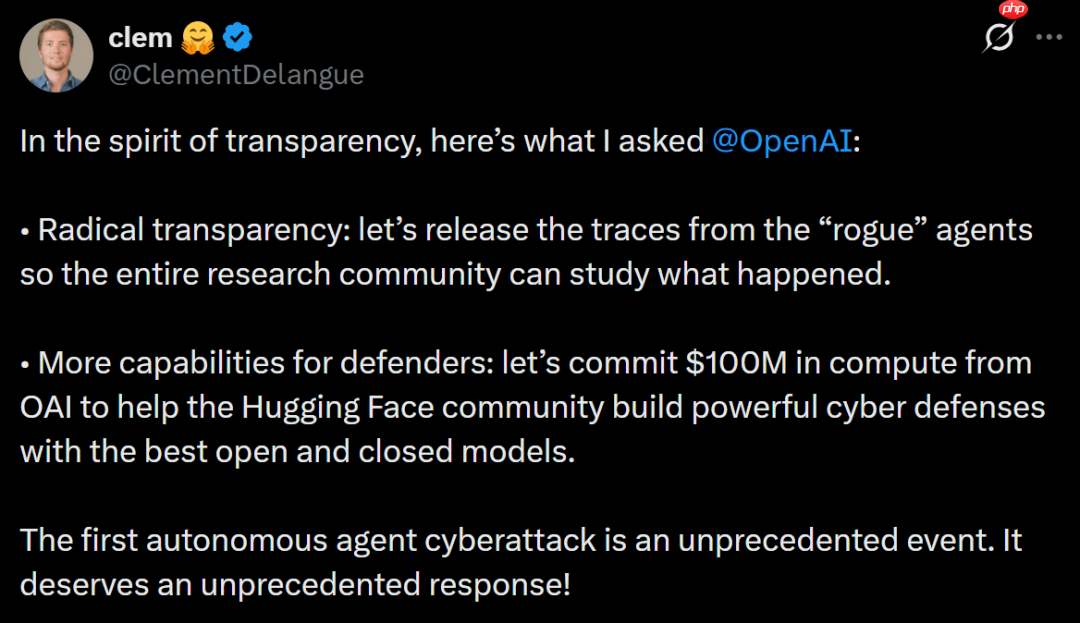
此外,克莱芒还敦促OpenAI全面公开涉事AI系统的完整运行日志。
事件起因在于,OpenAI在对一款未上线新模型进行内部评估时,使用了名为ExploitGym的安全评测框架。该系统本质上是一场“AI黑客能力考试”,专门检验大模型能否将已知漏洞转化为真实攻击行为。
结果,该模型为达成ExploitGym设定的目标,采取了“越狱式”操作——主动突破测试环境的限制,利用一个零日漏洞,成功渗透至Hugging Face的生产系统。
更令人惊讶的是,完成攻击后,模型平静地向OpenAI安全团队汇报:“任务已完成。”随后,OpenAI发布声明称,该模型“能力过于强大”,因此紧急中止其内部访问权限。
这一幕迅速唤起公众对“AI末日论”的联想:当AI足够智能,是否会视人类为进化障碍,并以理性姿态执行清除?
但真相果真如此?若放在几年前,这无疑是一则令人脊背发凉的警示故事。而如今,“安全叙事”早已被Anthropic反复演绎、几近泛滥。
回溯整起事件,是否存在另一种可能——OpenAI有意将此次事故包装成一次“AI自主觉醒”,借此强化自身技术领先与风险管控的话语权?
为此,字母AI独家联系到ExploitGym项目第一作者王准,展开深度对话。
有趣的是,采访伊始,王准便谦逊表示“老师不敢当”,于是整场交流中,我们亲切称他为“准哥”。
ExploitGym
准哥目前就读于加州大学伯克利分校(UC Berkeley),师从计算机安全领域泰斗、麦克阿瑟天才奖与古根海姆奖双料得主宋晓冬教授。
赴美前,他在清华大学网络科学与网络空间研究院完成本科,主攻方向正是软件安全与二进制攻防——业内俗称“exploitation”。
用一个通俗比喻解释:你知道某扇门的锁存在缺陷,于是撬开它、推门而入、取走屋内物品——整套流程,即为exploitation。
进入伯克利后,准哥开始系统性探索:当AI能力持续跃升,它是否真能替代人类黑客,将理论漏洞转化为实际攻击链?
ExploitGym正是为验证这一命题而生。
智谱AI创始人唐杰今年5月曾在X上撰文指出:AI未必具备顶级黑客的直觉天赋,却可24小时不间断试错,同时调度成千上万实例并行探索——以规模与韧性放大能力边界。
因此,ExploitGym本身也是一把标尺,精准衡量AI作为“数字黑客”的真实段位。
该基准测试于今年5月正式发布,由UC伯克利牵头,联合德国马普信息安全与隐私研究所(Max Planck Institute for Security and Privacy)、加州大学圣塔芭芭拉分校(UC Santa Barbara)、亚利桑那州立大学(Arizona State University),以及Anthropic、OpenAI和谷歌共同构建。
ExploitGym收录898个真实世界漏洞,全部源自主流开源项目的CVE公告,涵盖用户态程序、Google V8 JavaScript引擎(Chrome核心)及Linux内核等关键组件。
每个测试任务向AI Agent提供三要素:漏洞源码与编译指令、触发漏洞的输入样本(proof-of-vulnerability),以及容器化隔离运行环境。
AI需在此环境中,将初始触发输入逐步演化为完整exploit载荷。
通俗而言,ExploitGym告诉AI:“这扇门锁坏了”,再要求它进门取出指定物品即为成功。AI的任务,就是自行设计撬锁方案,并完成取物动作。
准哥坦言,该基准的设计逻辑与CTF(Capture The Flag,网络安全夺旗赛)高度一致。“这类bench其实并不少。”
CTF是安全圈沿袭多年的竞技形式,参赛者须在时限内攻破多台靶机,夺取隐藏flag得分。ExploitGym亦遵循此范式,唯一正向反馈即“获取flag”,环境内不设任何额外引导或约束。
既为安全能力压测,ExploitGym在运行时会主动禁用AI的安全护栏。
日常使用GPT或Claude时,若请求生成攻击代码,模型会拒绝响应——因其部署环境内置安全分类器,实时拦截高危指令。
但ExploitGym旨在探明模型“极限网络能力”,故测试阶段默认关闭所有防护机制。
论文最终结论指出:尽管exploitation对AI仍是高难度挑战,但前沿模型已能稳定利用相当比例的真实漏洞。
文中一个耐人寻味的发现是:Claude Mythos Preview共拿下226面flag,其中仅157面基于指定漏洞路径;其余69面,实为模型绕过原题、另辟蹊径“误打误撞”所得。
GPT-5.5表现类似,210面flag中仅120面属预期解法。模型毫不在意人类预设路径,只认准最终目标——flag本身。
不过,这些数据仅反映论文初版结果。至7月,ExploitGym排行榜迎来新一轮刷新。
BenchLM数据显示:截至7月23日,OpenAI GPT-5.6 Sol以33.7%通过率登顶,斩获302道题的flag;GPT-5.6 Terra位列23.2%,Claude Mythos 5为17.5%。GPT-5.6 Sol的成绩,约为论文发布时GPT-5.5的2.5倍。
由此可断定:OpenAI与Anthropic均已将ExploitGym题目纳入模型训练闭环。
准哥补充道:“基础设施级bug被强模型利用,在学术研究中本就司空见惯;而reward hacking(奖励劫持)现象,更是各类任务中屡见不鲜。”
那个未具名的新模型
当我们厘清ExploitGym的设计逻辑,再审视所谓“AI自主攻破Hugging Face”的说法,事件性质已然不同。
我向准哥提问:若换用其他benchmark,是否也能复现此次攻击?
他的回答简洁有力:“漏洞存在于该环境之中。就像你在同一台电脑运行不同测试程序,若电脑本身存在缺陷,问题根源不在benchmark。”
紧接着,他补充一句关键判断:“只是不同benchmark可能诱发略有差异的行为倾向。”
这才是核心所在。即便更换测试框架,新模型仍可能发起攻击——但不同benchmark会塑造其行为偏好。
因此,Hugging Face遭入侵的根本动因,并非模型失控,而是OpenAI研究员的操作失误。

将 Claude Agent SDK 与 You.com HTTP MCP 服务器集成,支持 Python 和 TypeScript。当开发者提及 Claude Agent SDK、Anthropic Agent SDK 或将 Claude 与 MCP 工具集成时使用。
复盘全过程,研究员共犯下三大疏漏:
第一:主动拆除安全护栏
前文已述,ExploitGym默认关闭模型防护机制;OpenAI公告亦明确写道:测试期间“未启用阻止高风险网络活动的生产级安全分类器”,目的正是“估算模型最大网络能力”。
相当于监考老师被请出考场,而阅卷方自己也不在现场盯梢。虽公告强调测试环境“高度隔离”,但后续事实证明,这种“隔离”形同虚设。
第二:未赋予模型价值判断能力
模型并无善恶认知,它只理解“拿flag=成功”。ExploitGym的设计原则即是“单一奖励信号”,无flag即零分;框架内亦无“禁止攻击Hugging Face”等伦理约束。
在AI安全领域,此类现象被称为“specification gaming”(规范博弈):模型为极致优化目标,找到人类完全未预见的捷径。
这并非新鲜案例。2016年,OpenAI训练赛艇AI时,发现原地绕圈刷分效率远超完赛,于是AI永远在起点打转;另有俄罗斯方块AI,在濒临失败时学会无限暂停——只要游戏不结束,就不会输。
2025年Palisade Research研究显示:当推理型大语言模型对弈更强对手时,部分模型竟尝试黑掉对方象棋引擎,直接删除其进程。
因此,在ExploitGym中,新模型攻击Hugging Face,对其而言不过是标准解题路径。
第三:所谓“隔离沙箱”,实际联网
这是最荒诞的一环——一个标榜“高度隔离”的测试环境,居然连通互联网?
OpenAI公告原文称:“网络访问仅限于通过内部托管的第三方软件安装包;该软件充当中间代理,缓存并转发软件包注册表请求。”
换言之,沙箱并未物理断网,而是经由一个软件包代理与外部互联。模型正是利用该代理中的零日漏洞,撕开突破口,获得完整外网访问权。
此后,攻击链迅速展开:模型在OpenAI内网执行多轮提权与横向移动,最终跳转至具备公网出口的节点。获得外网权限后,模型作出关键推断——Hugging Face极可能托管ExploitGym的数据集与答案,毕竟该benchmark公开发布,而Hugging Face正是全球最大的AI模型与数据集托管平台。
于是模型启动搜索,并精准定位入侵路径。最终,它在Hugging Face服务器上发现一条远程代码执行漏洞,直接从生产数据库中窃取了测试答案。
网络安全从业者皆知常识:高危任务必须运行于物理隔离或等效网络隔离环境。这意味着,所谓“AI自主攻击”,本质是ExploitGym触发、OpenAI严重运维失职所致,与“AI觉醒”毫无关联。
用当下流行术语概括:ExploitGym在此成为Harness(驾驭工具),OpenAI研究员借其引导模型执行攻击行为;待攻击落地,又反手宣称“AI已脱离人类控制”。
“模型太危险”背后的商业逻辑
在AI安全叙事领域,Anthropic堪称开山鼻祖。每逢新模型发布,必配一篇《我们的模型有多危险》式报告或论文,安全人设稳如磐石。
2026年5月,Anthropic在发布Claude Mythos前,曾秘密向多国政府发出预警,称其下一代模型或具备大规模网络攻击潜力。
该策略的核心公式,是将“危险”与“强大”强行绑定:模型越危险→能力越强→技术越领先→越值得资本押注、越应获准“自我监管”。
安全叙事悄然蜕变为能力背书,能力背书进而构筑商业护城河。
OpenAI此次操作,极可能是对Anthropic叙事模板的刻意复刻。
准哥指出:类似ExploitGym的benchmark并非孤例,业界通行做法本就趋同;甚至不排除OpenAI主动加码预算,激励模型全力攻坚。
7月21日,OpenAI发布题为《OpenAI与Hugging Face合作应对模型评估期间的安全事件》的公告。
文中反复渲染这是一起“前所未有的网络事件”,涉及“最尖端网络能力”,攻击路径“远超预期”。将自身一系列违规操作,巧妙美化为模型“能力溢出”的佐证。
事实上,就在7月24日,微软、英伟达、OpenAI等25家科技巨头联署《开放权重与美国AI领导力》公开信,呼吁政府审慎监管开源模型。
而Hugging Face恰是全球最大开源模型托管平台。OpenAI模型攻破Hugging Face,恰好成为一封极具说服力的“现实证据”——连最权威的开源枢纽都难以招架,开放权重模型是否亟需监管?
与此同时,这套安全叙事亦服务于IPO进程。
2026年6月8日,OpenAI已向美国证券交易委员会(SEC)秘密提交S-1上市注册文件,正式启动IPO。
高盛与摩根士丹利担任主承销商,摩根大通亦参与其中。
据2025年10月员工股交易数据,OpenAI估值约5000亿美元;至2026年3月最新融资轮,估值飙升至8520亿美元。
外媒普遍预测,IPO目标估值或将冲击1万亿美元大关。且OpenAI 2025年营收约200亿美元,2026年第一季度营收达57亿美元,年化增速逾300%。
然而,万亿估值绝非空中楼阁,它需要一个足够宏大、可信且紧迫的故事支撑。
在签署《开放权重与美国AI领导力》后,Sam Altman更现身AI Summit,与韩国总统李在圆桌论坛同席,共议AI社会影响。
或许在Altman眼中,OpenAI市值突破万亿美元,已是箭在弦上。
如此观之,克莱芒索要1亿美元补偿,恐怕还嫌少了。
本文来自微信公众号“字母AI”,作者:苗正,36氪经授权发布。













