


调整 proxy_buffer_size 不能直接解决偶发性超时,但可防止响应头过大引发的502错误;真正影响超时的是缓冲阻塞导致 proxy_read_timeout 或 proxy_send_timeout 耗尽,需先排查后端是否返回超长响应头,再合理设置 proxy_buffer_size(如实测5200字节则设8k),并同步调优 proxy_buffers、proxy_busy_buffers_size 及超时参数,同时优先精简后端响应头。
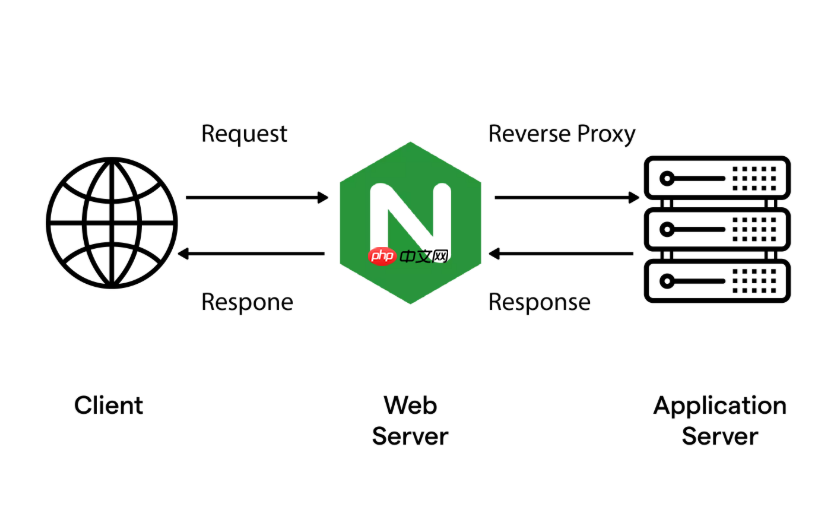
调整 proxy_buffer_size 本身不能直接解决“偶发性超时”,但它能防止因响应头过大触发的 502 错误或连接中断,这类问题常被误判为“超时”。真正影响超时表现的,是缓冲区卡住后导致 Nginx 无法继续读取或转发响应,进而耗尽 proxy_read_timeout 或 proxy_send_timeout。所以调优要从“避免缓冲阻塞”入手,而非单纯拉长超时时间。
先确认是不是响应头真超限
很多所谓“偶发超时”实际源于后端不稳定地返回超长响应头(比如调试开关偶尔打开、链路追踪头重复注入、Cookie 被多次 Set)。不排查就调参,容易掩盖真实问题:
- 用
curl -v http://your-backend/endpoint 2>&1 | grep '^<' | wc -c统计实际响应头字节数(含 CRLF) - 查 Nginx error log,重点看是否反复出现
upstream sent too big header while reading response header from upstream - 对比不同请求路径或不同环境(如 dev/staging/prod),确认超长头是否只在特定条件下出现
合理设置 proxy_buffer_size 并对齐其他缓冲参数
proxy_buffer_size 只管响应头,设得过大不仅浪费内存,还可能让单个请求占用更多 Worker 固定开销;设得太小则频繁触发 502。关键是实测 + 对齐:

FastAPI Flask Proxy
下载
FastAPI + Flask 混合部署最佳实践,解决路由定义、API 代理等常见问题,适用于同时运行 FastAPI API 与 Flask 前端的场景。
- 实测头大小为 5200 字节 → 建议设
proxy_buffer_size 8k(留 20%~30% 余量,且为 2 的幂次) - 必须确保
proxy_buffer_size ≤ 单个 proxy_buffers 的大小,例如proxy_buffers 16 16k,那proxy_buffer_size最大只能设 16k,设 32k 会导致 Nginx 启动失败 - 同步配好
proxy_buffers和proxy_busy_buffers_size:比如proxy_buffers 16 16k(共 256KB),proxy_busy_buffers_size 32k(建议为单 buffer 大小的 2 倍)
配合超时参数释放卡住的连接
即使缓冲区配得合适,如果后端响应慢、客户端接收慢,缓冲区仍可能长期挂起,最终耗尽超时。需让 Nginx 主动“放手”:
-
proxy_read_timeout控制 Nginx 从后端读数据的间隔超时(不是整个响应时间),对 API 类接口建议 60,对导出类可提到 300~600 -
proxy_send_timeout控制向客户端发送数据的间隔超时,弱网或移动端建议设为 90~120 - 避免把超时设得过大(如 3600),否则 Worker 会长期阻塞在积压缓冲上,反而加剧资源耗尽
优先从后端清理冗余响应头
最有效、零成本的“防溢出”方式,是砍掉不必要的头:
- 关掉后端调试模式(如 Spring Boot 的
trace=true、Node.js 的debugheader) - 合并或缩短
Set-Cookie(避免多次设置同域名 Cookie)、精简 JWT token 传输方式(如改用 short-lived token + refresh) - 限制链路追踪头长度,或只在采样率 > 0 时注入
traceparent等字段 - 用
proxy_hide_header主动屏蔽非必要头,如X-Powered-By、Server、X-Debug-Info











