


ai模型的scaling law目前尚未触达瓶颈,无论在语言大模型、多模态模型,还是物理ai领域,持续增加算力与模型规模,依然能观测到性能的稳步提升。
然而,单纯依靠堆砌算力、盲目扩大模型体量的“狂奔式”Scaling路径,已逐渐失去创新活力。更重要的是,超大规模模型难以适配多样化部署场景——尤其在物理AI落地过程中,端侧设备受限于算力、功耗、体积与散热等硬性约束,无法承载动辄数十GB的模型。
由加州理工学院(Caltech)教授创立的PrismML,正探索一条与主流范式迥异的技术路线:不再执着于无限放大模型与算力,而是聚焦于提升模型的“智能密度”。
PrismML已在种子轮融资中成功募集1625万美元,投资方包括Khosla Ventures与Cerberus Ventures。据悉,加州理工学院亦参与本轮融资,并携手Google为公司提供关键算力支持。
加州理工教授正开辟一条绕开传统Scaling Law的新路径
Babak Hassibi是PrismML联合创始人兼CEO,同时担任加州理工学院电气工程、计算与数学科学教授。其余联合创始人包括Sahin Lale、Omead Pooladzandi与Reza Sadri。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
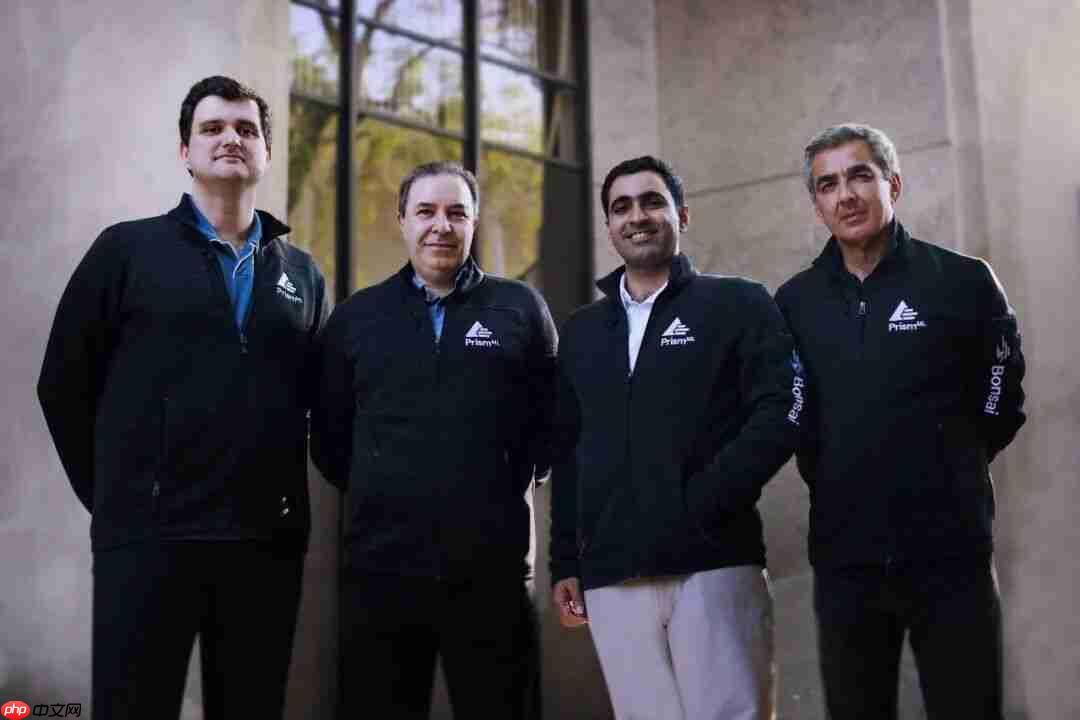
PrismML的创始团队,图片来源:PrismML
Babak Hassibi长期深耕信息论、信号处理、控制理论、优化算法及机器学习。早在上世纪90年代,他便参与提出经典神经网络剪枝方法Optimal Brain Surgeon,借助二阶导数信息识别并剔除冗余参数。他还曾联合创办自动驾驶感知公司Neural Propulsion Systems并出任CTO,拥有将算法设计、专用芯片与系统级硬件深度融合的实战经验。
Sahin Lale是PrismML联合创始人兼研究联席负责人,于加州理工学院获得电气工程博士学位,研究方向涵盖动态系统建模、强化学习与自适应控制;此前亦在Neural Propulsion Systems主导核心算法研发。
Omead Pooladzandi为PrismML联合创始人兼研究联席负责人,博士毕业于UCLA,专注于二阶优化理论、数据高效训练机制及模型泛化能力提升。
Reza Sadri担任PrismML联合创始人兼战略副总裁,长期深耕数据库系统、高性能存储架构与机器学习基础设施建设。他曾创办Levyx,在Instacart领导ML基础设施团队,并在加入PrismML前于加州理工学院主导AI Bootcamp项目,主要负责系统工程整合、产品化落地与商业化推进。
尽管持续增加训练算力、模型参数量与数据规模仍可带来性能增益,但这类模型的部署却高度依赖集中式大型数据中心。
这带来一个结构性矛盾:受限于延迟敏感性、终端硬件能力及数据隐私合规要求,当前最强的AI模型被牢牢锁死在云端集群与专用服务器中;而手机、笔记本、汽车、机器人、企业私有环境等边缘与端侧场景,始终难以实现低延迟、高安全、可持续运行的本地AI体验。
PrismML所致力解决的核心命题,正是打破这一桎梏:让高性能AI模型真正“下沉”至终端设备,实现高效、安全、实时的本地推理;同时反向赋能数据中心,以更少资源支撑更强算力输出,遏制能源消耗的指数级攀升。
他们旨在构建一种全新AI范式:模型具备跨平台硬件适应能力,并在单位算力、单位能耗、单位内存占用下,释放出更高水平的智能效能。
具体而言,PrismML通过近乎无损的模型压缩技术,显著削减模型对内存带宽、计算资源与电力供给的需求,逐步降低模型能力对参数膨胀与基础设施扩张的路径依赖。
不同于业界常见的4-bit或8-bit训练后量化方案,PrismML并非仅对部分权重进行低位宽压缩,也未采用“少量高精度层+大量低位宽层”的折中策略,而是将Embedding层、Attention模块、MLP子网络及输出头等全部组件,统一重构为二值化或三值化权重结构。
在二值模型中,每个权重仅表示+1或–1两种状态,每128个权重共享一个FP16缩放因子,实际平均比特宽度约为1.125 bit;三值模型则额外引入0状态,平均比特宽度约1.71 bit,在小幅增加体积的同时,保留更多原始模型表达能力。
注:模型权重可类比为神经网络内部的“调节旋钮”。传统模型需精确记录每个旋钮的具体数值,而二值化仅保留方向(正/负),三值化再补充“关闭”状态(零),从而以极简数据近似还原原有功能。
此外,PrismML还为这些压缩权重定制了专用推理内核,支持直接读取压缩格式执行运算,无需解压回FP16,从而同步降低模型体积、内存带宽压力与推理过程中的数据搬运开销。
PrismML提出了一项全新评估维度——“智能密度”,即单位部署体积所能承载的有效智能水平。其终极目标,是在严苛的内存、功耗与空间限制下,最大化模型的实际可用能力。

统一LLM网关 - 一个API对接70+AI模型,使用单一API密钥即可调用GPT、Claude、Gemini、Qwen、Deepseek、Grok等主流模型。
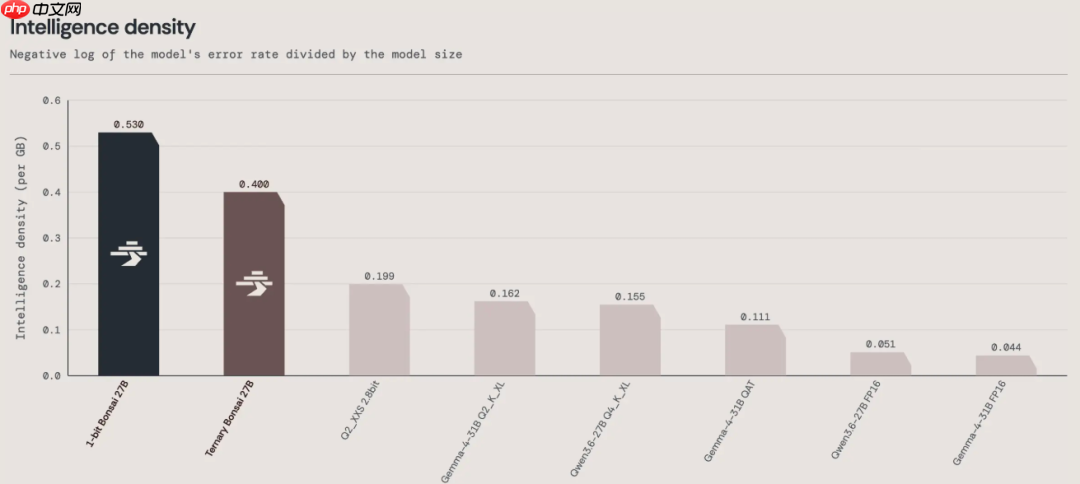
Bonsai 27B与同参数规模其他模型的智能密度(每GB)对比,图片来源:PrismML
2026年3月,PrismML正式发布全球首批具备商业落地能力的1-bit大语言模型——1-bit Bonsai 8B。该模型实现了端到端原生1-bit设计:从词嵌入层(embeddings)、注意力机制(Attention)、多层感知机(MLP layers)到语言建模头部(LM head),全部采用自研1-bit权重架构。
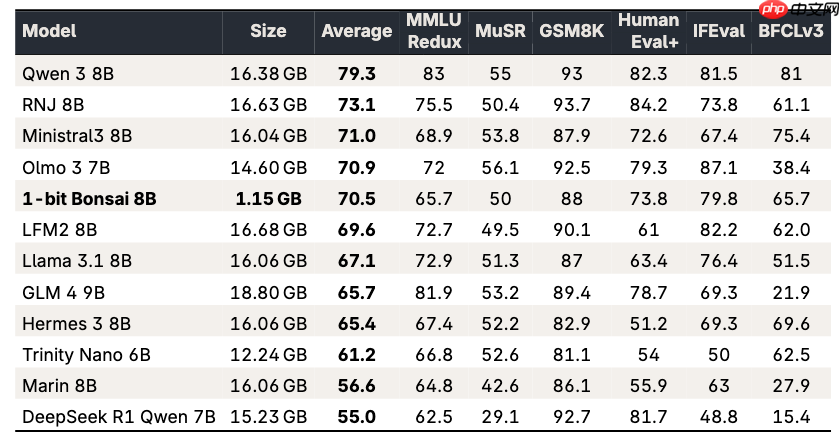
可在手机本地运行的1-bit Bonsai 8B,体积较同类参数模型缩小超10倍,性能几乎无损,图片来源:PrismML
相比Llama3 8B,该模型体积缩减14倍,推理速度提升8倍,能效提升4–5倍,整体大小仅为1.15 GB,轻松适配iPhone 17 Pro等旗舰移动设备。
它同样兼容桌面平台:据PrismML实测,1-bit Bonsai 8B在搭载M4 Pro芯片的Mac上推理速度达131 tokens/秒;使用RTX 4090显卡可达368 tokens/秒;在iPhone 17 Pro Max上亦稳定输出约44 tokens/秒。
其最新发布的模型为Bonsai 27B,基于Qwen3.6 27B深度优化,是当前同等能力水准下,首款可在智能手机上流畅运行的27B级模型。
在GeForce RTX 5090上,Bonsai 27B的1-bit版本最高推理速率达163 tokens/秒,三值版本为134 tokens/秒;在配备M5 Max芯片的Mac设备上,1-bit版峰值达87 tokens/秒,三值版为58 tokens/秒。
Bonsai 27B全面支持MLX框架,在苹果全系设备(Mac、iPhone、iPad)原生运行;同时也兼容CUDA生态,可在NVIDIA GPU平台高效部署。
Bonsai 27B的关键价值在于,27B级别的参数规模使其具备处理复杂任务的能力:如多步逻辑推理、结构化工具调用、轻量级视觉理解,以及长时间跨度中保持语义连贯的“计算机操作(computer-use)”智能体闭环。
Bonsai 8B与Bonsai 27B共同催生了一种新型混合部署架构:将常规性、非敏感型任务交由本地模型即时响应,仅将最具挑战性的推理环节卸载至云端前沿模型。此举可使智能体单次任务的综合成本断崖式下降。
在应用层面,当高级模型足够轻量、快速且节能,得以常驻终端时,AI产品的想象边界将被大幅拓宽:例如全天候在线的端侧智能体、毫秒级响应的具身机器人、兼顾隐私与效率的企业级Copilot、完全离线可用的AI助手,以及专为带宽受限、功耗敏感或强合规要求场景打造的AI原生解决方案。
AI模型的下一轮跃迁,或将从“拼规模”转向“提密度”
过去数年,AI模型沿着Scaling Law持续扩张:参数更多、数据更广、算力更强。这一路径带来了能力跃升,却也将模型日益绑定于数据中心、高带宽内存、海量电力供应等重型基础设施。
当AI加速渗透至企业IT系统、服务机器人、智能汽车及消费电子终端,这条扩张之路开始遭遇现实边界的强力反制。企业亟需保障专有数据不出域,物理AI终端则必须在真实环境中完成持续感知、实时决策与自主行动——所有这些,都要求智能能力真正扎根于本地,而模型体积与能耗正迅速成为新的天花板。
这意味着,AI模型演进的下一阶段,或将从追求绝对规模,转向锤炼“智能密度”:让每一bit数据、每一GB内存、每一瓦特能耗,承载更高密度的认知能力。模型的进步逻辑,也将从简单叠加参数,转向对智能本质的压缩、蒸馏与重构。
我们或许正站在一个历史性拐点之上。过去的问题是如何获取更多智能,未来的问题则是如何把智能注入更广泛的设备与场景之中。“浓缩智能”已不止于效率优化,它或将重塑模型的发展轨迹,并重新定义AI产品的形态边界。未来的AI,将自然分布在云端、边缘端,以及二者之间的任意节点。
下一轮模型竞争的核心指标,或将取决于:谁能以更低的资源代价,把更强的智能,带入更广阔的现实世界。
本文来自微信公众号 “阿尔法公社”(ID:alphastartups),作者:发现非凡创业者的,36氪经授权发布。













