


“采购一批设备回来,10个月回本即可,希望能以公允价格拿到芯片,这样就无需自行造芯了。”近日,在一场投资交流活动中,deepseek 创始人梁文峰坦言现实困境——当前芯片报价过高,已难以支撑deepseek对大模型低成本运营的战略诉求。
值得关注的是,就在本次投资会召开前,已有媒体披露:DeepSeek已悄然启动自研定制推理芯片项目,历时整整一年,并已与多家芯片设计公司、晶圆代工厂及存储方案供应商展开密集对接与技术协同。
由此不难判断,以极致性价比见长的DeepSeek,正面临前所未有的芯片成本压力。随着AI大模型加速商业化落地、Token调用量呈指数级攀升,曾长期处于配角地位的推理芯片,正逐步取代训练芯片,跃升为大模型厂商最核心的成本项。
对DeepSeek这类主打普惠定价的大模型企业而言,能否持续压降推理芯片单位成本,已成为决定其市场生存力与长期竞争力的关键变量。
【1】DeepSeek引领行业价格重构
2026年,是国内大模型产业集体“卷价格”的关键之年:
5月23日,DeepSeek正式将V4-Pro模型此前推出的“限时折扣”升级为“永久降价”,原享2.5折的专业版API调用价,如今固化为长期执行的2.5折策略;更进一步推出类比电力市场的“峰谷时段动态计价”,依据流量高峰与低谷实时浮动API资费;
5月28日,小米旗下MiMo-V2.5全系API接口全面下调服务费率,部分垂直场景降幅高达99%,同时取消上下文长度分级计费,统一采用基础低价模式,切实缓解开发者在长文本处理中的成本焦虑。
6月底,腾讯云平台同步上线DeepSeek-V4全系列模型并同步调低调用单价,最高降幅达97.5%;第三方入驻模型MiniMax-M3在推理输入、推理输出及缓存命中三项费用上,均实现50%的降幅。
这轮价格调整力度几何?以DeepSeek为例,调价后其专业版百万Tokens报价直降至0.025元,仅为Minimax M2.7报价的5.8%。
价格即壁垒,市场用实际调用量投票。对多数应用场景而言,使用成本远比纸面性能更具决策权重。OpenRouter数据显示:调价后,DeepSeek-V4-Flash模型一举登顶全球API调用榜榜首;而在此前,DeepSeek V3.2/R1等主力模型最高仅位列全球第三。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
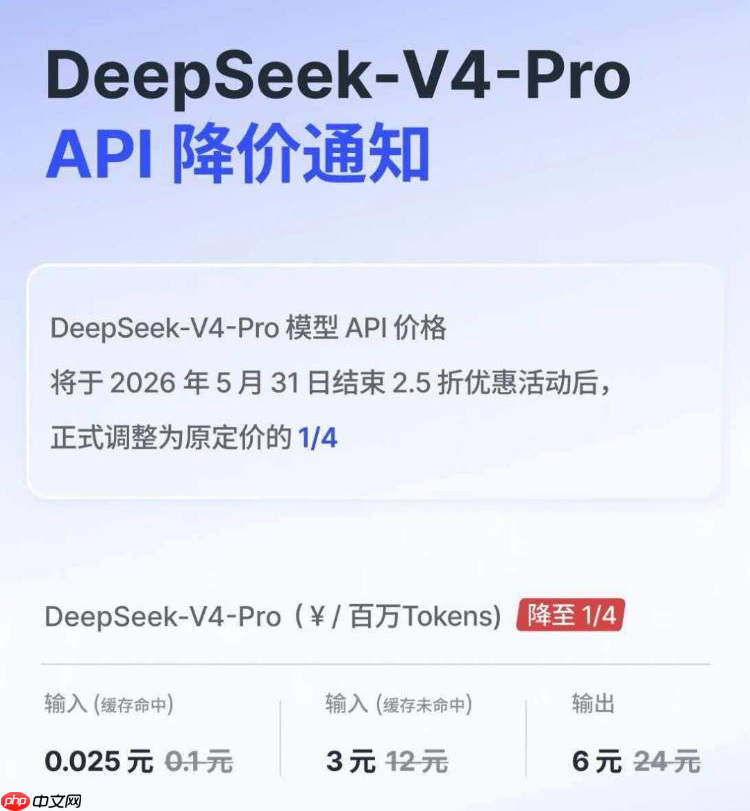
(来源: DeepSeek官网 )
为何一贯对融资持审慎态度的DeepSeek,反而能打出如此激进的价格牌?根源在于两点:
其一,依托深度算法优化与工程提效,显著压缩算力消耗,例如在处理百万级Token长上下文时,V4系列算力开销仅为上一代的27%,缓存机制优化降低10%负载,真实训练成本亦下降10%;
其二,主动摆脱英伟达生态依赖,规模化采购国产算力硬件,如华为昇腾全系节点已全面适配DeepSeek V4系列模型,有效摊薄芯片采购成本。
可见,在算法精进与国产硬件替代双轮驱动下,DeepSeek等本土厂商正加速推动AI从实验室走向规模化商用。
【2】推理芯片步入成本瓶颈期
DeepSeek等国内大模型厂商掀起的价格战,正在重塑全球AI产业格局——面对轻量级任务,用户优先选择高性价比模型;而面对复杂推理场景,则仍倾向OpenAI等高价高性能方案。
但随着模型能力持续进化、国产替代红利逐步收窄,DeepSeek、小米MiMo等厂商已明显触及价格下探极限——推理芯片成本持续攀升,正成为当前乃至未来AI大模型商业化的最大支出项。
这意味着,若无法突破推理成本瓶颈,AI普惠化将成为空中楼阁。推理芯片对模型定价的影响主要体现在两个维度:
一是采购规模与单颗成本的双重压力,过去大模型厂商重心在模型训练,但随着AI真正进入生产环境,行业重心已转向推理部署。推理芯片正迅速成为采购清单上的绝对主角。

统一LLM网关 - 一个API对接70+AI模型,使用单一API密钥即可调用GPT、Claude、Gemini、Qwen、Deepseek、Grok等主流模型。
阿里云“2026算力倍增计划”明确,AI资本开支中推理芯片预算占比已达60%;Meta预计2026年底将建成相当于60万张GPU算力的推理集群,占其全年AI总投入的55%……
“目前约70%—80%的AI算力用于训练,20%—30%用于推理,但这一比例将在未来彻底翻转——推理算力将占据整体AI算力的70%以上。”联想集团董事长兼CEO杨元庆在今年五月业绩发布会上指出,“推理芯片时代已然到来。”
二是全生命周期成本刚性上升,不同于一次性投入的训练芯片,推理芯片需持续响应终端请求,其成本呈现长期性、累积性特征,且随用户问答量激增而线性放大。业内数据显示:在真实生产环境中,推理芯片投入可占大模型全生命周期计算成本的80%至90%。
短期采购量激增叠加长期成本刚性,使得推理芯片成为AI商业化进程中分量最重的“成本锚点”。
因此,对DeepSeek这类坚持低成本路线的大模型厂商而言,是否具备压降推理芯片单价的能力,直接决定其未来发展上限。
【3】推理芯片自研道阻且长
事实上,降低推理芯片成本已成为头部企业的共识动作。
完成首轮融资510亿元后,DeepSeek即公开披露资金用途之一:启动AI推理芯片自主研发,以系统性降低成本。
今年6月,OpenAI联合博通发布首款自研推理芯片Jalapeño,旨在替换英伟达方案,目标实现推理成本削减约50%。
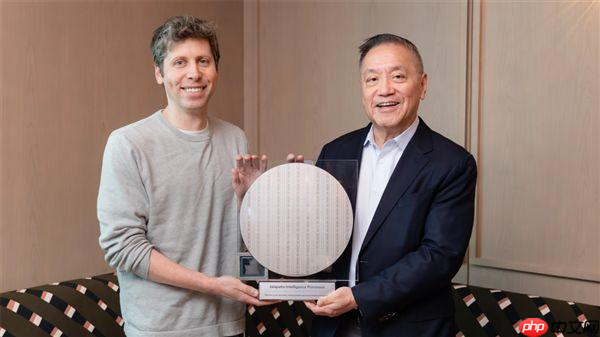
(来源:互联网)
Anthropic亦从OpenAI引进其芯片团队早期核心成员Clive Chan,全面主导AI推理芯片自研进程。
几乎所有科技巨头均已将自研推理芯片列为战略优先级,但这条路径绝非坦途,甚至可能拖慢大模型业务节奏。
首先是技术门槛陡增,大模型企业精于算法架构等软件层研发,AI芯片此前仅作为上游工具存在;如今却要跨界切入硬件设计领域,亟需在人才结构、工艺知识、IP积累等方面从零构建。
其次是迭代节奏失衡,相较华为昇腾、寒武纪、英伟达等专业芯片厂商,大模型企业在制程工艺、封装测试、量产经验等方面存在天然短板。芯片厂商面向全行业需求快速响应,而大模型厂商仅服务于自身模型,极易出现“流片即落后”的被动局面。
最后也是最严峻的挑战,在于生态缺失,以英伟达为例,其AI芯片价值不仅在于算力指标,更在于覆盖超400万开发者的CUDA生态——庞大的适配意愿与采购基数,形成良性循环,持续摊薄单颗芯片成本。
而智普AI、DeepSeek等厂商自研芯片,尚无外部生态支撑,仅限内部闭环使用,无法通过规模化出货分摊高昂研发费用,导致芯片单位成本居高不下。
综上所述,对智普AI、DeepSeek而言,自研推理芯片最难攻克的并非前端设计,而是生态构建与产能落地。唯有同步打通算法迭代适配、芯片流片验证、产线排期保障、用户生态共建四大环节,方有可能真正达成“每百万Token推理成本下降”的终极目标。
2026年的AI大模型产业,已悄然告别“能否做出好模型”的工程师时代,迈入“能否把成本压到足够低”的工业化时代。而一家大模型企业能否成功推出并规模化应用自研推理芯片,正成为界定其本质是AI产品公司,还是AI时代新型基础设施提供商的核心标尺。
本文来自微信公众号“司库财经”,作者:质子,36氪经授权发布。














