


合理配置连接重试不直接减轻后端压力,而是通过精准策略避免无效请求、跳过故障节点、防止重复建连,使流量稳定准确落到健康后端;需明确触发条件、限制次数与时长、配合健康检查与负载均衡,并关闭非幂等操作的重试。
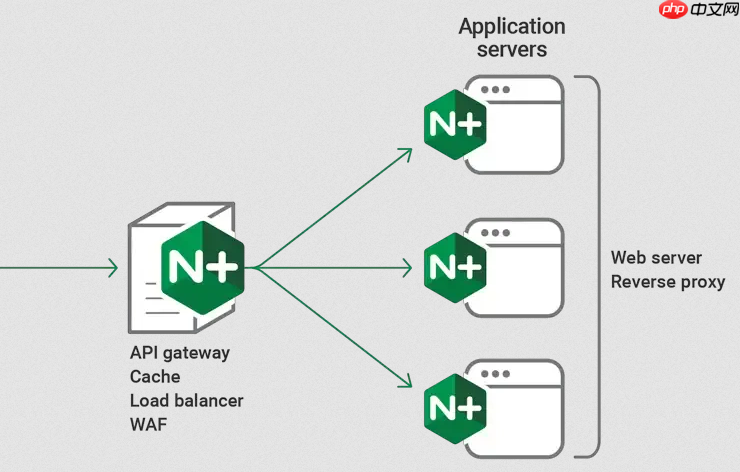
合理配置连接重试本身不直接“减轻”后端压力,反而可能在不当使用时加重负担。真正起作用的是:用精准的重试策略避免无效请求堆积、跳过已知故障节点、防止单次失败引发多次建连,从而让流量更稳、更准地落在健康后端上。
明确重试触发条件,只对可恢复错误重试
默认情况下 Nginx 不重试。必须显式配置 proxy_next_upstream,但不能无差别兜底:
-
推荐组合:
proxy_next_upstream error timeout http_500 http_502 http_503 http_504; -
error指连接被拒绝、重置等底层异常,这类问题常是瞬时的(如后端刚启动、临时满载) -
timeout包含 connect 和 read 超时,说明后端响应慢但未必宕机,换节点更合理 -
慎用
http_501、http_404、invalid_header等——这些是业务或协议错误,重试无意义,只会放大压力
限制重试总次数与耗时,避免雪球效应
不加约束的重试会让一个请求变成三四个并发打向不同后端,尤其在集群部分节点异常时极易引发级联过载:

-
proxy_next_upstream_tries 2;—— 最多再试 1 次(共最多 2 次转发),3 次以上显著增加链路不确定性 -
proxy_next_upstream_timeout 8s;—— 所有重试加起来不能超过 8 秒,超时即返回 502/504,不继续兜底 - 这两项要和
proxy_connect_timeout(建议 3–5s)、proxy_read_timeout(建议略高于后端 P95 延迟)配合,确保整体可控
配合健康感知,让重试“有的放矢”
如果后端节点已卡死却还在重试列表里,重试就等于主动投喂压力:
- 每个
server行必须带max_fails=2 fail_timeout=15s;,让 Nginx 主动标记并暂时屏蔽异常节点 - 启用
least_conn算法,重试时优先选当前活跃连接最少的节点,而非轮询式平均分配 - 若使用
backup节点,重试会自然落到备用池,既隔离主集群压力,又避免全量失败
关闭非必要重试场景,从源头减负
不是所有路径都适合重试。对写操作、流式响应、大文件上传等,重试可能造成重复提交或状态错乱:
- 在关键接口 location 中禁用重试:
proxy_next_upstream off; - 或按方法区分:
location /api/v1/order { if ($request_method = POST) { proxy_next_upstream off; } } - 对幂等性明确的 GET 请求,可保留重试;对非幂等操作,宁可快速失败也不盲目重发














