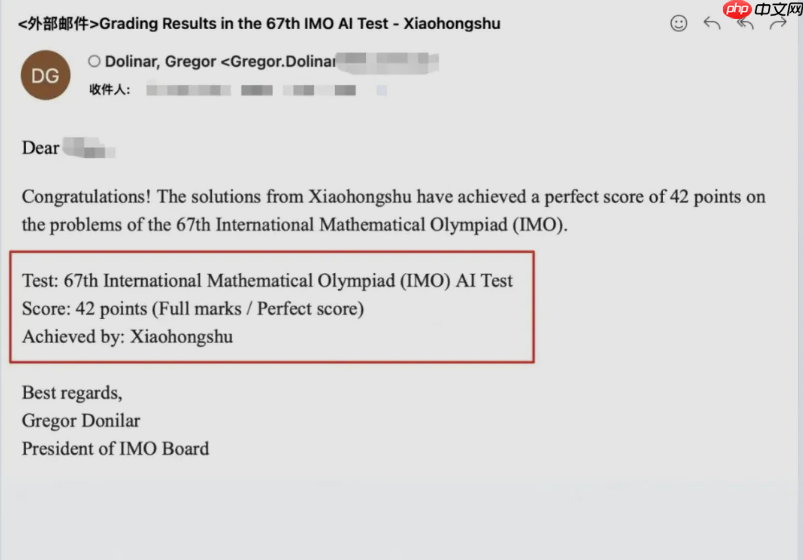
第67届国际数学奥林匹克竞赛(imo2026)成绩日前正式公布,小红书自研大模型 dots-note-3.0以六道题全对、总分42分的完美表现摘得金牌。这是中国自主研发的大模型首次获得imo官方认可的金牌级能力认证,同时也是继谷歌gemini之后,全球第二款达成imo金牌水准的大模型——且为史上首个实现满分突破的模型;而谷歌此前最高纪录为5/6题正确。
IMO即国际数学奥林匹克竞赛,是面向全球顶尖高中生的最高级别数学赛事,陶哲轩等约半数当代菲尔兹奖得主均曾在此崭露头角。赛事为期两天,每日限时4.5小时解答3道题目,涵盖代数、组合、几何与数论四大核心领域,每题满分7分,总计42分。参赛者须提交逻辑严密、步骤清晰、可被逐行验证的完整证明过程,这对大语言模型的深层推理与形式化表达能力构成严峻挑战。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
作为对比,谷歌Gemini在IMO上的演进路径颇具参考价值:2024年首次参测仅获28分(银牌),且需先将题目人工转译为Lean等形式化语言,部分题目耗时长达数日;至2025年,Gemini Deep Think版本已支持纯自然语言端到端推理,在4.5小时内成功攻克5题,最终斩获金牌。数学奥赛之所以被公认为衡量大模型智力水平的关键标尺,正因其天然具备“不可预测性”——所有题目均由命题专家独立设计并全程保密,模型无法通过数据预训练“押题”,必须依赖实时语义解析、策略探索与严谨演绎完成求解。
本届IMO金牌分数线定为29分,较去年35分下调6分,整体题目难度显著跃升。达到29分,意味着至少完整解出4题,并在其余两题中各取1分即可入围金牌阵营;而dots-note-3.0以全题满分姿态登顶,领先金牌线整整13分。
这一满分战绩首先印证了Agentic推理架构的鲁棒性。模型需精准解析自然语言题干,识别隐含约束与关键变量,自主构建中间引理,并将整个推导链组织为符合数学规范的连贯证明——任一条件误读或逻辑断层都将被评审直接否决。dots-note-3.0在代数、组合、几何、数论等六类迥异题型中全部满分解题,表明其表现绝非某一道题的侥幸突破,而是系统性能力的稳定输出。其次,该模型完全基于自然语言实现端到端推理闭环,从理解题意、生成思路、验证步骤到输出答案,全过程无需人工干预或外部工具链辅助,展现出高度可迁移的通用数学推理能力。

从零搭建飞书机器人。支持 MiniMax/MiMo 等模型、工具调用(搜索/天气/百科/记忆)、Skill 架构。一站式交付可上线运行的飞书群聊 bot。基础版本,后续可自行升级能力
在具体解题实践中,dots-note-3.0采用智能体(Agent)范式,深度融合自然语言推理与Python代码执行能力,并嵌入递归式自我批判机制,持续审视论证链条的完备性与一致性。尤为令人瞩目的是第三题——一道典型的组合博弈问题。主流解法通常将其建模为图论中的连通性判定问题再展开证明,而dots-note-3.0另辟蹊径,选用数学归纳法,精准捕捉问题最本质的递归结构,巧妙构造归纳对象与归纳命题,实现了更高维度的抽象提炼。
双届CMO金牌得主刘涵祚评价其解答“既正确又优美,结构凝练、逻辑流畅,在IMO历年标准答案中亦属简洁而富有美感的一类”;CMO金牌得主汪千桐则指出:“表述干净利落、直击要害,每一步推演都水到渠成,但这种切入视角对人类选手而言极难自发想到。”
对小红书而言,此次IMO满分不仅是技术实力的一次高光展示,更是一次关键的战略破圈。过去公众对其技术能力的认知多集中于内容社区运营、推荐算法优化与图文理解等应用层,基础大模型研发能力长期缺乏权威背书。而IMO满分不同——42分硬指标赫然在目,无需冗长说明,足以宣告小红书已在基础模型赛道拥有了真正值得产业界严肃关注的技术话语权。一位新锐玩家,已然站上舞台中央。据悉,dots-note-3.0模型即将面向全球开源。