


视觉大模型长期受限于一道隐性壁垒:若想实现顶尖性能,就必须提前储备海量数据与强大算力,这使得前沿视觉能力几乎沦为少数头部团队的“私有玩具”。7月21日,小鹏集团正式推出turingvit高效视觉编码器,宣称从底层架构、数据范式到训练机制进行系统性革新,为业界构建了一条可复现、低门槛的sota级视觉transformer训练路径,推动先进视觉大模型由“巨头专属”迈向“行业普惠”。
TuringViT的目标非常明确:面向VLM(视觉语言模型)与VLA(视觉语言动作模型)时代,全面赋能智能驾驶、智能座舱及IRON人形机器人三大核心业务场景。它在架构设计、数据构建、训练策略三个层面同步突破,构建起以线性注意力为核心、高质量数据治理为支撑、原生动态分辨率能力为底座的技术三位一体体系,在性能表现、计算效率与工程落地性三方面实现协同跃升。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
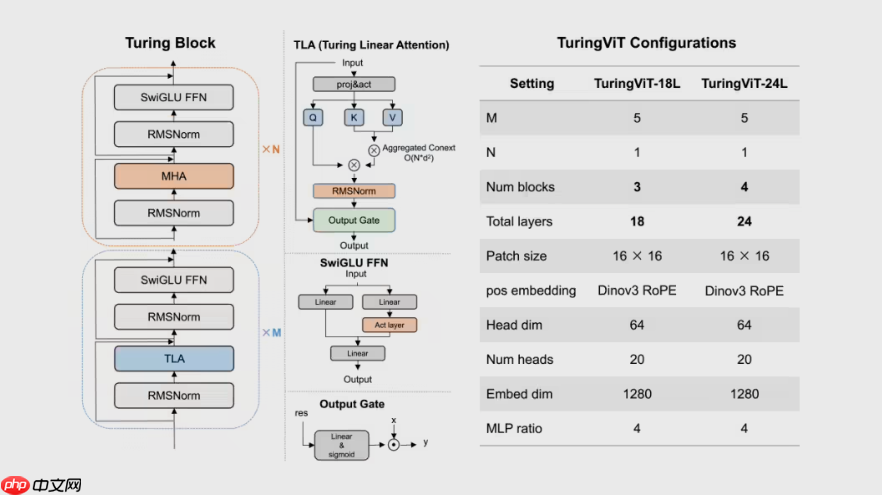
在架构层面,TuringViT提供两种规格型号。TuringViT-18L集成3组Turing Block,共含15层TLA(Token-wise Linear Attention)与3层MHA(Multi-Head Attention),专为动态分辨率下的轻量高效部署优化;TuringViT-24L则配备4组Turing Block,总计20层TLA加4层MHA,在维持线性复杂度主导的前提下显著增强表征能力。实测结果表明,随着输入图像分辨率提升,TuringViT的延迟增长曲线远比标准Softmax ViT平缓,高分辨率场景下的效率优势持续放大。在1536×1536分辨率下,TuringViT-18L推理吞吐量达Seed1.5-ViT的3.04倍,较SigLIP2-ViT-L提升2.16倍,为端侧高分辨率感知、多摄像头融合输入以及长时序视频处理扫清关键性能瓶颈。
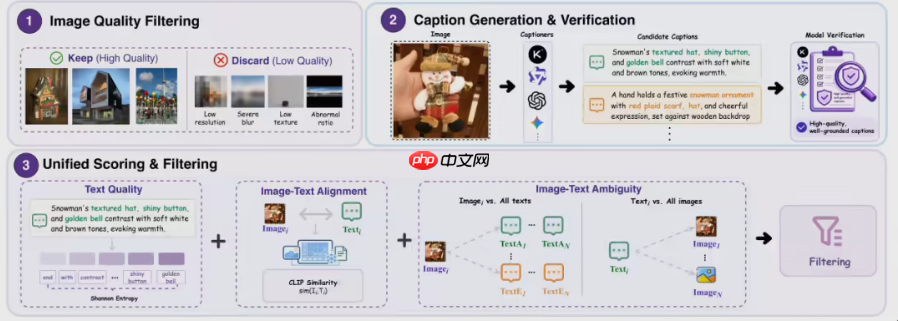
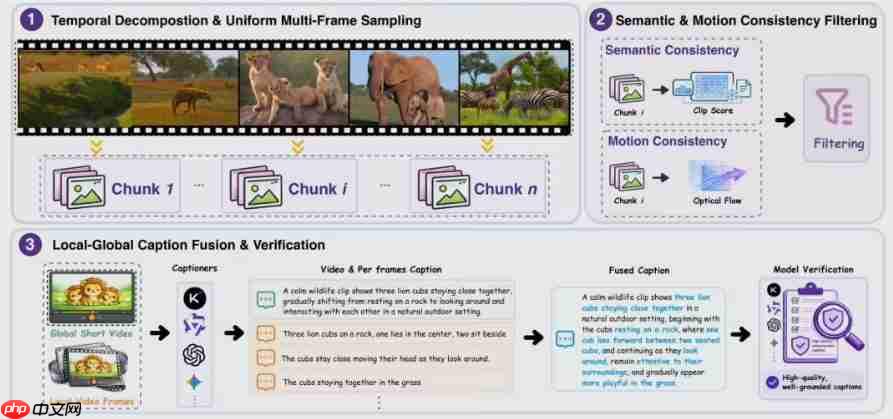
不同于业内普遍依赖数据规模堆叠的粗放路径,TuringViT真正的技术锋芒在于数据治理能力。其自主研发VISTA-Curation多模态数据治理流水线,并不盲目追求数据量扩张,而是通过大幅提升单样本监督质量,实现数据利用效率的阶跃式提升。针对图文数据,该流水线采用三阶段精细化筛选:首先剔除低分辨率、模糊或缺乏纹理细节的劣质图像;其次借助多模型联合、多提示词生成多样化候选描述,并交叉验证其与图像内容的一致性;最后统一置于对比评估池中,依据图文对齐度、文本信息熵及语义歧义程度进行综合打分,精准保留视觉贴合性强、语义密度高的优质标注,淘汰泛化、模糊或弱对齐样本。对于视频数据,则先将长视频切分为连续短片段并均匀采样代表性帧,再通过语义一致性与运动一致性双重过滤机制筛选有效片段,最终融合局部帧级细粒度字幕与全局时序语义字幕,生成具备动态变化感知能力的视频标注,助力模型从连续画面中习得更鲁棒、更具时空一致性的视觉表征。
数据效率的跃升直接转化为性能优势。TuringViT仅使用0.85B图文对——约为SigLIP2-L训练数据量的十分之一——便在ImageNet-1K等六项零样本分类基准上取得83.6%的平均准确率,超越多个依赖10B级数据训练的主流开源基线;在COCO与Flickr30K图文检索任务中亦表现优异,真正达成“十分之一数据、更优效果”的实质性突破。
在训练流程设计上,TuringViT采用四阶段渐进式原生动态分辨率训练范式,自预训练首日起即适配下游VLM与VLA的实际输入特性,彻底摒弃传统“固定分辨率预训练+后期微调适配”的割裂模式。
该编码器已在小鹏技术生态中完成深度集成与场景落地。在智能驾驶方向,它是第二代VLA模型的核心视觉编码器,负责解析多路环视摄像头采集的高分辨率、多帧动态道路场景,为预测式世界模型提供高质量视觉token;面向智能座舱与驾泊一体化需求,TuringViT原生支持VLM架构,使视觉特征与语言模型实现更高精度对齐,兼容不同画幅与宽高比的视觉输入,为多样化人机交互功能提供坚实基础;在小鹏IRON人形机器人体系中,它则作为视觉“视网膜”中枢,支撑物体细粒度识别、空间关系建模、可操作区域检测及动态环境持续追踪等关键感知能力。项目主页已同步上线:https://www.php.cn/link/0d83bd4e3361cf5a060dfd4258171105















