


搜索引擎蜘蛛不被Referer限制拦截,因其请求通常不带Referer头,而Nginx的valid_referers none明确允许无Referer请求,故百度、谷歌等可正常抓取。
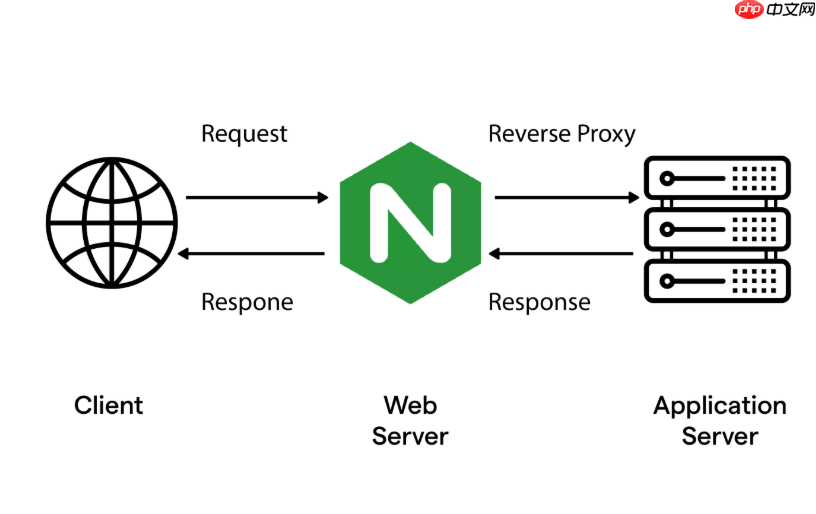
Referer 限制本身不拦截搜索引擎蜘蛛——因为蜘蛛发起的 HTTP 请求通常不带 Referer 头,而 Nginx 的 valid_referers none 明确允许无 Referer 的请求,所以百度、谷歌等主流爬虫默认就能正常抓取 HTML 页面和静态资源,无需额外放行。
为什么蜘蛛一般不会被拦?
搜索引擎爬虫(如 Baiduspider、Googlebot)在抓取网页时,绝大多数请求都不发送 Referer 字段。Nginx 的 valid_referers none 就是专为这类场景设计的:它匹配所有没有 Referer 头的请求,包括直接访问、隐私模式、以及绝大多数爬虫请求。
- 只要你的防盗链规则里包含
none(例如:valid_referers none *.example.com example.com;),蜘蛛就天然在白名单内 - 注意:
blocked是备用项,用于匹配 Referer 值非法(如被代理/插件清空为非标准字符串)的情况,也常覆盖部分爬虫行为,建议一并保留 - 蜘蛛不会用“从其他网站链接过来”这种方式触发 Referer,所以根本不会落到域名比对环节
哪些情况可能误伤蜘蛛?
极少数异常配置会导致蜘蛛被拦截,常见于:

-
漏写
none:比如只写了valid_referers example.com *.example.com;,没加none,则无 Referer 的蜘蛛请求会被判为$invalid_referer = 1,触发 403 -
规则限定过窄:把防盗链逻辑错误地套在 HTML 或 API 接口上(如
location /),而不仅是图片、CSS 等静态资源路径 -
强制 HTTPS 后 Referer 协议不一致:站点开了强制 HTTPS,但用户或第三方页面用 HTTP 引用资源,其 Referer 是
http://xxx,若白名单只列了https://example.com,会误拦——但蜘蛛本身不带 Referer,不受此影响
不需要、也不建议“专门放行蜘蛛”
试图通过 User-Agent(如 if ($http_user_agent ~* Baiduspider) { set $allow_spider "1"; })来绕过 Referer 检查,既没必要,又容易出错:
- User-Agent 可伪造,安全性无提升
- 增加配置复杂度,且可能与
if + return逻辑冲突(Nginx 中if在 location 内行为受限) - 主流蜘蛛不依赖 Referer,也不需要你“认出它”——它们靠的是无 Referer 这个事实被自然放行
验证蜘蛛是否能正常访问
用 curl 模拟无 Referer 的请求即可测试:
-
curl -I https://yourdomain.com/logo.png(不带 -H,即无 Referer)→ 应返回 200 -
curl -I -H "Referer: https://baidu.com" https://yourdomain.com/logo.png→ 应返回 403(确认防盗链生效) - 查看 Nginx 日志,搜索
"-" "-"或空 Referer 字段,确认蜘蛛请求日志中 status 是 200















