


“这里面到底装了多少张gpu?”“为什么要做这么大的机柜?”在今年世界人工智能大会(waic 2026)主展区——上海世博展览馆内,几排高达两到三米、通体漆黑的机柜前始终围满了观众。
有人凑近细看液冷管道的走向,有人举起手机拍摄机柜顶部盘绕如蛛网般的高速线缆,还有人紧追展台工作人员追问:这一整柜的算力,究竟能干些什么?
华为Atlas 950 SuperPoD、中兴OEX、阿里云真武M890×磐久AL128……基础设施类产品极少能在展会上成为焦点,但超节点却成了例外。
四天展期里,《IT时报》记者走遍全场,深入采访多家已布局超节点的芯片与设备厂商,试图厘清一个核心问题:这个一年前还仅在少数企业内部流传的新概念,为何突然跃升为全行业的共同战略选择?
目标一致,路径各异
若说去年WAIC上,超节点尚属个别企业的前沿探索;那么今年,它已演变为国产算力阵营的集体行动纲领。
从华为、壁仞、燧原、中兴通讯、沐曦股份,到中科曙光、阿里云、百度智能云,几乎所有主流国产算力厂商都将超节点置于展台最核心位置。这也印证了WAIC释放出的关键信号:全球AI竞争主战场正加速向底层基础设施迁移,而超节点,正是支撑未来AI发展的关键底座。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
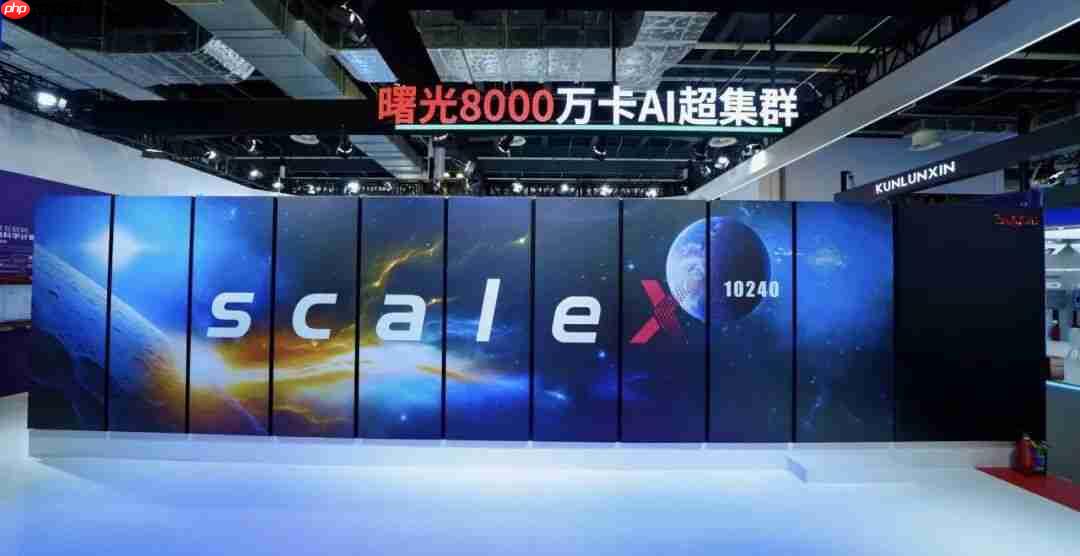
方向虽同,技术路径却各不相同。
华为坚持一体化集成路线。本次首次公开亮相的昇腾950超节点(Atlas 950 SuperPoD),由1024张计算卡构成,配备256TB统一内存,NPU端到端时延压缩至3微秒以内;借助统一内存编址技术,千余张计算卡可协同运作,宛如一台巨型单机。
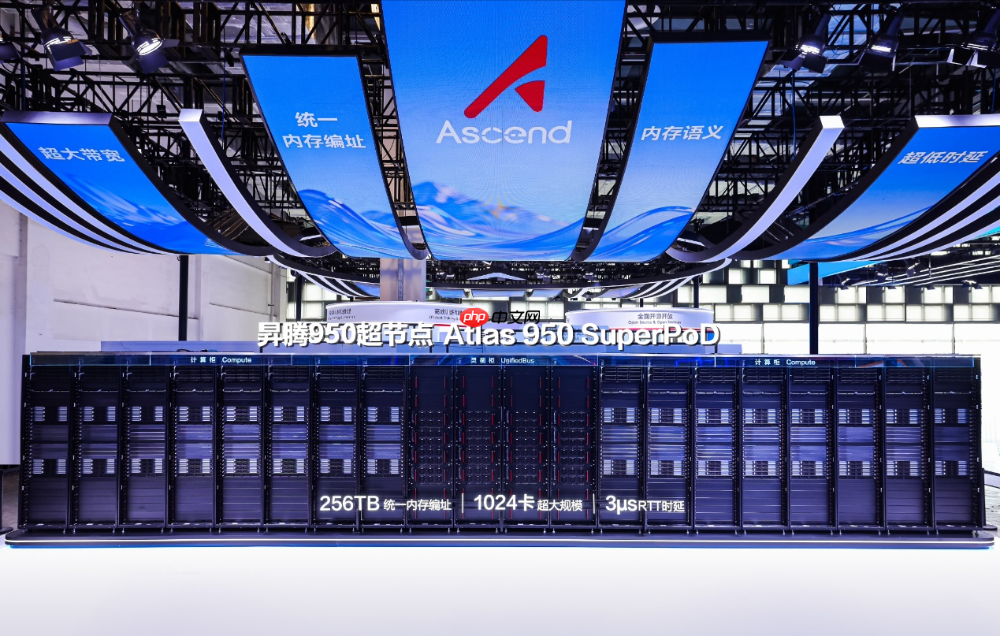
《IT时报》记者在展场看到,整套系统几乎占据整面墙体,远观如一道沉稳厚重的“黑色算力墙”。而1024卡,只是起点。据现场工程师介绍,昇腾950超节点最高支持8192颗芯片互联,未来甚至有望扩展至超50万卡规模的超大规模集群。
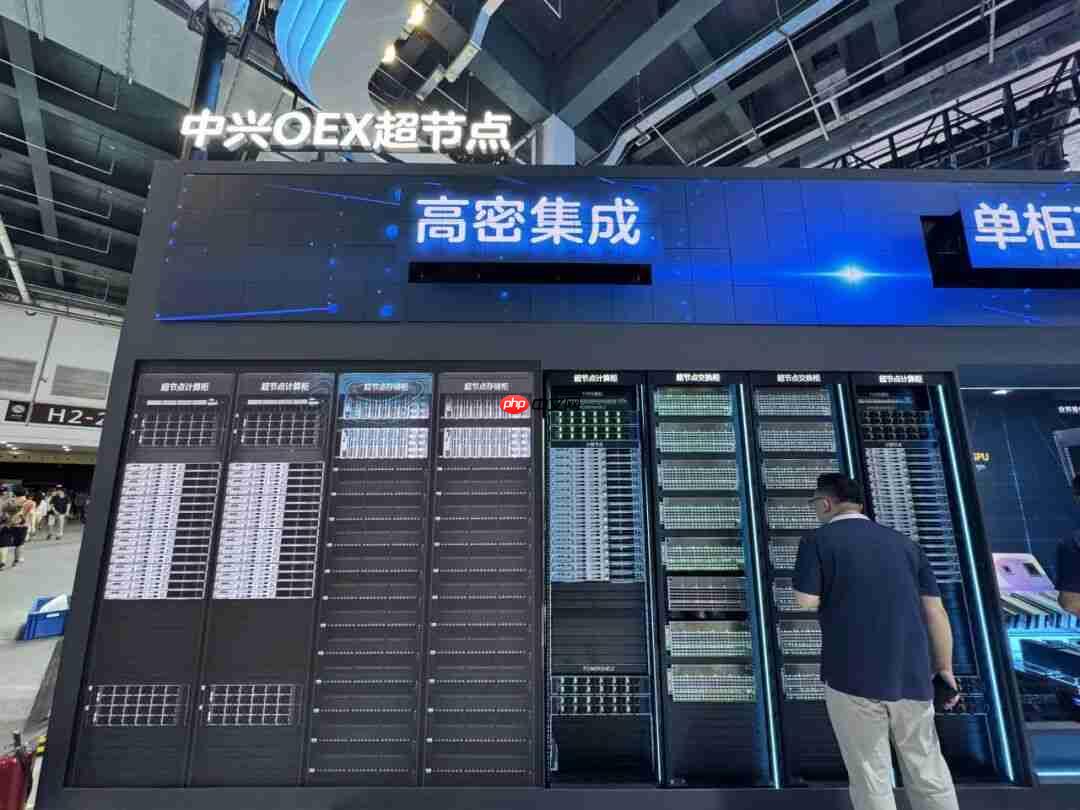
相较华为的封闭集成,中兴则选择了更开放的架构策略。其OEX平台兼容CPU、GPU、交换芯片、智能网卡等多种异构硬件,联合壁仞科技、沐曦股份、燧原科技、天数智芯等国产芯片力量,共建可插拔、可组合、可演进的国产超节点生态底座,让用户能依据业务特性灵活配置芯片组合,在性能与成本之间实现最优平衡。
壁仞科技则聚焦于互联能力突破。依托自研BLink2.0互连协议,1024张GPU可共享同一内存空间,形成一个逻辑上统一调度的“超级GPU”,从而支撑更大规模模型的训练与推理任务。同时,该公司首次提出“NPO光互连+分布式解耦架构”,旨在突破传统铜缆在带宽密度、传输时延与物理距离上的多重瓶颈。
当AI重心从训练逐步转向推理,TPU正悄然成为超节点赛道中的另一支主力。
作为国内TPU代表厂商,中昊芯英此次正式发布新一代“须臾”AI芯片:混合精度浮点算力达896TFLOPS,8-bit推理峰值达1792TOPS;相比同档竞品,“须臾”单芯片功耗降低约50%。
凭借TPU原生面向AI负载优化的架构设计,单个超节点最高支持2048颗芯片直连,可高效承载万亿参数大模型训练、多智能体协同决策及海量并发推理任务。
中昊芯英创始人杨龚轶凡向《IT时报》记者表示:“GPU脱胎于图形渲染场景,其底层架构并非为大规模神经网络并行计算而生,在芯片级互联方面天然存在局限;而TPU从诞生之初就围绕大模型训练与高密度神经计算构建,因此更契合超节点所需的高带宽、低时延、强扩展性,也更容易迈向万卡级集群。”
除芯片厂商外,云服务商亦将超节点视为AI时代新型基础设施的核心单元。阿里云展出由真武M890芯片与磐久AL128超节点组成的端到端算力系统:真武M890基于平头哥自研并行计算架构,集成144GB高带宽显存,片间互联带宽高达800GB/s,全面适配大模型训练、推理及智能体应用等多元场景。
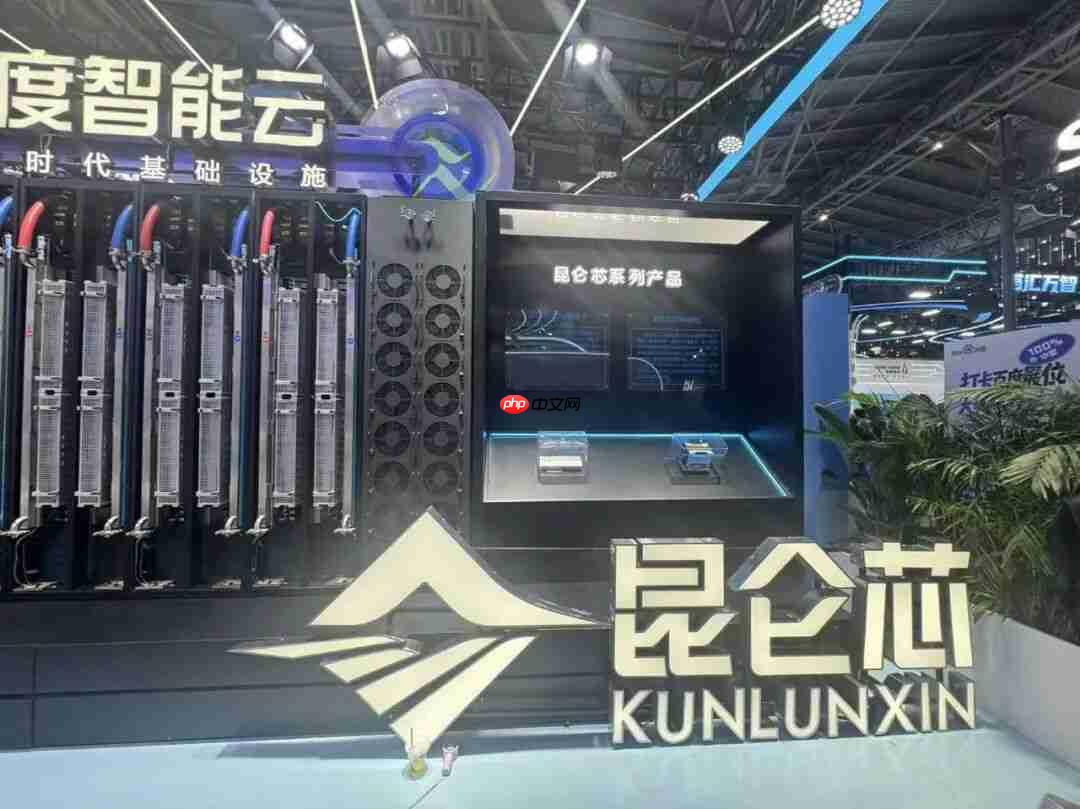
百度则展示基于昆仑芯P800打造的天池算力矩阵,支持256卡超节点,并具备向数十万卡集群持续扩展的能力,全面兼容文心、DeepSeek、智谱、MiniMax等主流开源与闭源大模型。
尽管方案百花齐放,但WAIC 2026传递的信息已然明确:国产算力竞争的主战场,已从单芯片性能比拼,全面转向整套计算系统的综合能力较量。
模型演进,“倒逼”超节点落地
为何今年所有玩家都押注超节点?答案不在展馆,而在模型本身。
“超节点并非凭空出现的概念,而是大模型发展到当前阶段的必然产物。”壁仞科技AI框架副总裁、AI软件首席架构师丁云帆在接受《IT时报》等媒体采访时指出。
在全球大模型以季度为单位快速迭代的节奏下,国产算力的竞争范式正在重构。受限于先进制程工艺,当前国产GPU在单芯片算力层面仍与国际领先水平存在3至5年的代际差距,短期内依靠单点突破实现反超并不现实。
与此同时,Agentic AI浪潮席卷而来,大模型呈现三大结构性变化,每一项都在强力驱动超节点走向规模化部署。
第一是MoE(专家混合)架构普及叠加Agent技术爆发。过去的大模型更像一个整体黑箱,每次推理均需调用全部参数;如今越来越多模型采用MoE结构,按需激活不同“专家”子网络。虽然计算效率提升,但GPU间的通信频次与数据量呈指数级增长。“专家并行对互联带宽要求极高,一旦通信链路跟不上,再强的芯片也会被‘锁死’。”丁云帆强调。

统一LLM网关 - 一个API对接70+AI模型,使用单一API密钥即可调用GPT、Claude、Gemini、Qwen、Deepseek、Grok等主流模型。
第二是模型参数持续膨胀。千亿级曾是大模型门槛,如今万亿级已成为新基准。7月16日发布的Kimi K3,参数规模达2.8万亿,刷新全球开源模型纪录。业内普遍预测,未来几年5万亿参数模型或将陆续登场,对单一集群的算力吞吐能力提出更高要求。
第三是上下文长度不断拉长。代码Agent、科研Agent等新型智能体应用兴起,单次任务需处理的Token数量成倍增加——输入的文档、输出的代码层层叠加,对显存容量与实时算力的需求较以往高出一个数量级。
一边是单芯片性能提升遭遇物理天花板,一边是用户对模型能力的期待持续攀升,超节点由此从“可选项”变为“必选项”。
光互连,2028年或成标配
然而,当算力衡量标准从单芯片峰值转向系统级有效算力时,真正的挑战,深藏于机柜内部。
1024张GPU组成超节点后,决定其真实效能上限的,不再是某颗芯片跑得多快,而是互联带宽、网络拓扑、软件调度与系统协同能力。换言之,能否把一堆芯片真正捏合成一个高效运转的整体,比每颗芯片快多少更为关键。
但这同时也意味着系统构建难度呈指数级上升——尤其当GPU数量从百级跃升至千级、万级时,通信瓶颈成为最大拦路虎。
过去几十年,GPU间主要依赖铜缆传输电信号。但随着800G、1.6T高速互联时代到来,电信号传输距离急剧缩短、功耗持续攀升,铜互连正逼近物理极限。“铜缆已难以支撑下一代超节点需求。”一位现场技术人员坦言。
破局之道,在于“以光代电”。当前光互连主要有四大技术路径:传统可插拔(FRO)、线性直驱(LPO)、近封装光学(NPO)和共封装光学(CPO)。
丁云帆透露,今年以来产业界关注焦点已明显从相对成熟的FRO与LPO,转向更具前瞻性的NPO与CPO,其中NPO正成为产业链协同攻关的核心方向。
相较于传统光模块,NPO将光引擎部署在GPU或交换芯片附近,大幅压缩电信号传输路径,省去高功耗DSP芯片,在带宽、时延、功耗与成本之间取得更优平衡,且传输距离可拓展至数百米,更契合未来超大规模超节点部署需求。
据集邦咨询预测,CPO/NPO市场规模将从2025年的约1亿美元,飙升至2030年的390亿美元以上——五年内增长近400倍,阿里巴巴、腾讯等头部企业已将NPO列为近中期重点部署方向。
因此,本届WAIC上,《IT时报》记者明显感受到:无论是光模块厂商、交换机厂商,还是其他上下游伙伴,纷纷亮出NPO相关产品、解决方案,或至少明确公布技术演进路线。尽管多数仍处于研发或样机阶段,但整个产业已进入协同推进的关键期。
丁云帆认为,从技术角度看,国内已具备NPO产品研发的基础能力,不存在不可逾越的技术壁垒。真正需要的是时间沉淀与工程验证,预计未来一到两年内,相关产品将陆续推出并进入实际场景测试。
但在CPO领域,国内布局者仍属少数。
一方面,CPO需将光引擎直接集成至计算芯片内部,对芯片设计、先进封装、制程工艺等提出极高要求,技术复杂度远超NPO;目前部分先进工艺环节,国内与国际领先水平仍有差距。
另一方面,涉及产业分工重构。若效仿英伟达模式,将计算与光互连完全集成于一颗芯片,原本属于光模块厂商的价值空间将被芯片厂商吸收,引发产业链利益再分配。
“中国现阶段更适合走生态共建之路。”丁云帆指出,在NPO架构下,GPU厂商、交换机厂商、光模块厂商等均可发挥各自优势,在产业链中找准定位,共享产业发展红利,从而构建更健康、更具韧性的国产AI算力生态。
当前行业整体仍处于技术攻坚与样机验证阶段。壁仞科技计划于明年推出基于NPO的超节点产品,并逐步投入真实生产环境运行。随着产业链日趋成熟,预计至2028年前后,NPO光互连有望成为AI超节点的主流连接方案。
规模化落地,中国步伐更快
如果说通信与光互连是超节点的“筋骨”,那么决定其能走多远的,是另一个高频词——工程化。本届WAIC上,无论智能体工厂、大模型厂商,还是AI for Science科研平台,被问及最大挑战时,“系统工程”几乎成为统一答案。
杨龚轶凡举例说明:当海量芯片组成统一集群,并需同时承载多家客户业务时,如何降低分布式计算过程中的通信开销,是超节点必须攻克的核心难题;此外,多租户场景下的数据隔离与隐私保障、万卡集群带来的散热压力,以及分布式调度、集群运维、故障自愈等软件能力,同样亟待同步突破。
“超节点之争,本质是一场全产业链协同之战。”杨龚轶凡表示。决定超节点上限的,不只是芯片本身的性能,更取决于网络互联、散热系统、软件调度等系统级能力,以及上下游厂商的协同深度。封装、交换机、光模块、液冷、服务器、调度中间件……这些过去分散在不同环节的技术,如今因超节点被前所未有地紧密耦合在一起。
耐人寻味的是,在丁云帆看来,超节点规模化扩展的速度,国内甚至快于海外。正因单卡算力存在客观差距,国内产业界才更迫切地寻求系统级创新来弥补短板。这并非一次孤立的技术跃迁,而是一场覆盖全链条的体系化突围。
这也是杨龚轶凡坚定选择TPU路线的重要原因:作为专用AI架构,TPU所需适配的算子数量远少于通用GPU,使本土厂商有机会在特定垂直领域快速追赶,走出一条“换道超车”的可行路径。
四天展会落幕,这些沉默矗立的黑色“算力墙”,已被无数观众存入手机相册。或许多年之后回望,这些影像将成为中国AI发展历程中,一段珍贵而坚实的起点。
图片/ IT时报
本文来自微信公众号 “IT时报”(ID:vittimes),作者:贾天荣,36氪经授权发布。














