


如果一份 excel 数据分散在多列甚至多块区域里,想快速提取出所有不重复项目,最省事的思路通常不是手工复制粘贴,而是先把数据压平成一列,再用 unique 去重。对新版 excel 来说,tocol 和 unique 正好就是这类整理任务的高频组合。下面就按“准备原始数据→先理解 unique 去重→处理按列或按行唯一值→区分全部唯一与只出现一次→组合 tocol 提取结果”的顺序,把这套方法完整走一遍。
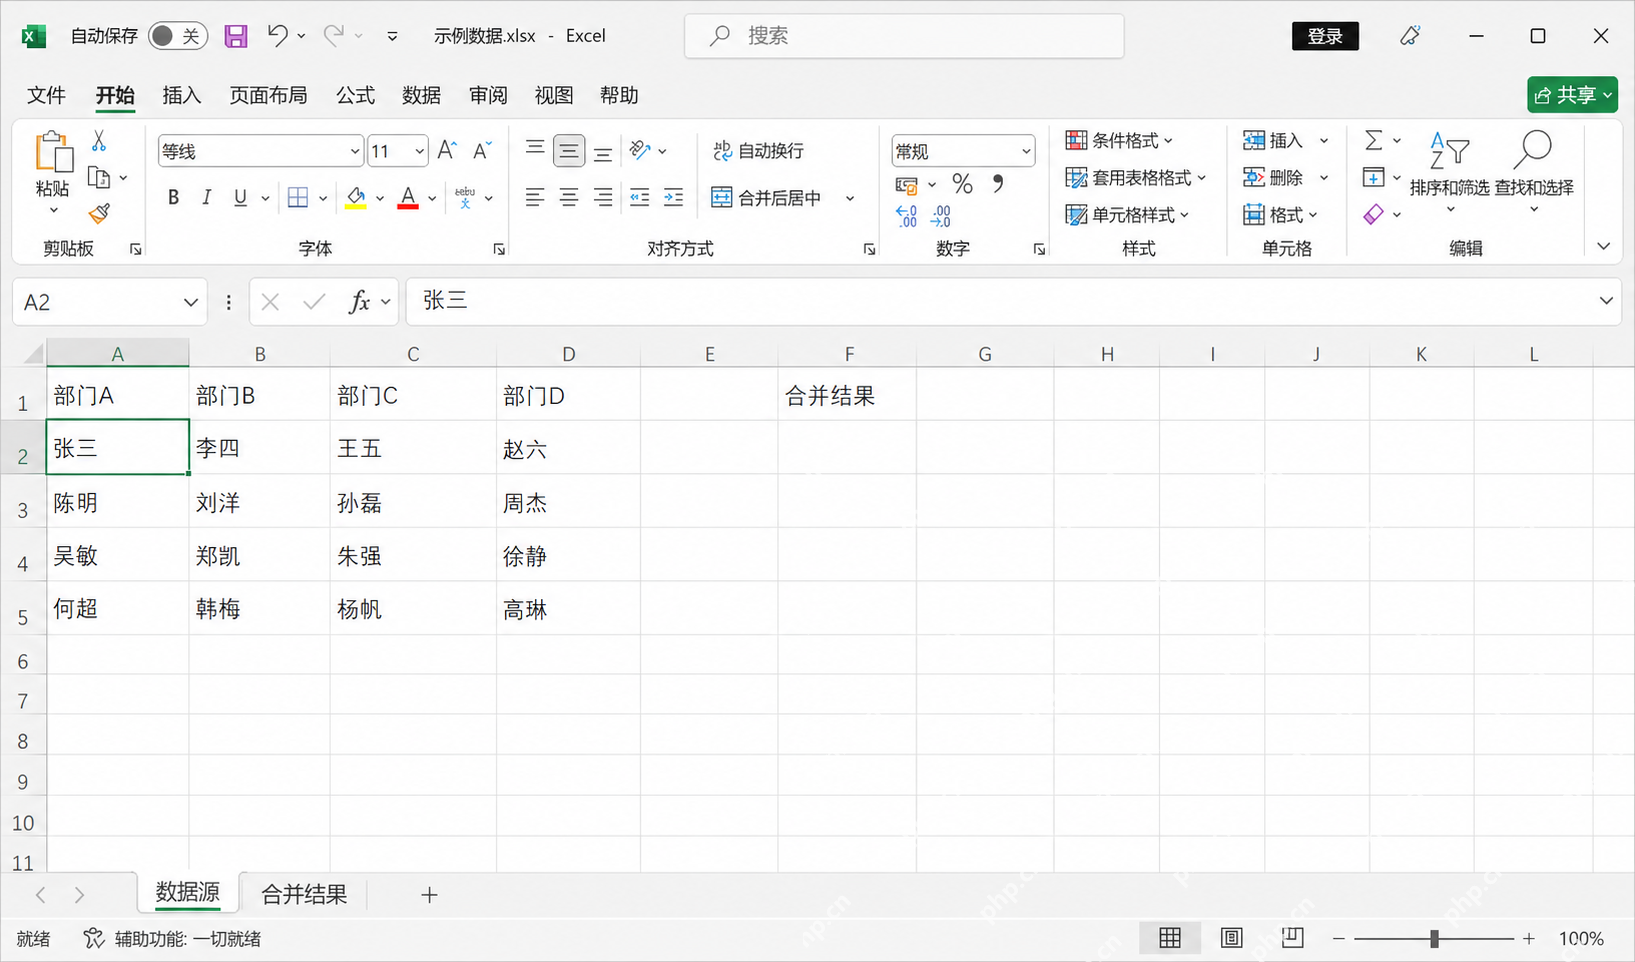
第一步先确认原始数据长什么样。很多人会遇到这种情况:姓名、部门、项目或编号不是只放在一列里,而是横向分散在多列区域中。这时候如果直接对某一列做去重,结果往往不完整。所以在正式写公式之前,先确认数据分布范围,再预留一个结果区,后面公式溢出时就不会和原表内容打架。
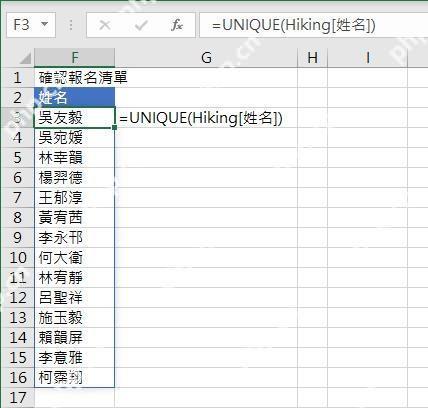
如果你的数据本来就在单列里,那么最基础的写法就是直接用 =UNIQUE(范围)。例如对姓名列去重,只要把函数写在结果区首个单元格里,Excel 就会自动把不重复名单一次性溢出出来。这个步骤的重点不是函数长短,而是理解 UNIQUE 的默认行为:它会保留每个项目的一份结果,并自动展开到下面的单元格。
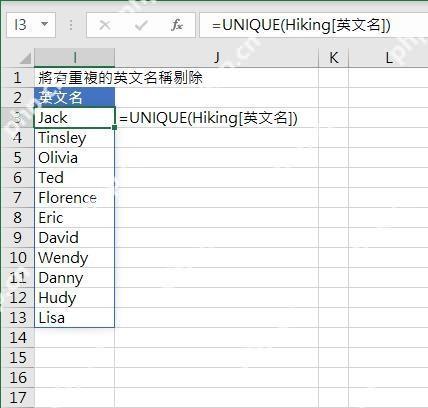
当你换成英文名、项目编号、分类名这类别的字段时,用法其实一样,本质上只是把 UNIQUE 套到另一列数据上。也就是说,UNIQUE 并不只适合名单整理,它更像一个通用的“去重提取器”。只要某一列里有重复项,都可以先用这个函数快速拿到不重复列表,再继续做下拉筛选、数据验证或汇总统计。
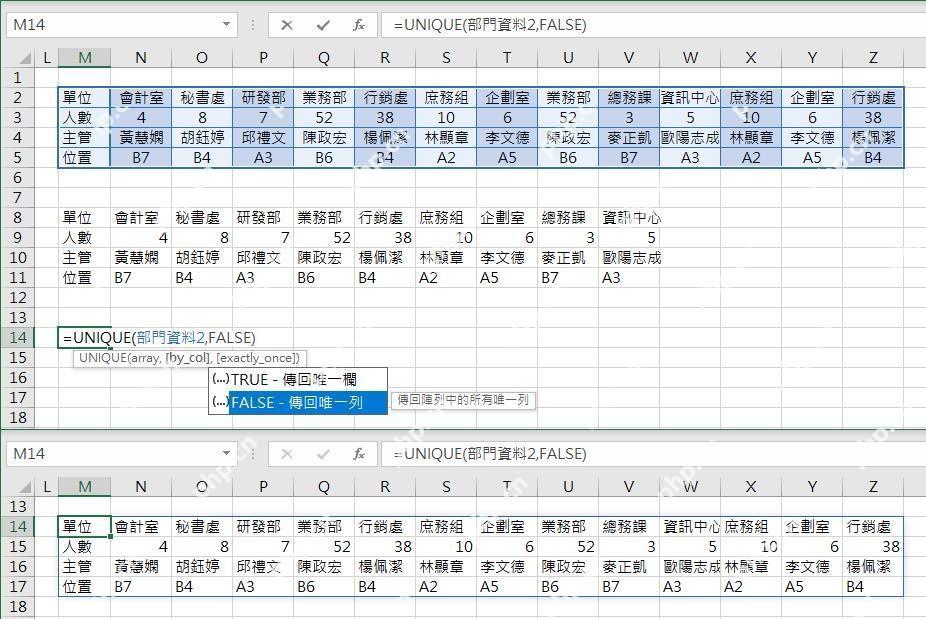
UNIQUE 还有一个容易被忽略的参数,就是控制按列还是按行判断唯一值。默认情况下,它更常用于单列去重;但如果你处理的是横向排列的数据块,就要留意第二个参数的方向含义。像示例里这种部门资料横向展开的区域,就更适合配合参数明确告诉 Excel 应该以列还是以行为单位判断唯一结果,否则输出方向可能和你预期不同。

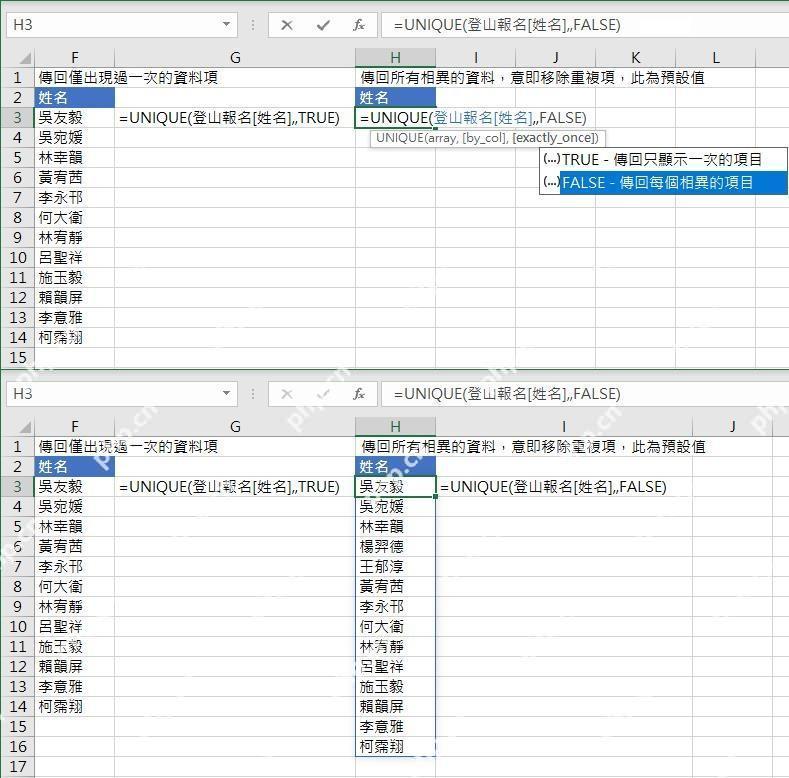
第三个实用点是 exactly_once 参数。很多人说“提取不重复数据”,实际上有两种意思:一种是“去掉重复后保留一份”,另一种是“只保留那些只出现过一次的项目”。这张图展示的就是两者差别。当前者用 FALSE 时,会保留每个重复项的一份代表;而改成 TRUE 以后,只会返回真正只出现过一次的数据项。做报名名单清洗、异常值筛查时,这个区别特别有用。
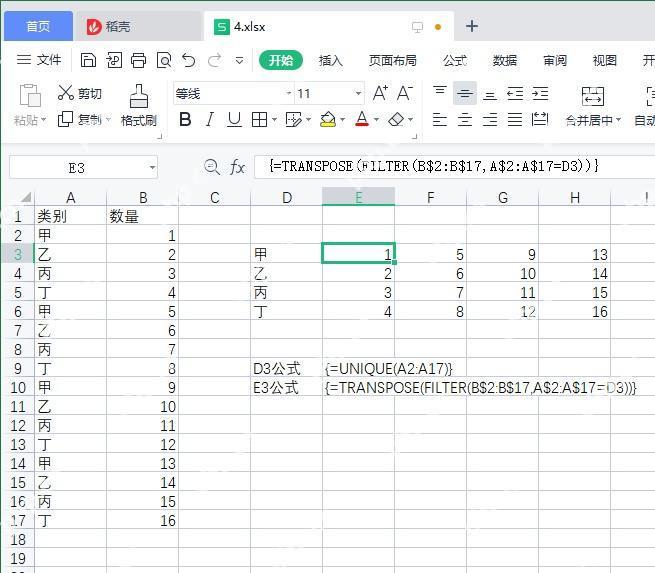
真正和标题对应的核心组合,是先用 TOCOL 把多列或多区域数据压平成一列,再把压平后的结果交给 UNIQUE 去重。你可以把思路理解成:TOCOL 负责“摊平”,UNIQUE 负责“去重”。如果后面还想横向展示,或者只保留某类结果,再继续接 TRANSPOSE、FILTER 这类动态数组函数就行。这样一来,原本分散在多列里的重复项目,就能被快速整理成一份干净清晰的名单。
总的来说,Excel 里要快速提取不重复数据,UNIQUE 负责判断唯一值,TOCOL 负责把分散数据先压平成可处理的一列,两者配合起来特别适合整理跨列名单、项目标签、部门编号或多区域文本。只要先确认原始数据范围,再决定是“保留一份”还是“只保留出现一次”,这类去重任务基本都能在几步之内完成。














