


在2026 waic现场,我们注意到:大模型的能力,正悄然走出互联网与聊天界面的边界。
两年前,业界对大模型的所有构想几乎全部锚定于云端——参数规模越大越好,算力集群越强越优,谁在数据中心堆叠的GPU数量更多,谁就更接近胜利。事实上,这套逻辑至今依然成立,但它仅揭示了故事的一半真相。
另一半,则静默地发生在云端之外。
随着Agent时代的到来,人们逐渐意识到:推理任务正逐步脱离数据中心,沉淀至PC端、手机端、机器人“大脑”中,乃至更多尚无统一命名的终端设备里。这些终端形态千差万别,却共同面对一个严峻挑战——即“不可能三角”:功耗被严格限制在几瓦以内,成本需控制在数十美元区间,而客户却要求它们稳定运行数十亿甚至上百亿参数的大模型。
芯片产业过去十年未曾直面此类命题。因为云端的法则向来是不断抬高上限,算力强者通吃;而端侧与边缘侧的任务,是在物理规律构筑的刚性牢笼中,将大模型推理效率压榨至极限。
这道题,正在重塑端边AI芯片的竞争范式。
01. 大模型,加速奔赴端边
为何端边大模型突然成为不可逆的趋势?
近期,黄仁勋多次强调一个预判:推理算力需求或将激增约一万倍,“Token”正演变为新的计量单位。
数字本身并非核心,真正关键的是其背后所代表的数量级跃迁。一旦推理行为变得高频、持续且直接关联账单支出,全量依赖云端在经济层面将日益失衡。单次调用成本微乎其微,但日均数亿次调用累积起来,便是一笔不容忽视的开销。
这种指数级增长的推理需求,正倒逼越来越多计算任务向端边迁移。
中国市场对此反应尤为迅速。大量应用方案商已主动对接芯片厂商,明确提出构建“本地+云端”的混合架构诉求。法律、金融等垂直领域的需求尤为明确——对数据隐私保护与实时响应延迟的要求更高,同时对生产力工具迭代节奏也更为敏感。
相较概念验证,市场更渴求可落地、可量产、可交付的成熟产品。而从芯片企业的视角来看,水温变化正体现于此:适配端边大模型的AI芯片,正快速转化为真实订单流。
一家深圳企业提供了典型案例:他们搭建了一套端云协同的Agent平台,承载多个行业的智能体用于日常运营,并通过动态算法实时决策任务分配——哪些交由本地处理,哪些上传至云端。系统运行一段时间后得出结论:约80%的任务可在本地完成,仅20%需上云;平台还能自动统计客户节省了多少Token费用。
这一比例传递出重要信号:大量智能体的工作流程,完全可由本地算力支撑。无论是终端设备本身,还是性能更强的AI芯片,客户只需一次性投入;而云端的Token账单,则需按用量、按月持续支付。
当经济账清晰可行,迁移便成为必然选择。
成本只是第一重驱动力,延迟则是第二重。端侧推理可实现毫秒级响应,而云端推理则受限于网络波动与传输时延。对于高度依赖实时交互的Agent而言,延迟可能直接导致任务失败。
隐私则是第三重关键因素,推动端边大模型走向舞台中央。随着“数据即资产”的认知日益普及,本地化处理意味着照片、文档、视频等敏感信息始终保留在设备内部——既保障安全,又支持离线使用。
换言之,端边大模型虽可联网获取外部知识,但核心数据与处理能力始终驻留本地,即便断网亦能持续运行。对于诸多需在弱网或无网环境中工作的工业设备与移动终端而言,“安全+离线可用”已成为数字化转型的生命线。
多重变量叠加,揭开了端边大模型价值跃迁的本质:其价值坐标,正从“知识密度”转向“行动密度”。
一个擅长对话的模型,仅靠云端算力与数据即可满足;而一个真正“能做事”的模型,因推理频次与持续性大幅提升,带来了显著的成本压力与安全风险,必须向更安全、更灵活、更可控的端边延伸。因此,端边占比将持续扩大。
未来主流方案中的端云比例究竟几何并不重要,但底层逻辑十分清晰:凡本地推理可胜任的场景,优先采用本地;确有超限需求者,再交由云端协同处理。
与此同时,端边化进程也为硬件端抛出了全新命题:云端芯片比拼的是绝对算力,“一力降十会”,算力即王道;而端边战场的游戏规则已然不同,考验的是另一种能力维度。
面向端边大模型的AI芯片,首要门槛便是破解那个“不可能三角”:能力要求持续攀升——需运行更大参数模型、更快完成推理任务,而功耗却仅有几瓦,成本还需压在几十美元区间。
性能、成本、功耗三者相互制约,放弃任一维度,都将使端边大模型失去实际应用价值。
02. 新终端催生新解法
将这个“不可能三角”推至聚光灯下的,是一批前所未有的终端形态。
过去几年,AI在终端的角色相对轻量。例如为手机添加图像优化功能,或为PC嵌入语音助手,于是“AI PC”这一品类早早问世。芯片厂商的应对策略也较为温和:Intel在Panther Lake中集成少量GPU/NPU,高通则在骁龙平台内置专用NPU,属于对既有PC品类的锦上添花。
但从2025年起,全新设备形态开始涌现。
“它们不像你见过的任何电脑,或许形似鸡蛋、花瓶,甚至路由器。”一位芯片创业者在描述客户样机时如此比喻。
但共性在于:它们并非为人设计,而是专为AI与Agent原生打造的硬件。无需触控屏、键盘,也不必有人坐在前方面向操作,甚至可能没有显示屏,却支持语音与多模态交互,7×24小时不间断运行。其唯一使命,就是赋予AI Agent一个物理化的、长期在线的实体载体。
这类设备正获得一个崭新称谓:Agent Computer。
联想年初在拉斯维加斯Sphere发布全球首款个人超级智能体Qira;英伟达则从DGX Spark一路延伸至RTX Spark。两大巨头的动作指向同一方向:让Agent Computer从概念走向真实硬件品类。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
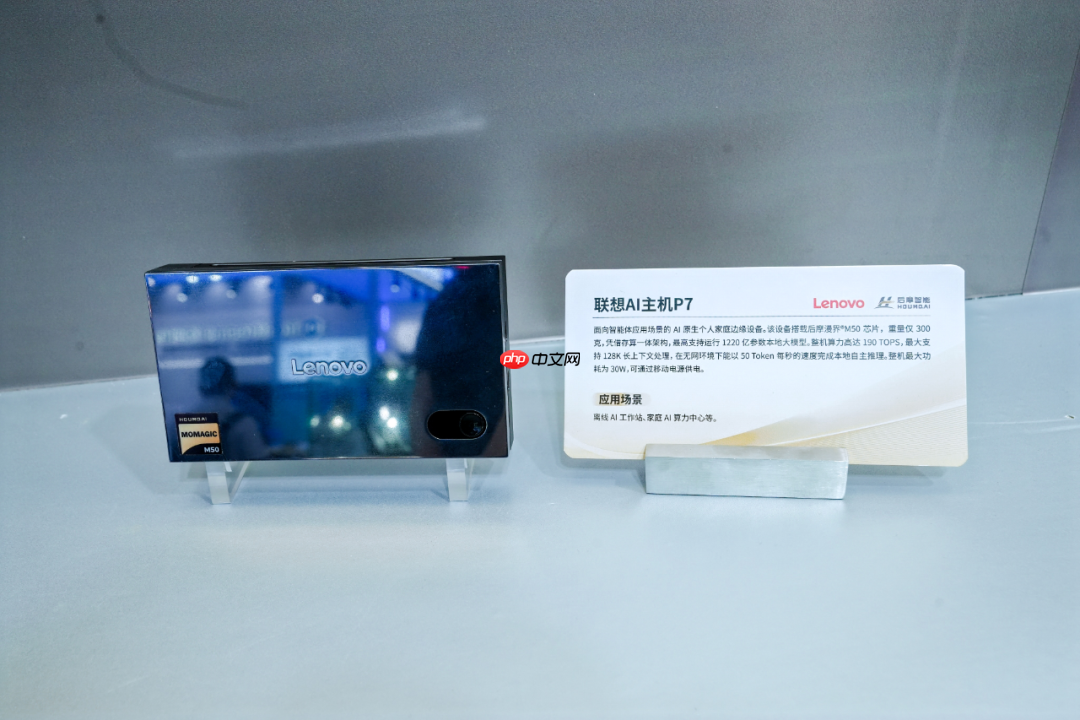
WAIC现场:联想AI主机P7
然而,最终定义该品类主流形态的,或许并非PC厂商或芯片厂商,而是应用场景本身。
仅就通用性较强的家用与企业场景而言,当前明显呈现“两套体系并行”的格局。家庭用户需要中枢型大脑——如置于客厅,调控灯光、记忆对话、照护老人儿童;企业用户则聚焦生产力工具——处理法律文书、数据分析、代码审查等任务。
同一家硬件厂商很难兼顾两类逻辑,同一套芯片架构要同时覆盖两种需求,亦绝非易事。这意味着端边终端市场天然具备高度碎片化特征。
终端形态的变异与碎片化,反过来也重构了AI芯片的设计定义。

一个需长期承载Agent任务的设备,对本地算力的要求远高于以往运行单一本地模型的场景。它需要独立、高性能的NPU,具备大带宽、大容量存储,支持长上下文复杂任务处理。单个任务可能持续半小时以上,中间不能中断。
新终端进一步收紧了“不可能三角”的约束边界。所有AI芯片玩家面对同一道考题——必须将效率推向极致,这点毫无争议;但解题路径正加速分化。
高通与苹果选择SoC延展路线,在现有ARM架构基础上增强NPU模块。优势在于生态成熟,数十亿设备已形成庞大基础,但改良空间存在明显天花板。即便工艺推进至3纳米、2纳米,制程红利递减趋势也无法带来质变突破。
英伟达则沿GPGPU路径向下延伸,算力储备充足,但三十年积淀的CUDA生态既是护城河,也是历史包袱。带着一套为云端训练深度优化的架构下沉至端边,犹如负山而行。
在巨头路径之外,第三条路悄然浮现:存算一体。
存算一体的本质是从芯片架构底层重新设计,打破计算单元与存储单元之间的物理隔离。传统芯片瓶颈在于数据在两者间反复搬运,大量功耗与时间消耗于此;而存算一体则直接在存储单元内执行计算,大幅压缩数据搬运开销。
相比生态延展路径,这条新路前期研发周期更长、试错成本更高,需反复流片验证,攻克量产中无人涉足的技术难题。但其优势在于:效率提升具有结构性本质,理论天花板更高。
敢于押注此路径的厂商并不多,主因在于海外巨头难以割舍既有生态利益。而在敢于进行架构创新的企业中,国产力量反而展现出突出身位。成立于2020年底的后摩智能,正是其中起步较早、路线最为坚定的代表之一。
站在端边大模型与Agent Computer交汇的历史拐点,芯片厂商的起跑线基本一致。不同于手机基带或云端训练芯片领域,海外已领先十年的局面;在端边芯片赛道上,国产厂商并非毫无优势,反而有望凭借量产速度与行业落地效率,抢占先发身位。
03. 端边芯片大战,刚刚鸣枪
端边AI芯片是一条刚刚拉开帷幕的新赛道,而参赛者已在加速入场。
当前格局大致可分为三类:以高通、苹果为代表的SoC巨头,生态完善、出货量庞大,但端边大模型对其仍属增量需求,基因改良决定了能力上限。高通近期推出独立NPU,恰恰印证其自身也意识到集成方案已显乏力。
英伟达依托GPGPU的强大算力势能自云端向下渗透,将1 PetaFLOP级别的AI算力注入消费级设备,火力充沛;但端边严苛的功耗与成本约束,却是英伟达过去三十年极少认真对待的问题,如今却成了真金白银的市场刚需。
第三类则是像后摩智能这样专注端边的新锐力量,短板在于量产经验与生态积累尚浅,但优势同样鲜明——无历史架构包袱,可完全基于终端真实需求重新定义芯片。
显然,最适合创业公司切入的正是第三类路径,其战略抉择尤为值得剖析。
以存算一体切入端边大模型的后摩智能,正是典型“战略决定身位”的案例。创始人吴强早在2023年下半年便作出判断:大模型必将从云端向端边迁移。
彼时,Agent尚未现身,这一判断缺乏明显佐证。大模型主战场仍在云端,国内“六小龙”仍在激烈角逐参数规模与集群能力。存算一体作为架构路线,切入端边大模型,近乎一次“横向破局”。
但吴强敏锐捕捉到两个信号:智谱发布6B模型,Llama推出7B版本,大模型不再专属数百B参数的庞然巨物,小模型亦能实现出色可用效果,在诸多场景中避免“大炮打蚊子”的资源浪费。
团队随即用存算一体架构实测本地大模型,结果令人振奋。既然如此,提前布局端边大模型,对一家以存算一体起家的公司而言,顺理成章。
两年后,这一预判迎来密集验证:2025年DeepSeek R1横空出世,大幅降低端侧部署大模型的技术门槛;2026年Agent集中落地爆发,大批硬件厂商涌入Agent Box、Agent Computer研发浪潮,覆盖ToC、ToB、To家庭等多元场景。而所有硬件厂商面临同一问题:寻找性价比最优、可量产交付的AI芯片。
后摩因提前两年布局,率先吃到第一波红利:当时市场上成熟可用方案稀缺,其战略前瞻性与技术路线优势,迅速转化为真实客户与订单。
产品性能层面,后摩漫界M50采用存算一体架构达成160 TOPS算力,功耗约10瓦,单芯片可稳定运行35B至120B参数模型,广泛适用于AI PC、机器人、边缘推理等场景。半年至一年前,端边芯片尚只能运行7B模型,如今已迈入120B参数时代,彻底刷新端边能力边界。
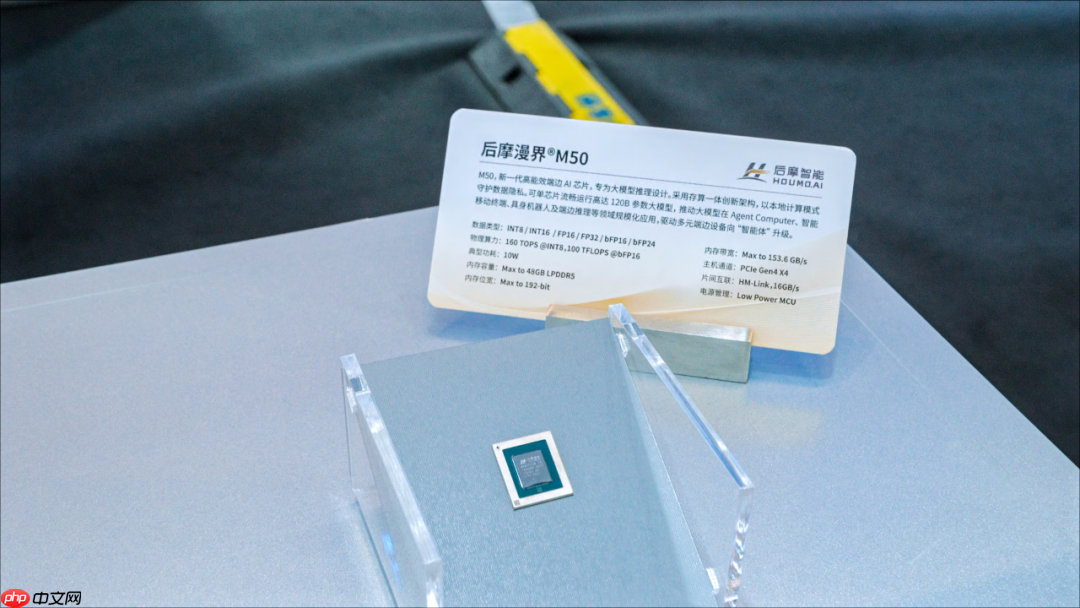
WAIC现场:后摩漫界M50
另一佐证是,后摩漫界M50已进入量产阶段。在AI PC方向,后摩先后进入联想与长城供应链:联想AI主机P7搭载M50全球首发,长城N90 Pro亦以M50为核心打造端侧算力卖点;操作系统层面,M50已完成银河麒麟操作系统V11深度适配;在端边大模型赛道,后摩还与中国移动达成链长级生态合作,客户应用场景正从Agent Computer延伸至具身机器人、端边推理及智能移动终端,量产订单已陆续转化。
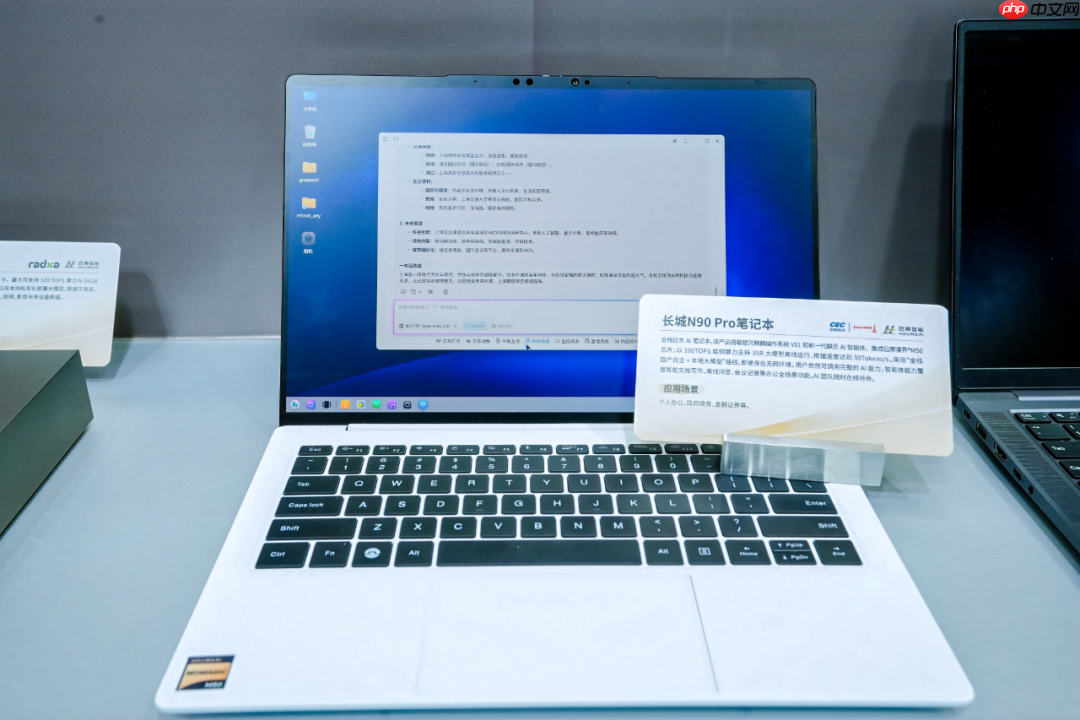
WAIC现场:长城N90 Pro笔记本
尽管从芯片巨头到携新架构入场的初创企业,均已提出各自解法,若将视野拉得更广,端边AI芯片竞争仍处于早期阶段,后续可划分为两个演进层次。
第一阶段聚焦落地实效,比拼的是效率——即谁能在功耗、成本、面积等物理硬约束下,将大模型本地推理能效推至极限。这是实打实的工程能力较量,华而不实的概念包装与长期叙事在此阶段毫无意义。
而长远来看,当效率差异逐渐收窄,第二阶段比拼的将是生态建设与场景适配能力。这又回到英伟达熟悉的主场:考验工具链完整性、主流模型框架兼容度、客户方案快速上线能力。长期而言,仍将拉开显著差距。
在第一阶段,存算一体因从架构底层重构,天然具备效率与功耗的结构性优势,但这一窗口期不会无限延续。值得庆幸的是,国产厂商在此赛道起点与海外持平;以后摩为例,凭借架构独特性与提前卡位,已在国内外具备跻身第一梯队的实力。
不过业内亦清醒认识到,端边大模型尚处向行业价值转化的关键过渡期。AI NAS如何设计?Home Center怎样构建?企业级推理设备应如何定义?多数玩家仍在探索之中,过程中必有起伏,也注定伴随大量掉队者。
2023年,大家仅初识Agent轮廓;至2025、2026年,至少已见具体场景;而从“看见场景”到“规模化落地”,仍有一段不短的距离需跨越。
未来两年,端边场景中必将诞生Killer App,孵化出真正适配大模型原生逻辑的应用形态。生产力工具、更智能的家庭设备与情感陪伴类产品或率先闭环;面向大众的普惠型应用则将是下一阶段重点。
但正如移动互联网时代催生了美团、滴滴与抖音,今天我们其实难以准确预判——未来真正改变人类生活方式乃至就业结构的主流应用,究竟会以何种面貌出现,其经济价值又将以怎样的方式滚动放大。
在这场竞赛中,芯片是底层基础设施。率先落地、率先跑通的算力底座,才能赢得下一阶段的入场资格。













