





nvidia 最近正式推出 nemotron3embed 系列嵌入模型,专为实际生产环境中的 rag 应用、智能文档检索、代码搜索以及智能体长期记忆等任务量身打造。其中,8b 规模版本在权威检索嵌入评测基准 rteb 中综合排名第一,是目前开源领域性能最强的嵌入模型。
该系列共提供三个开放权重模型:Nemotron-3-Embed-8B-BF16(侧重高精度)、Nemotron-3-Embed-1B-BF16(轻量级部署友好型)以及 Nemotron-3-Embed-1B-NVFP4(专为 Blackwell 架构优化的 4-bit 量化版本)。三者均基于双向注意力掩码训练的 Transformer 编码器架构,最大上下文长度统一为 32,768 tokens,原生支持 34 种语言,并以 OpenMDW-1.1 开源协议发布。特别说明的是,所有模型均继承自 Mistral 架构:8B 版本源自 Ministral-3-8B-Instruct-2512;两个 1B 变体则基于 Ministral-3-3B-Instruct-2512 进行深度适配。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
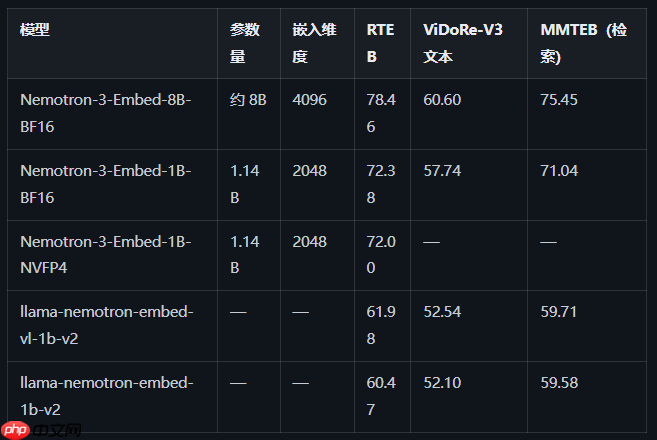
在 RTEB 基准涵盖的 16 项公开检索任务中,8B-BF16 模型以平均 NDCG@10 得分 78.46 高居榜首。1B-BF16 版本得分为 72.38,较前代基线模型 llama-nemotron-embed-vl-1b-v2 提升达 10.4 分。而经过 Blackwell 架构专项优化的 1B-NVFP4 版本仅比 BF16 版本低 0.38 分,精度保留率达 99.5%,同时在 Blackwell 平台上推理吞吐量提升至 BF16 的 2 倍。
1B 规模模型并非从零训练,而是通过模型压缩路径构建:研发团队首先借助 NVIDIA ModelOpt 的神经架构搜索技术将 3B 基础模型剪枝至 2B,随后以微调完成的 8B 嵌入教师模型为指导,结合余弦距离损失与均方误差损失开展知识蒸馏,最终迭代收敛至约 1.14B 参数量。NVFP4 版本则在此基础上进一步实施量化感知蒸馏——使用 512 个样本完成校准,2 万个样本参与训练,在长文本输入场景下有效恢复了量化带来的精度损失。

通过 NVIDIA NIM API 调用 Kimi K2.5 视觉模型分析图像,非常适合为 MiniMax M2.5、GLM-5 等非视觉模型赋予视觉能力。
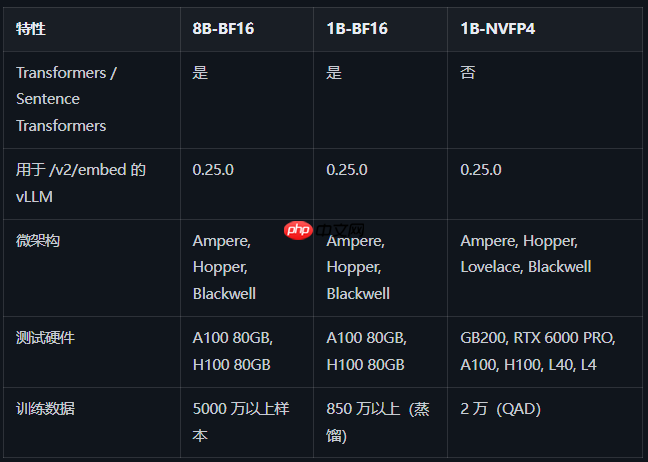
部署兼容性方面,各版本存在差异:8B 与 1B 的 BF16 版本全面支持 Transformers 和 Sentence Transformers 框架;而 1B-NVFP4 仅适配 vLLM 0.25.0 的 /v2/embed API 接口。硬件支持层面,NVFP4 版本可运行于 Ampere、Hopper、Lovelace 及 Blackwell 全系列 GPU;BF16 版本主要面向 Ampere、Hopper 和 Blackwell 架构。此外,NVIDIA 还同步发布了针对 1B 模型定制优化的 NIM 微服务(基于 Rust 实现),在 GB200 和 RTX PRO6000 平台上实测性能达到甚至超越标准 vLLM 检查点表现。
在应用实践中,该系列模型广泛适用于多语种企业级搜索(支持跨语言语义匹配)、代码检索(训练数据融合 SWE-bench 等专业代码语料)及智能体记忆管理(依托 32K token 上下文能力实现长对话摘要嵌入)。针对资源受限场景,推荐采用“1B-NVFP4 负责大规模初筛召回 + 8B 精确处理疑难查询”的分层 RAG 架构策略。
NVIDIA 同步开源完整示例代码,覆盖 Sentence Transformers 本地推理与 vLLM 服务端部署两种主流方式。输入文本需明确标注前缀:查询使用 query:,文档段落使用 passage:;生成的嵌入向量经 L2 归一化后,直接计算点积即可等效于余弦相似度。














